
Visual Latents Know More Than They Say:唤醒 MLLM 中被抑制的潜空间推理能力
Visual Latents Know More Than They Say: Unsilencing Latent Reasoning in MLLMs
本文提出了针对多模态大模型(MLLM)的推断期潜在推理框架,通过解决“Silenced Visual Latents”现象,无需更新主干网络参数即可提升推理能力。该方法由查询引导的对比潜空间对齐(Stage I)和奖励驱动的连续推理强化(Stage II)组成,在多个 SOTA 后端模型上实现了显著的视觉推理性能提升。
TL;DR
在多模态推理中,我们习惯让模型一边学习视觉潜变量(Latent),一边预测答案。但本文揭示了一个扎心的事实:由于大模型太“聪明”,它在训练中学会了绕过复杂的潜变量推理,直接从原始视觉输入中通过快捷路径寻找答案,导致昂贵的潜变量被“静默”(Silenced)。本文提出了一种无需微调参数、仅在推断期通过对比热身和奖励强化来唤醒这些潜变量的方法,在 IQ 测试和数学推理等硬核任务上刷新了纪录。
痛点深挖:被“静默”的视觉潜变量
目前的多模态模型(MLLM)通常将中间推理过程从离散的文本 Token 转移到连续的潜空间(Latent Space),以获得更高的表征带宽。然而,作者通过实验发现,虽然潜变量在训练中变得越来越能代表视觉特征,但模型的最终准确率却并未随之稳步提升。
本质原因(Insight):在共享参数空间的训练中,自回归预测的损失函数(Loss)倾向于选择“阻力最小”的路径。比起通过深层的潜变量转换,直接从原始 Visual Input 中提取特征更简单,导致潜变量在优化过程中变成了类似于“分隔符”的无效 Token。
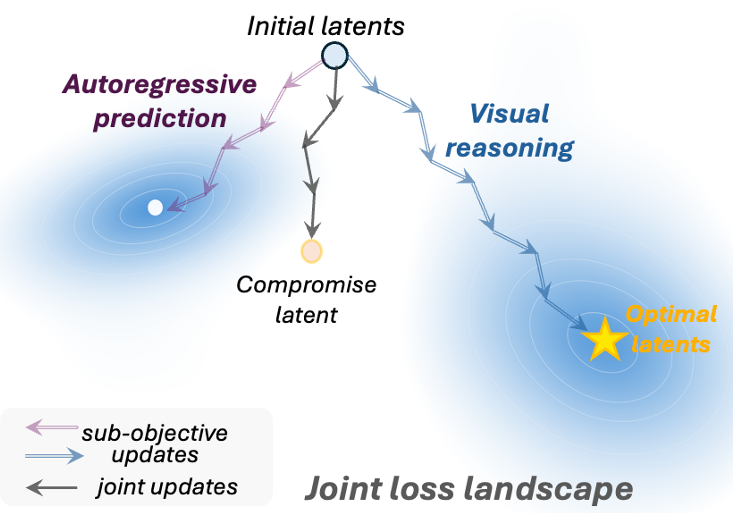 图 1:联合优化蓝图——左侧的自回归目标与右侧的视觉推理目标存在冲突,潜变量被迫处于中庸的静默状态。
核心方法:两阶段解耦优化
为了打破这种僵局,本文提出了在推断阶段(Inference-time)独立优化潜变量的方案,而保持模型主干(Backbone)冻结。
Stage I:查询引导的对比预热 (Visual Latent Warm-up)
作者认为潜变量不应该只是视觉特征的堆砌,而应该是关联问题的。
- 对比学习:利用 Attention 图提取与 Query 相关性最高的视觉块作为正样本,无关块作为负样本。
- 块状分配:为了防止多个潜变量 Token 退化(Collapse)成同一个特征,模型将视觉块划分为不重叠的小组,强迫每个潜变量 Token 关注不同的视觉细节。
Stage II:置信度递进奖励强化 (Latent-to-Answer Reinforcement)
即便潜变量有了语义,模型如果不去“读”它也是徒劳。
- 逻辑链条直觉:正如人类推理越来越清晰,潜变量序列末端的 Token 预测分布应该比前端更集中(更确信)。
- 奖励设计:引入
Confidence-progression Reward,通过 NES 梯度估计器调整潜变量,使得 Top-δ 熵呈现下降趋势,强迫模型预测必须穿过(Route through)潜变量链条。
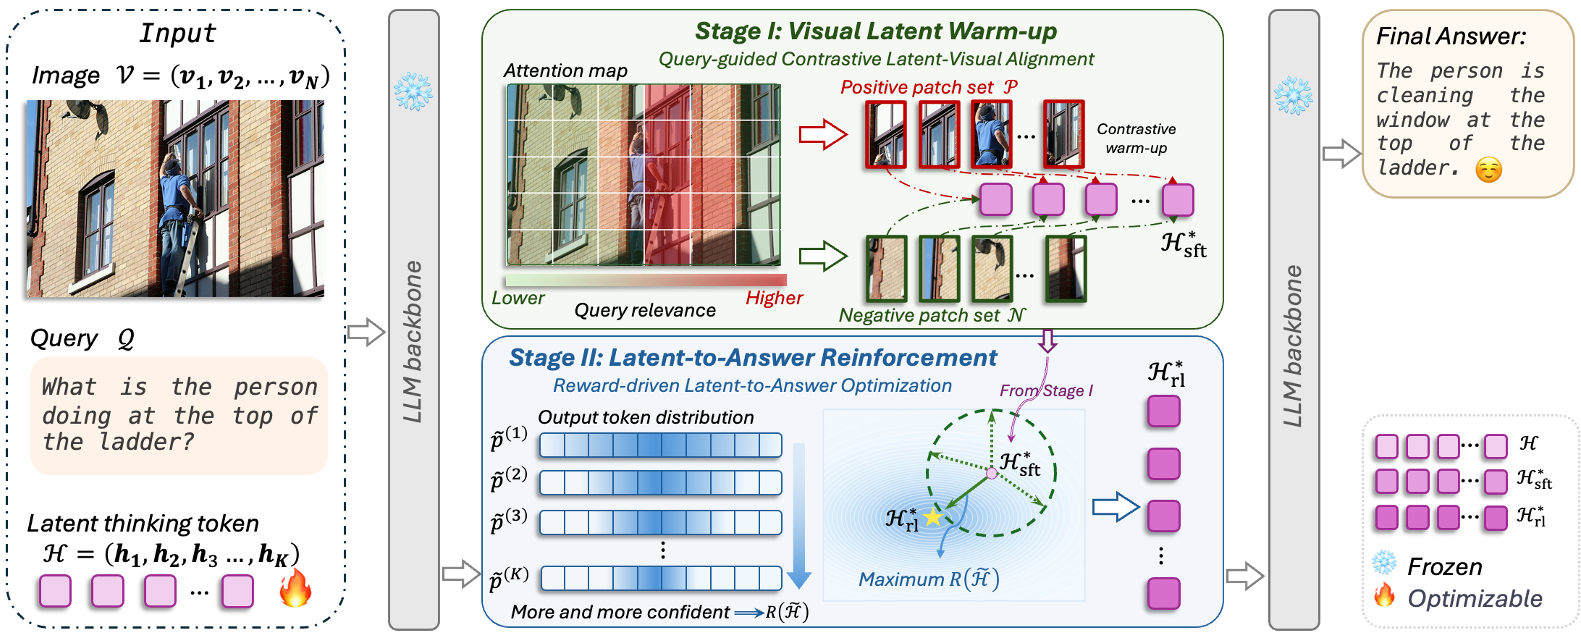 图 2:框架总览——从 Stage I 的语义对齐到 Stage II 的利用率强化。
实验战绩与 SOTA 对比
在 Qwen2.5-VL 等最强底座上的实验表明,该方法在需要精细观察的视觉任务上表现极佳:
- 感知能力:在 Count(计数)和 IQTest(图形逻辑)上,性能提升分别达 +3.33% 和 +8.66%。
- 模型通用性:在不同尺寸(3B, 7B)以及不同架构(R1-OneVision)上均展现出了稳健的泛化能力。
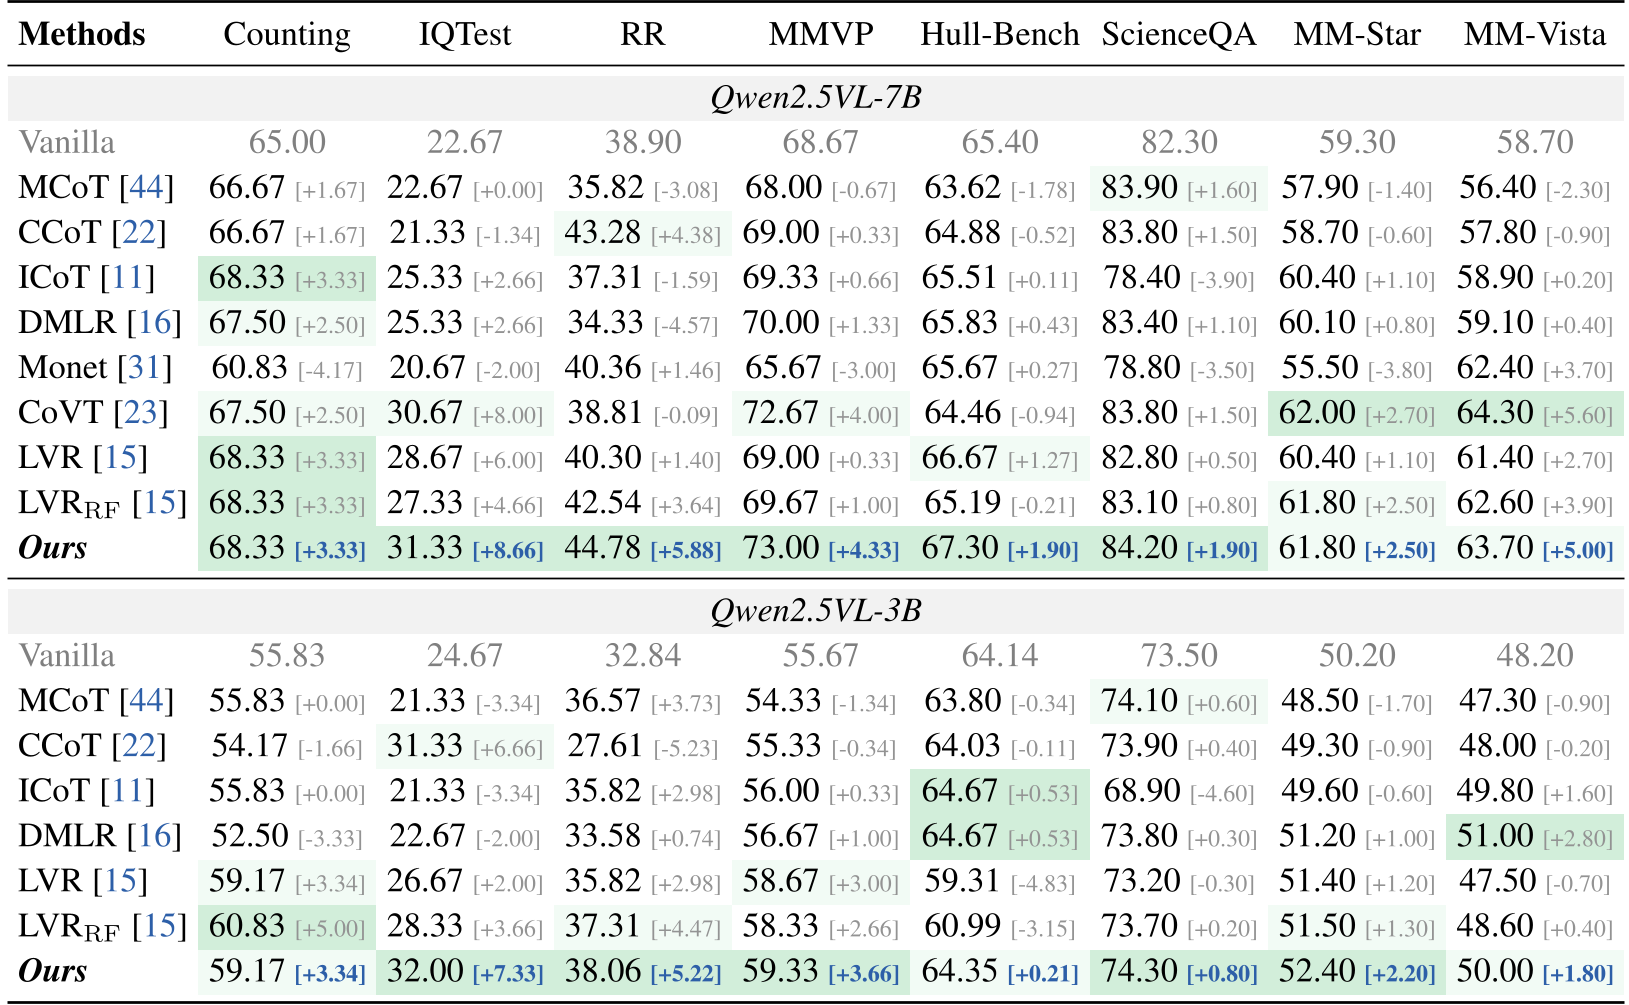 表 1:在多项 Benchmark 上的量化对比。
深度洞察:为什么这种方法更高效?
相较于通过文本 CoT 增加数以百计的 Token 长度,本文仅使用极短的潜变量(如 K=4)就达到了更优的推理效果。计算得出的 Efficiency Ratio 显示,该方法在单位 Token 带来的性能收益上远超传统的文本推理和现有的潜空间方法。
总结与未来展望
核心贡献:
- 首次界定了 Silenced Visual Latents 这一优化病理。
- 证明了通过纯数学优化方式(无梯度反传至模型)即可解锁闭源/冻结模型的推理潜力。
局限性: 每单次推理都需要额外的计算步骤来进行潜变量优化,这在实时响应场景中存在成本权衡。未来如何将这种推断期的增益低成本地“蒸馏”回模型参数中,将是极具价值的研究方向。