
VLA Foundry:打破孤岛,构建统一的具身智能训练基石
VLA Foundry: A Unified Framework for Training Vision-Language-Action Models
本文推出了 VLA Foundry,这是一个由丰田研究院(TRI)开发的统一开源框架,支持大语言模型(LLM)、视觉语言模型(VLM)及视觉语言动作模型(VLA)的全流程训练。通过引入 Foundry-Qwen3VLA-2.1B 等系列模型,该框架在 LBM Eval 机器人基准测试中实现了显著的性能提升,其中基于 Qwen3-VL 的模型比之前的 SOTA 基线高出 20% 以上的成功率。
TL;DR
机器人基础模型(Robotics Foundation Models)的进化正在加速,但工具链的碎片化始终是研究者的痛点。丰田研究院(TRI)开源了 VLA Foundry,这是首个将 LLM(语言)、VLM(视觉语言)和 VLA(动作)训练完全打通的开源框架。它不仅支持从零预训练,还兼容 Hugging Face 上的 SOTA 权重,将机器人策略的训练从单纯的“下游微调”提升到了“全生命周期优化”的高度。
背景定位:从“缝合怪”走向“大一统”
在过去,训练一个 VLA 模型往往像是在玩“拼图”:从 A 处借一个 LLM,在 B 处找一个视觉编码器,然后在 C 处用机器人数据做微调。这种碎片化的方法(Stepwise training)隐藏了一个严重问题——预训练阶段的决策(如数据配比、Tokenizer 选择)会不可逆地影响机器人在物理世界中的表现。
VLA Foundry 的出现,标志着机器人研究正从“算法驱动”向“基础设施驱动”转型。它不再只是一个模型,而是一个能够通过单一行命令或 YAML 配置文件,就能控制从 1T Token 语料预训练到复杂双臂操作 fine-tuning 的工业级生产线。
痛点深挖:为什么我们需要全栈受控?
- 数据极速衰减:语言数据以 Trillion 计,而高质量机器人交互数据却极度匮乏。VLA Foundry 允许研究者进行多模态概率混合(Probabilistic mixing),让模型在学习“抓取”的同时不丢失“推理”能力。
- 工程瓶颈:大规模分布式训练(如 FSDP2)在机器人领域一直难以普及。VLA Foundry 封装了高效的并行技术,支持在 128 个 H100 GPU 上顺畅运行。
- 盲目对齐:许多框架将 VLM 视为黑盒,而 VLA Foundry 证明了,仅仅更换一个更强的网络主干(如从 1.7B 升级到 Qwen3-VL 主干),就能直接带来 20% 以上的成功率提升。
核心方法论:VLA Foundry 架构解析
VLA Foundry 的核心在于其模块化与可组合性(Modularity & Composability)。
1. 统一的训练管道
框架设计了一个模型无关(Model-agnostic)的训练循环。无论是在训练 LLM 理解语法,还是在让 VLA 学习 Flow-matching 动作,底层的批处理(Batching)和损失构建逻辑都是一致的。
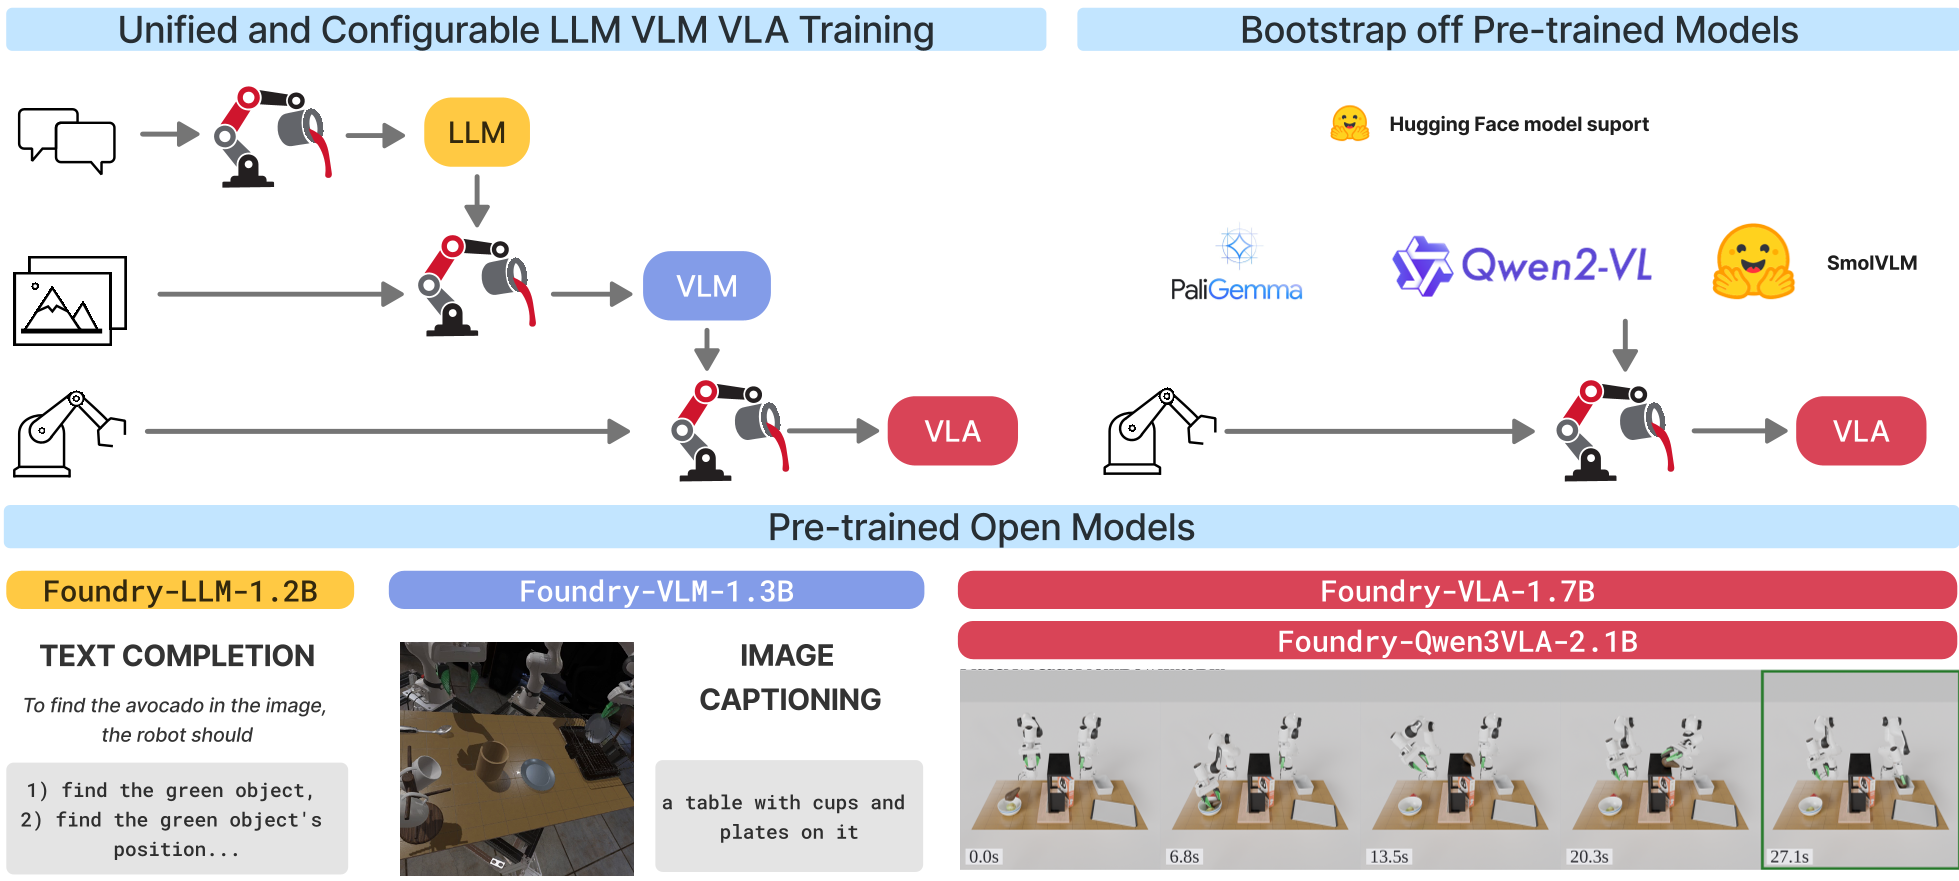 图 1:VLA Foundry 架构总览。展示了从 LLM 到 VLM 再到 VLA 的三个阶段及其数据/权重的继承关系。
2. 精密的机器人数据处理
机器人动作的归一化(Normalization)是决定策略稳定性的关键。VLA Foundry 引入了 RoboticsNormalizer,支持基于百分位数(Percentile)和 T-digest 的合并统计,有效解决了多数据集训练中的离群值问题。
3. 先进的动作头(Action Head)
论文采用了 Flow Transformer 作为动作生成器。不同于传统的扩散模型(Diffusion Policy),Flow-matching 在推理速度和采样质量上展现了更好的平衡。
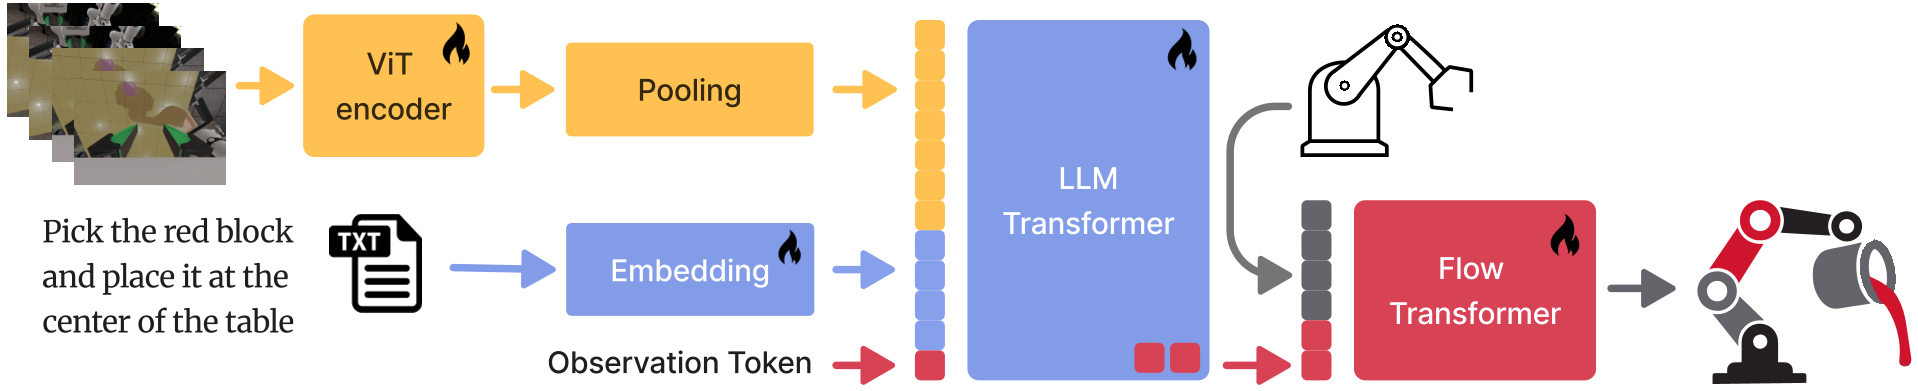 图 2:具体模型架构。图像通过 ViT 编码后,联同任务指令和观察 Token 输入 LLM,最后由 Flow Transformer 预测动作轨迹。
实验与战绩:Qwen3-VL 的降维打击
研究团队通过 VLA Foundry 训练并对比了多个模型。最引人注目的是 Foundry-Qwen3VLA-2.1B-MT。
- SOTA 性能:在 LBM Eval 这一极具挑战性的双臂协调操作基准测试中,该模型在 16 个任务上大幅超越了之前的基线(LBM)。
- 跨域迁移:实验发现,在模拟环境下进行多任务预训练,然后再针对特定任务进行微调(Fine-tuning),能够获得最优的成功率平衡。
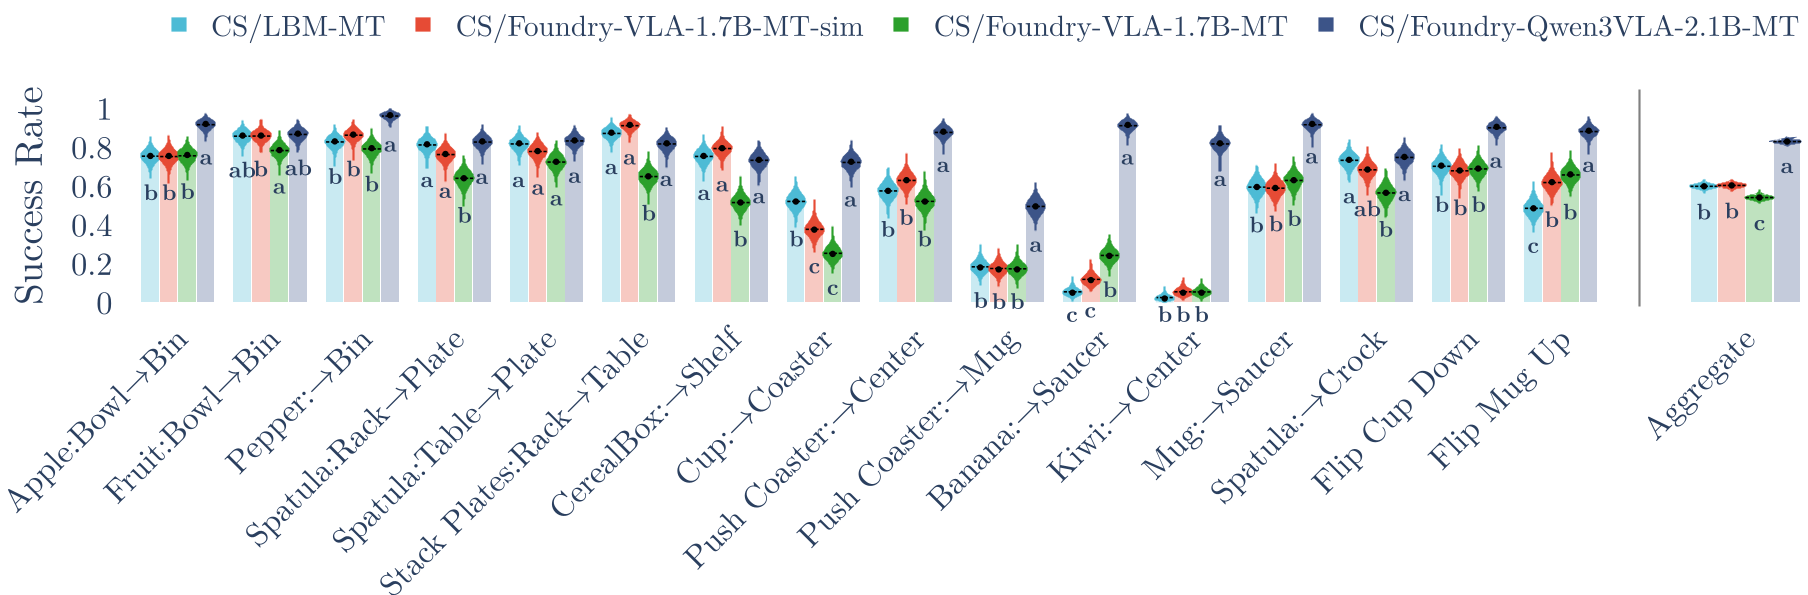 图 3:性能对比。图中清晰显示,基于 Qwen3 的模型(最右)性能远超传统的 LBM-MT 和从零训练的 1.7B 模型。
深度洞察:机器人研究的未来在“主干”
VLA Foundry 给行业带来的最大启发是:VLA 的上限实际上是由其 VLM 背景(Backbone)决定的。
虽然团队展示了从零训练 LLM 到 VLA 的全过程,但在实际应用中,利用如 Qwen3-VL 这种经过海量互联网数据洗礼的预训练模型作为起点,能让机器人策略具备更强的泛化能力。框架的开源不仅提供了模型,更重要是提供了一套“可重复性(Reproducibility)”的科学评价体系——通过集成的 STEP 工具进行贝叶斯统计分析,研究者可以准确判断一个策略的提升到底是真实存在的,还是随机扰动。
总结与致敬
VLA Foundry 的开源不仅是丰田研究院对社区的回馈,更是对具身智能研究规范的一次重塑。它告诉我们,机器人策略不应是孤立的黑盒算法,而应是通用 AI 拼图中最具动感的一块。
项目地址: https://github.com/TRI-ML/vla_foundry
注:本文基于 VLA Foundry 技术报告重构。文中保留了 FSDP2, SOTA, WebDataset, Flow-matching 等技术术语以确保专业性。