
VOFA:让双足机器人像人一样推重物,力自适应与视觉闭环的完美融合
VOFA: Visual Object Goal Pushing with Force-Adaptive Control for Humanoids
本文提出了 VOFA,一个面向人形机器人的视觉导向目标推物系统。该系统结合了高层全景深度视觉策略与底层力自适应全身控制器(WBC),在无需预知物体物理参数的情况下,实现了复杂环境下的闭环目标导向推物任务。
TL;DR
在仓库搬运等场景中,让高度不稳的人形机器人推行重物是一项极具挑战的任务。德克萨斯大学奥斯汀分校的研究团队提出 VOFA,通过两层分层架构,使人形机器人能够依靠自带的深度视觉,将未知质量(最高达自身体重 50% 以上)的物体精准推向任意目标位置,并具备极强的抗扰动和在线规划能力。
痛点深挖:为什么“推重物”对人形机器人这么难?
现有的机器人操控研究大多集中在抓取(Prehensile Manipulation),而对于推行(Pushing)这类非抓取任务,存在几个核心挑战:
- 动力学不确定性:物体的质量中心(CoM)、地面摩擦力通常不可知。
- 感知局限:单纯依靠车载摄像头(Egocentric Perception)会有视野丢失和深度噪声问题。
- 策略短视:如果简单的给机器人一个“靠近物体”的奖励,它会迫不及待地贴上去,结果反而挡住了推向目标的路径。
核心方法论:分层治理,力觉与视觉双修
VOFA 系统由两个核心层级组成,通过解耦复杂度来提升鲁棒性。
1. 底层:力自适应全身控制 (Force-Adaptive WBC)
底层控制器基于 FALCON 框架。它的直觉是:不需要提前知道物体多重,而是通过在训练中加入大量的端执行器(End-effector)扰动,让机器人学会一种“以不变应万变”的姿态控制。当推行重物产生巨大的反作用力时,WBC 会通过全身协同来维持平衡,避免“踢”物体或滑倒。
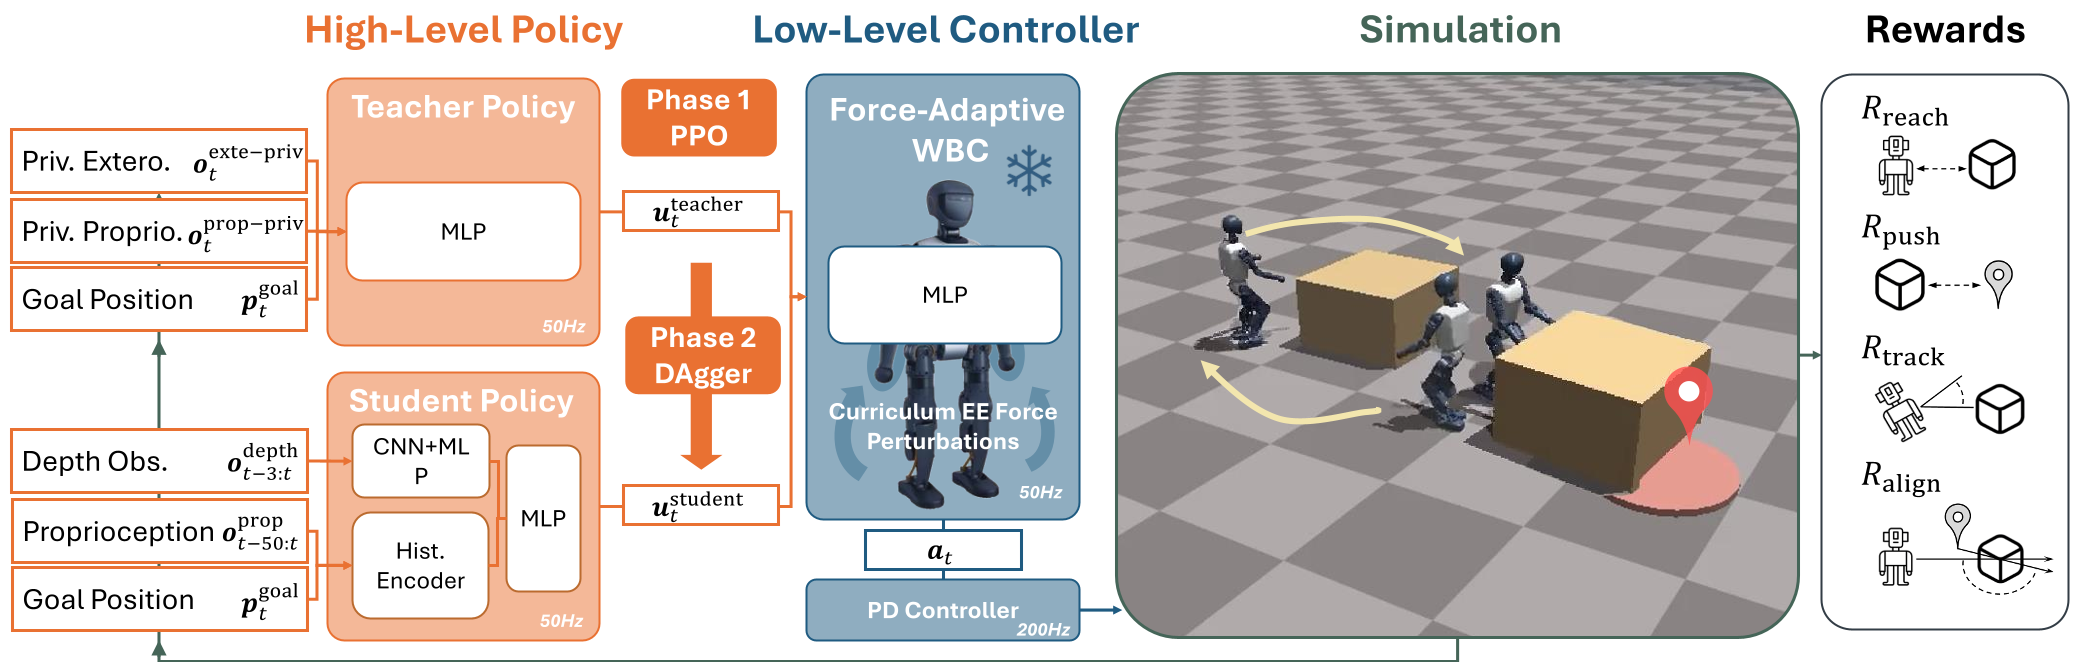 图 2:VOFA 的分层设计:高层视觉策略输出运动命令,底层力自适应控制器执行关节动作。
2. 高层:基于蒸馏的视觉策略
研究者采用了 Teacher-Student 训练范式:
- 教师策略:拥有“上帝视角”,能接触到物体质量、精确速度等特权信息。
- 学生策略:仅使用车载摄像头深度图和自身本体感知。通过 DAgger 算法,学生不断模仿教师在高难度配置下的决策。
- 对准奖励 (Alignment Reward):这是 VOFA 成功的关键秘诀。它引入了一个奖励项,迫使机器人在接触物体前,先绕行到物体相对于目标点的“正后方”,实现了从“盲目推”到“有目的推”的转变。
实验战绩:突破载荷极限
VOFA 在 Booster T1 人形机器人上进行了部署。最令人赞叹的实验是,机器人在没有训练过超大质量的情况下,成功推行了 17kg 的纸箱。考虑到机器人自重仅约 30kg 左右,这相当于一个成年人推着一辆轿车前进。
 表 1 & 2:实验数据显示,带有力自适应 (w/ FA) 的 VOFA 在各项任务(侧向、后方目标)中的成功率远超基准模型。
此外,VOFA 展示了极强的闭环修正能力:
- 抗干扰:在推行过程中,实验人员推开纸箱,机器人能立刻停下寻找物体,重新对准并继续任务。
- 质心偏置:即使物体一侧被加重,导致推行轨迹偏移,机器人也能通过视觉反馈自行调整接触点。
深度洞察与总结
VOFA 的成功揭示了人形机器人操控的一个重要趋势:不要试图在神经网络里解决所有物理建模问题。 通过底层控制器(WBC)处理物理层面的力学鲁棒性,让高层神经网络专注于语义层面的“位置对准”和“视觉导航”,这种解耦极大地降低了 Sim-to-Real 的迁移难度。
局限性:目前 VOFA 还需要外部提供目标位置的相对坐标,未来如果能结合视觉语言模型(VLM)直接从“把箱子推到饮水机旁”这种自然语言指令中提取目标,将更具实用价值。
Takeaway: VOFA 是一次典型的“分治思想”在机器人学中的胜利,它为人形机器人在非结构化负载任务中提供了可靠的工程范式。