
Voxtral TTS:混合流匹配架构下的零样本语音克隆新标杆
Voxtral TTS
本文推出了 Voxtral TTS,这是一个集成 4B 参数规模的高保真多语言文本转语音模型。该模型采用了一种独特的混合架构:由 Auto-regressive (AR) 解码器生成语义 Token,辅以 Flow-matching (FM) 变换器生成声学 Token,在零样本(Zero-shot)语音克隆任务中表现卓越,人类偏好率显著超越 ElevenLabs Flash v2.5。
TL;DR
Mistral AI 团队最近发布的 Voxtral TTS 是一款令人瞩目的开源多语言 TTS 模型。它仅需 3 秒参考音频即可实现高保真的零样本语音克隆。其核心创新在于放弃了全自回归(AR)的声学生成方案,转而采用 AR 生成语义 Token + Flow-matching (FM) 生成声学 Token 的混合架构。在 24kHz 的音频采样率下,该模型不仅在多语言表现力上超过了 ElevenLabs 等闭源 SOTA,更通过 vLLM-Omni 框架实现了极速的流式推理。
痛点深挖:为什么表现力 TTS 这么难?
传统的 TTS 模型(如 VALL-E 或最近的层级编解码模型)通常面临两个瓶颈:
- 架构瓶颈:声学 Token 如果完全依赖自回归预测,序列长度会呈爆炸式增长,推理变慢且容易产生采样漂移,导致语音丧失自然感。
- 表征瓶颈:现有的 Codec(如 EnCodec, Mimi)提取的“语义片段”往往偏向于简单的音素,缺乏对上下文语义的深层次理解。
Voxtral 的作者认为,我们需要在保持长文本一致性的同时,用更“平滑”的手段(即连续的流匹配)来捕捉声学中的细微表现。
核心方法论:Voxtral 的黑科技拆解
1. Voxtral Codec:基于 ASR 蒸馏的编解码器
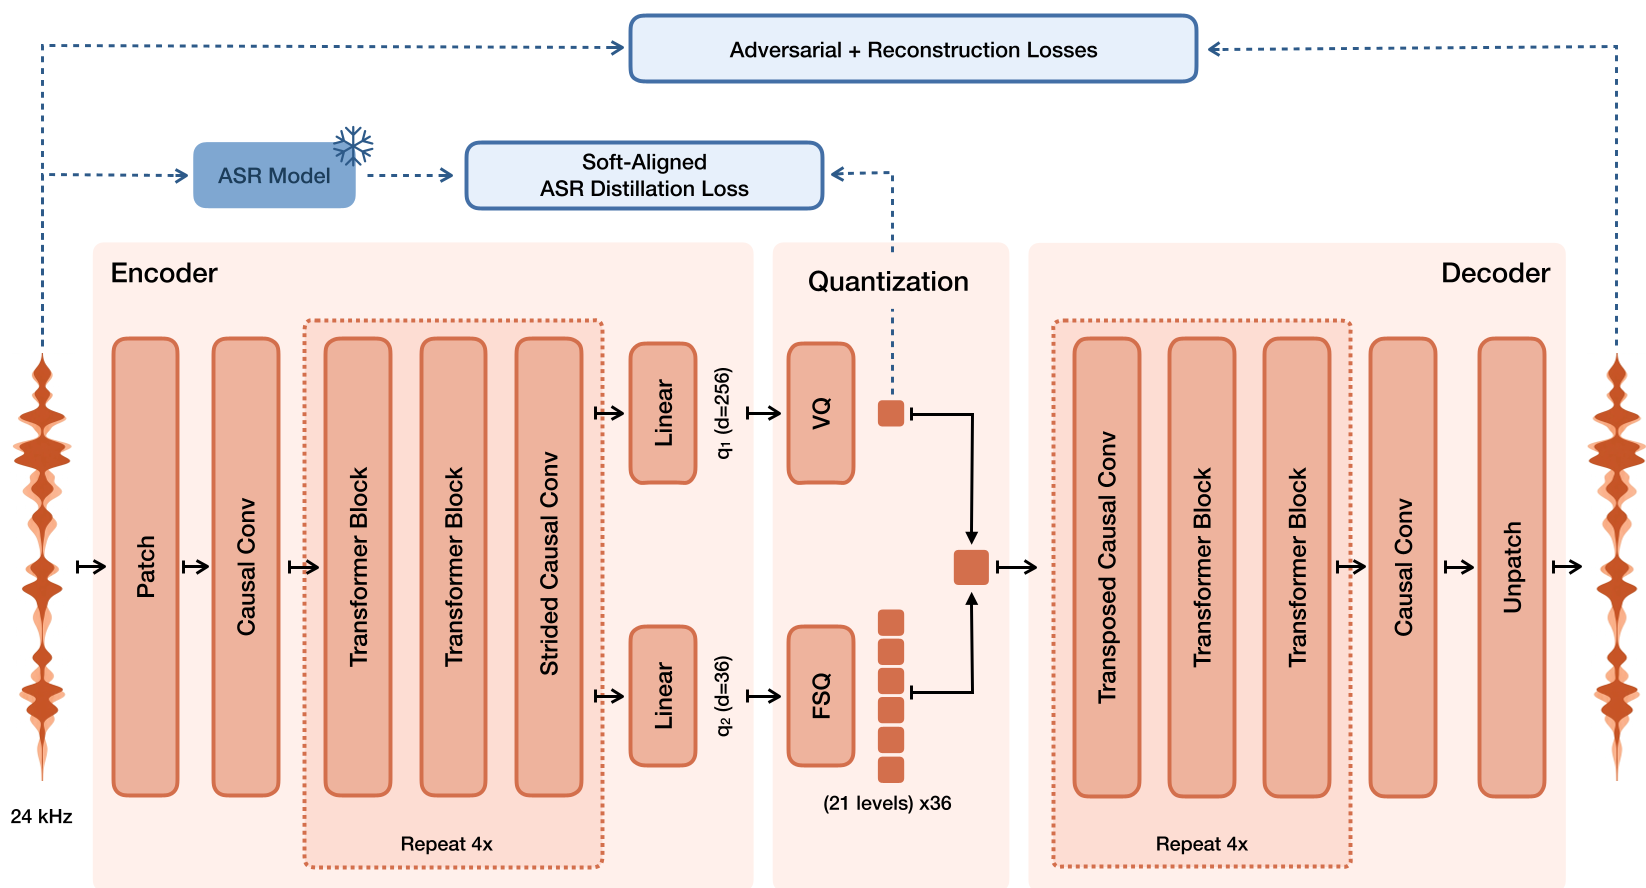
Voxtral 重新设计了 Codec 架构,将语音压缩为每秒 12.5 帧的离散 Token 流。最关键的是其混合量化方案(VQ + FSQ):
- 语义 Token (VQ):通过从冻结的 Whisper 模型中蒸馏隐藏状态来获得,利用交叉注意力权重进行动态时间规整(DTW)对齐,确保 Token 真正理解“说了什么”。
- 声学 Token (FSQ):使用有限标量量化处理 36 个维度的声学细节。
2. 混合生成模型:AR + FM
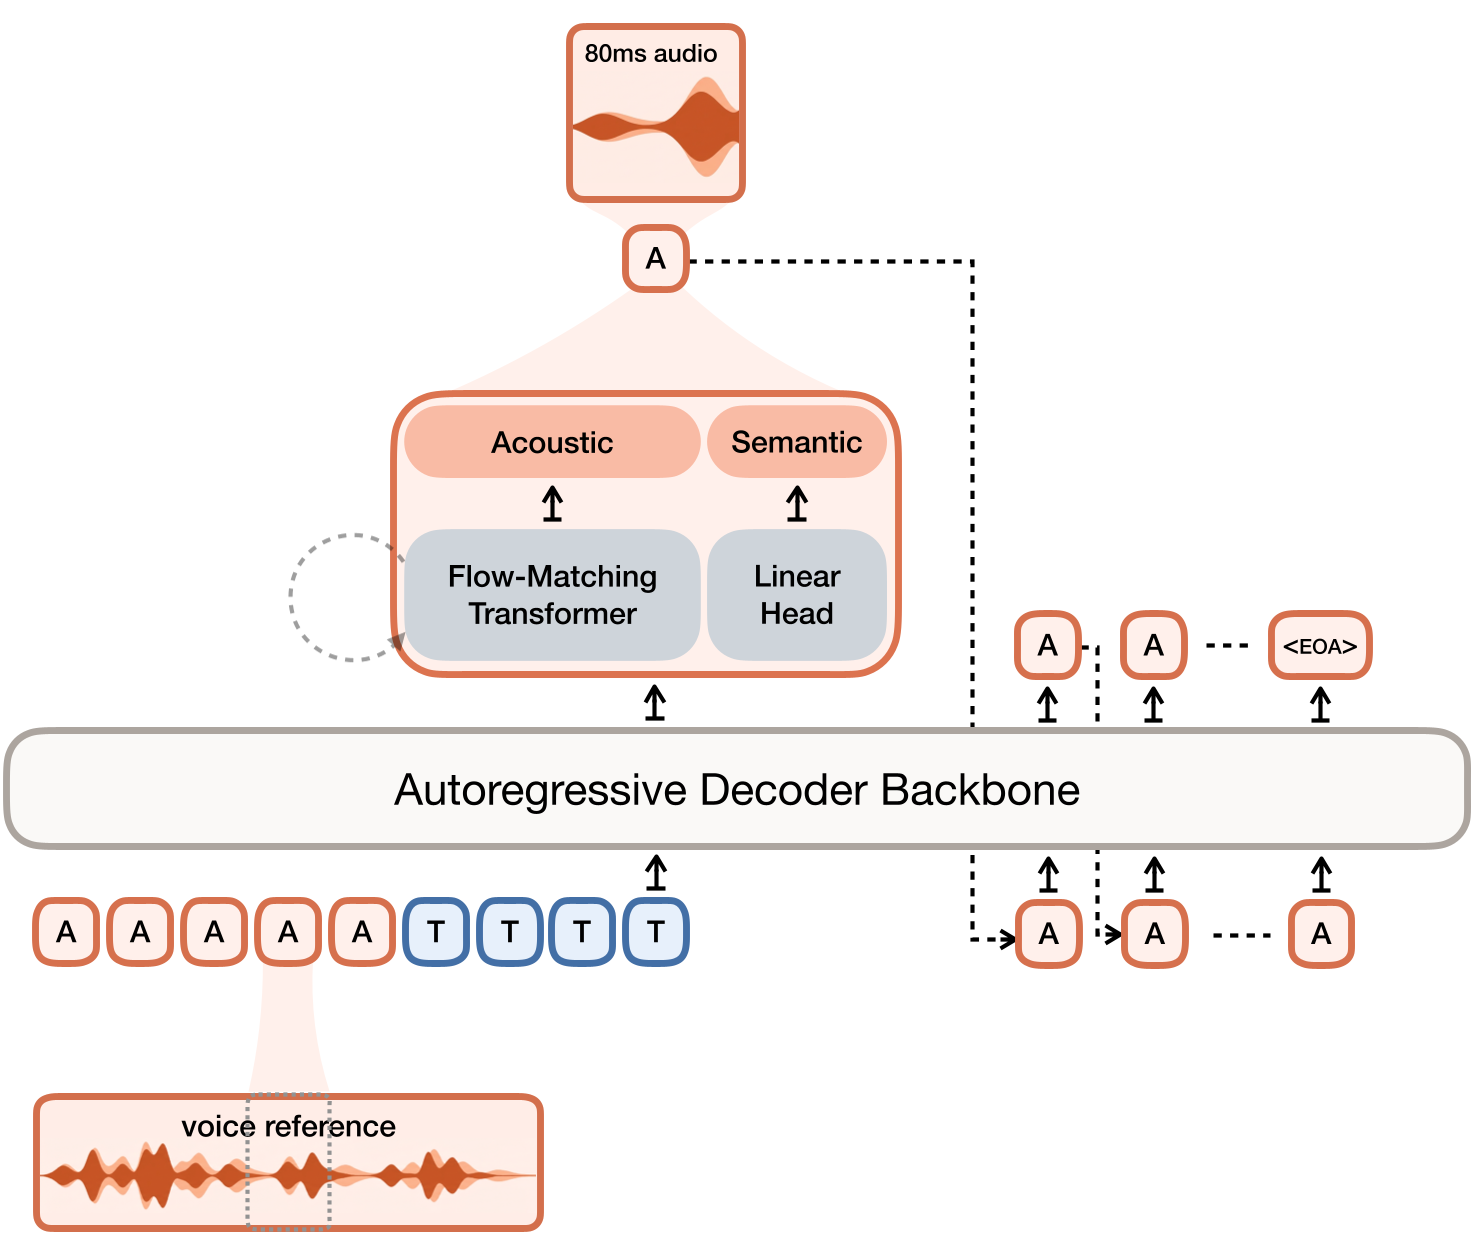
模型采用 Ministral 3B 作为 Backbone,其推理过程分为两步:
- 语义解码:主干网络以 AR 方式生成语义 Token。
- 声学细化:一个轻量级的流匹配 Transformer(Flow-matching Transformer)根据主干网络的隐藏状态,在短短 8 步 NFEs(Function Evaluations)内从高斯噪声中“还原”出声学 Token。
3. DPO 后训练:让声音更有灵魂
作者将 LLM 领域大火的 DPO(直接偏好优化)引入了进来。特别针对流匹配模型设计了 Flow-DPO 损失函数,通过对比“更像人”和“较生硬”的音频样本,模型学会了减少幻听并改善音量逐渐变小(Tapering)的问题。
实验与结果:全方位吊打基线?
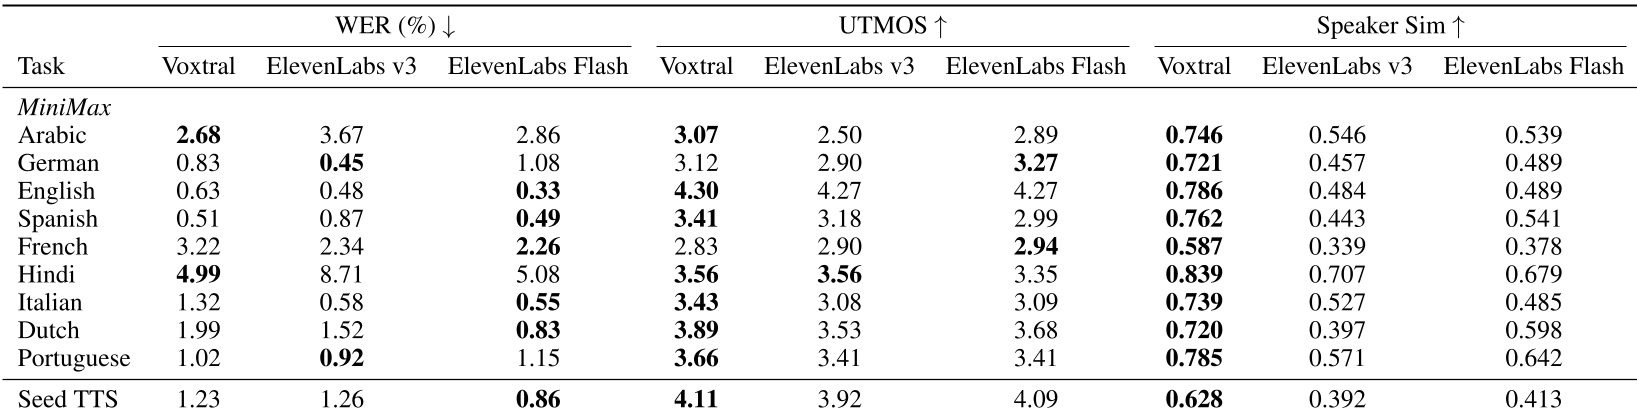
在与 ElevenLabs v3 和 Flash v2.5 的客观对比中,Voxtral 在 Speaker Similarity(音色相似度) 上展现出了绝对优势。在阿拉伯语、德语、西班牙语等多个语种下,相似度指标遥遥领先。
在主观感知的人类偏好评估(Human Evaluation)中,Voxtral 在语音克隆任务上的整体胜率达到了 68.4%。特别是在低资源语言(如印地语和阿拉伯语)中,其优势更为夸张。
深度洞察:系统级的工程优化
除了模型架构,Voxtral 的推理效率同样令人印象深刻。通过 vLLM-Omni 框架:
- CUDA Graph 加速:消除了 Python 层面的调度开销,使延迟缩短了近一半。
- 异步块流式处理:在 AR 阶段生成部分内容时,Codec 解码器就已经开始合成波形,实现了“首词即出”的极低首包延迟。
| 配置 | 延迟 | RTF (Real-Time Factor) |
|---|---|---|
| Eager Mode | 133 ms | 0.258 |
| CUDA Graph | 70 ms | 0.103 |
总结与展望
Voxtral TTS 的成功证明了**混合架构(离散预测+连续流细化)**在处理高维度音频数据时的优越性。它避开了全自回归模型在处理长声学序列时的低效,也补足了纯扩散模型在长文本语义连贯性上的短板。
局限性:尽管其表现力惊人,但在极端复杂的跨语种(Code-switching)任务和超长音频生成稳定性方面,仍有待进一步的大规模场景验证。
随着模型权重的开源(CC BY-NC),Voxtral 可能会像其文本模型(Mistral)一样,成为开源 TTS 社区的新一代基石模型。