
WavCube:打破语音“理解”与“生成”的表征藩篱
WavCube: Unifying Speech Representation for Understanding and Generation via Semantic-Acoustic Joint Modeling
本文提出了 WavCube,一种紧凑的 128 维连续语音表示,旨在统一语音理解、重建与生成任务。该方法通过在预训练的 WavLM 特征上应用“先压缩后增强”的二阶段训练方案,实现了单一潜空间下的 SOTA 零样本 TTS 效果及卓越的语义辨别力。
TL;DR
在语音领域,长期以来理解(Understanding)和生成(Generation)是两条平行线:前者通过 SSL(如 WavLM)学习语义,后者通过变分自编码器(VAE)捕捉声学细节。WavCube 首次通过一个 128 维的紧凑潜空间,实现了两者的完美兼容。它不仅能像 WavLM 一样搞定 SUPERB 榜单,还能像 SOTA 语音模型一样生成高保真的零样本语音。
核心痛点:为什么 SSL 特征“好听不好用”?
直接将 WavLM 等强大的 SSL 特征用于生成任务(如 TTS)会遇到两个致命障碍:
- 冗余噩梦(Redundancy):1024 维的特征空间充满了对生成任务无用的噪声,Diffusion 模型在这么大的空间里极难学习,导致 WER 飙升。
- 声学缺失(Acoustic Deficit):SSL 的预训练目标是丢弃相位、高频等“细节”以提取语义,这导致其重建出的语音音质极差。
方法论:先“瘦身”后“增肌”
作者提出了一个优雅的 Compress-then-Enrich(先压缩后增强)二阶段流程:
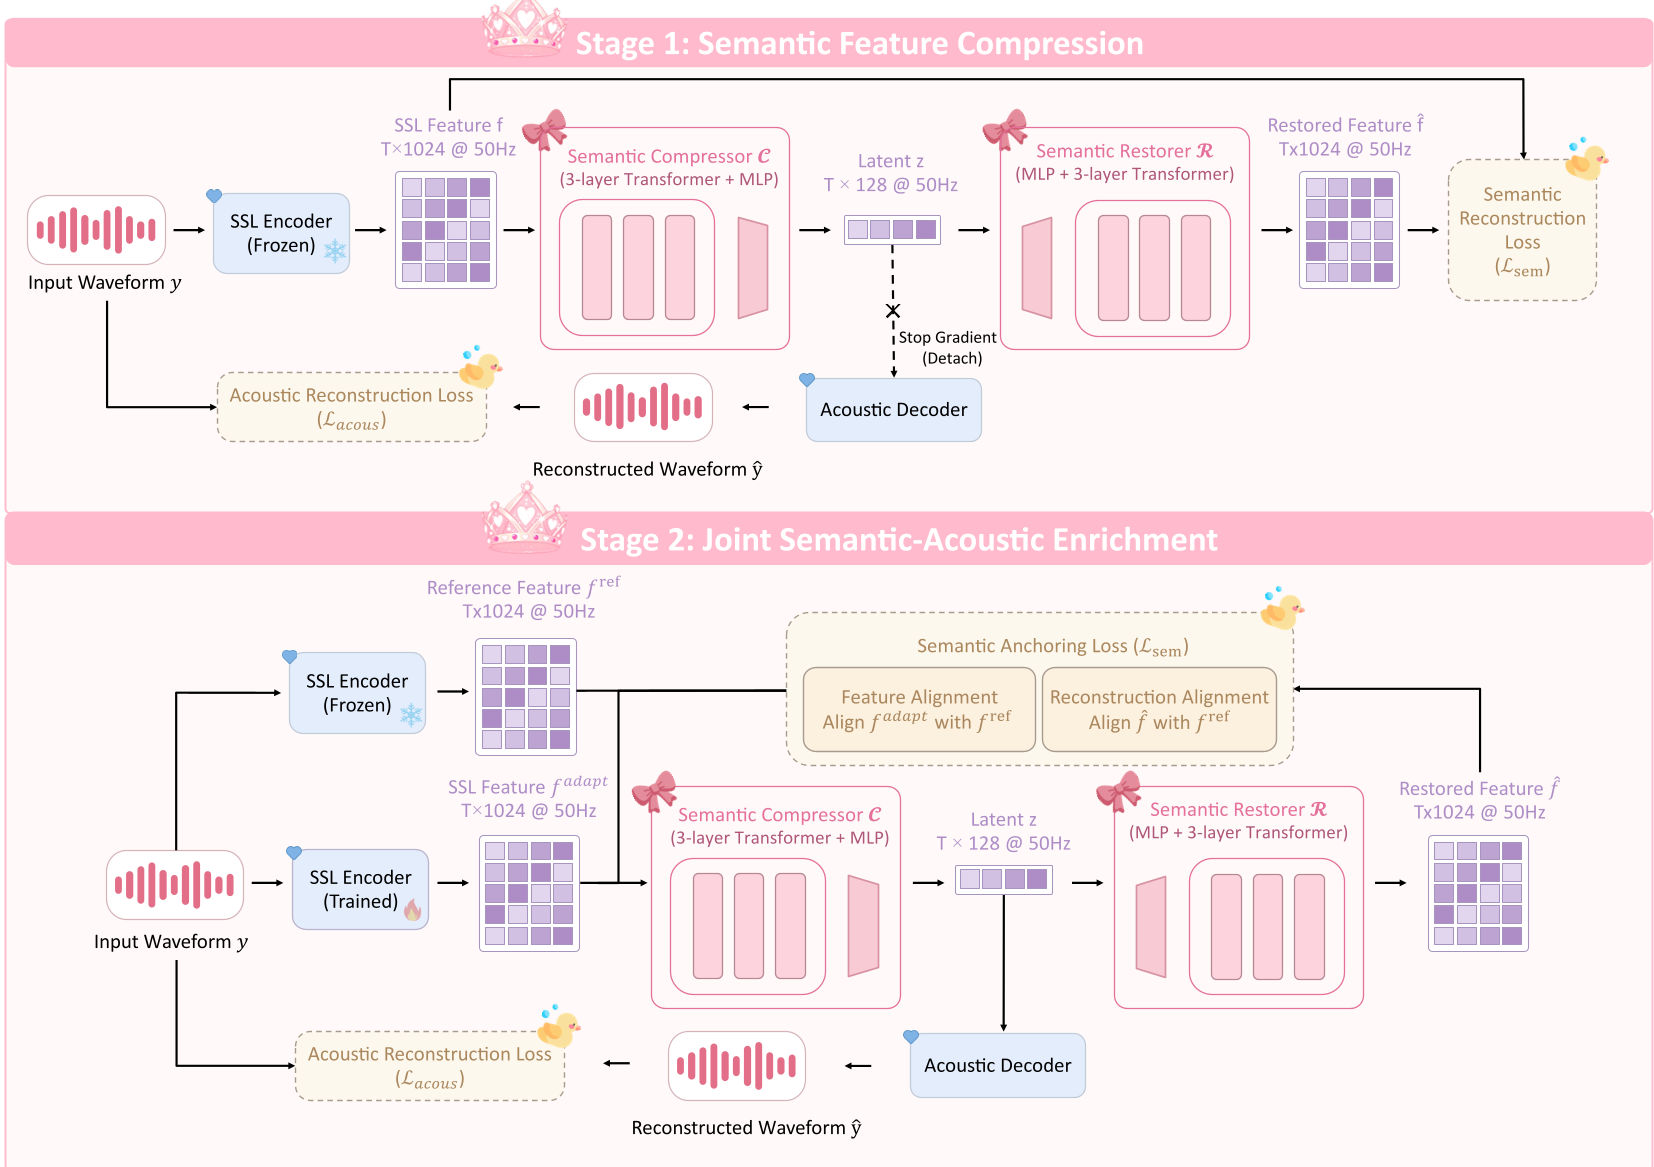
第一阶段:语义特征压缩
利用一个对称的 Adapter 结构,将 1024 维的 WavLM 特征强行压到 128 维。这一步是为了过滤掉那些阻碍 Diffusion 模型收敛的冗余流形,只保留最核心的语义支架。
第二阶段:声学细节注入
解冻 SSL 编码器,进行端到端的音频重建训练。为了防止编码器在学习“怎么发音”时忘了“语义是什么”,作者引入了 Semantic Anchoring(语义锚定) 机制。这就像给微调过程加了一个“紧箍咒”,强制新特征必须与原始 WavLM 特征保持方向一致。
实验战绩:全能选手的诞生
WavCube 在三个维度上证明了其优越性:
- 理解力:在 8 倍压缩下,它在 SUPERB 任务上的表现依然坚挺,甚至在部分任务上由于去噪效应表现更佳。
- 重建质量:通过 t-SNE 可视化(见下文),WavCube 的聚类效果远好于传统的声学 VAE。
- 生成效率:在 TTS 任务中,WavCube 的收敛速度极快。相比 Mel 频谱,它能帮助 Diffusion 模型更早地学会“说话”。
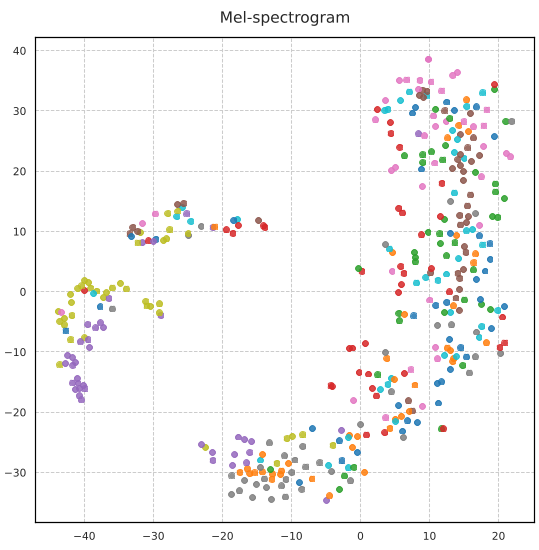 可以看到 (c) WavCube 的类间区分度极高,显著优于 (a) Mel 频谱和 (b) 声学 VAE。
深度洞察:统一表征的未来
WavCube 的成功揭示了一个关键趋势:语义引导的表示学习是生成模型的未来。传统的声学 VAE 完全从零开始学习内容和韵律,这在算力上是极大的浪费。借力已经深度理解语音的 SSL 模型,并通过适当的“声学化”改造,我们正在接近语音处理的“大一统”时刻。
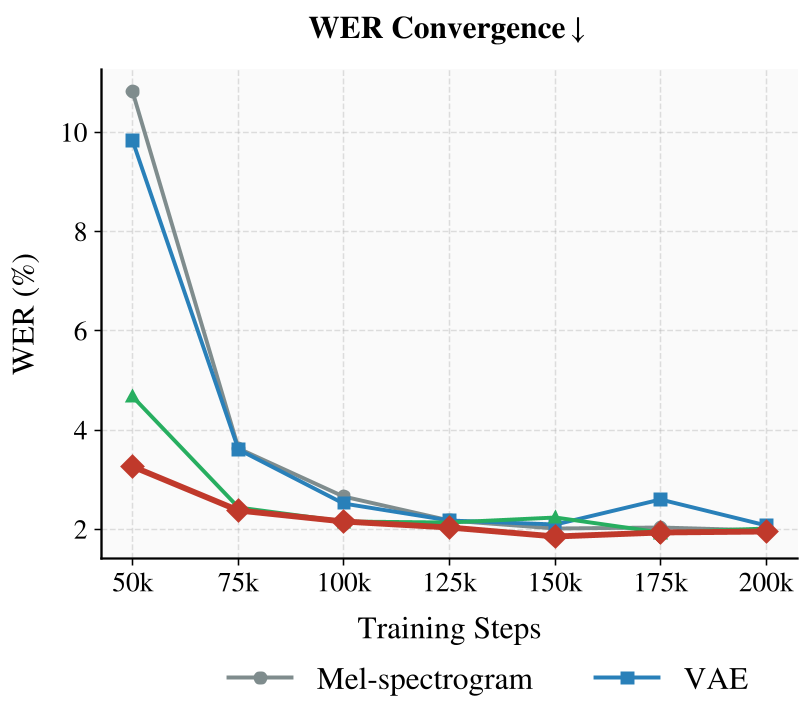 红线代表的 WavCube 在训练极早期就达到了极低的 WER 和极高的相似度,展现了强大的 Diffusion-friendly 特性。
总结
WavCube 不仅仅是一个更高效的 Tokenizer,它为构建像人脑一样既能“听懂”又能“表达”的统一语音大模型奠定了表征基础。