
FFDC-WAM:当想象遇见现实,机器人学会了自适应“回头看”
When to Trust Imagination: Adaptive Action Execution for World Action Models
本文提出了 FFDC-WAM 框架,这是一种用于机器人操纵的自适应世界动作模型(World Action Model)执行方案。核心方法是引入了轻量级的“未来前向动力学因果注意力”(FFDC)验证器,通过对比 WAM 预测的虚拟未来与真实观察的一致性,动态调整动作序列(Action Chunk)的执行长度,在 RoboTwin 模拟及真实场景中均取得了 SOTA 性能。
TL;DR
在机器人控制领域,世界动作模型(World Action Models, WAMs)正通过“边想象边操作”开启新的范式。然而,即便有最强的“想象力”,如果不看路(固定步长执行),机器人依然会跌跤。本文提出的 FFDC-WAM 建立了一种自适应机制:它让机器人实时对比“脑海中的预演”与“眼前的现实”。当两者一致时,大步流星降低功耗;当出现分歧时,果断重规划。这一方法不仅在 RoboTwin 上减少了近 70% 的计算开销,更在复杂任务中提升了成功率。
背景定位:从“盲目执行”到“知行合一”
目前的 VLA(Vision-Language-Action)模型或 WAMs 大多遵循一个套路:输入观察,预测一个 Action Chunk(如 16 步动作),然后机器人闷头执行完这 16 步再看一眼摄像头。
- 痛点:在平滑路径上,16 步太短,浪费电费;在挂钩子等高精操作中,1步走歪,后面15步全是错。
- 核心 Insight:WAM 的独特优势在于它不仅预测动作,还预测了该动作会导致的画面变化。作者利用这一点,把这种“未来的画面”作为验证标准。
核心方法论:FFDC 验证器
作者提出了 FFDC (Future Forward Dynamics Causal Attention),这是一个极其轻量级的 Transformer 模块。它的工作原理如同一个“督导员”:
1. 结构化因果注意力
FFDC 并不需要重启庞大的 WAM 模型。它将 WAM 之前生成的预测视频记号(Tokens)和动作分块放入 KV Cache 中,只对当前拍摄的真实画面进行编码,并通过特定的遮罩(Mask)确保每个时间点的验证只受之前和当前时刻的影响。
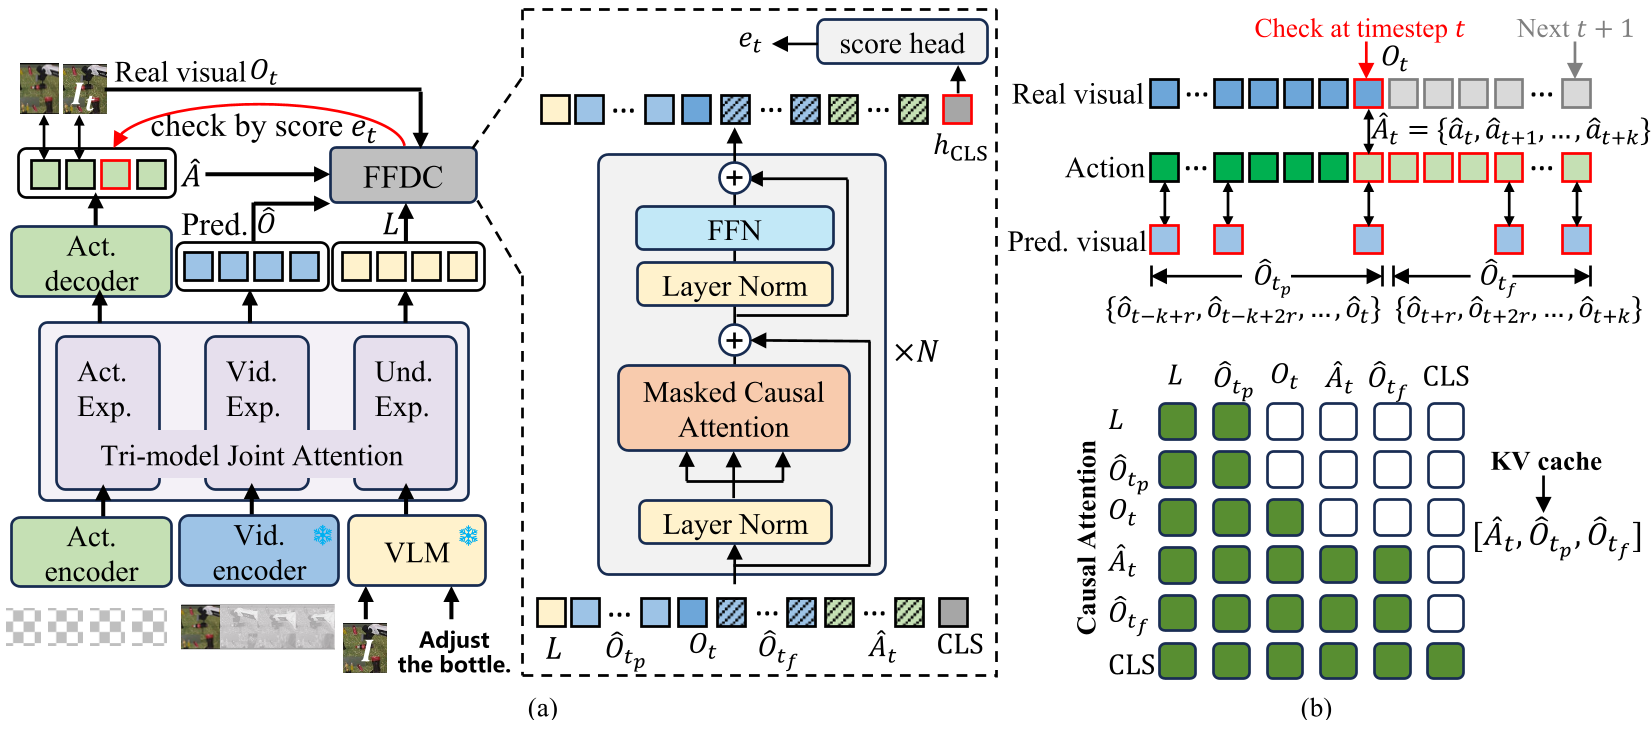
2. 混合时界训练 (Mixture-of-Horizon Training)
为了增强长程覆盖,作者在训练中采用了特殊的采样策略,让模型不仅仅学习从头开始,还能从任务的任何一个中间状态开始进行长距离预测。
实验与结果:效率与鲁棒性的“双赢”
实验数据直接证明了“多干活少说话”的可能性。
- 效率飞跃:在简单任务(Easy Tasks)中,FFDC-WAM 检测到预测极其可靠,因此减少了大量冗余的 WAM 调用,计算次数削减了 69.1%。
- 鲁棒性提升:在“挂杯子”等困难任务中,由于 FFDC 能敏锐捕捉到微小的“货不对板”,它会立即触发重规划(Replanning),使成功率从 50%+ 提升到了 76% 以上。

深度分析:为什么这很重要?
传统的自适应执行(如基于动作不确定性的方法)只看“手”在干嘛。而 FFDC-WAM 是在看“世界”在干嘛。这种通过预测验证现实的逻辑,实际上模拟了人类的本体感受反馈——如果你闭着眼抓杯子发现触感不对,你会立刻睁眼调整。
局限性与挑战: 目前的 FFDC 依赖于二元监督(成功/失败/人工合成的损坏样本)。未来如果能通过自监督学习,让机器人在操作中通过纯粹的预测误差来在线优化验证器,将更具颠覆性。
总结
FFDC-WAM 证明了:在具身智能的道路上,“看得远”(长程预测)固然重要,但“看得准”(实时校验)才是通往鲁棒控制的关键。 这不仅是一个算法的改进,更是对如何高效利用大模型计算资源的一次深度思考。