
Workspace-Bench 1.0:告别原子任务,迈向“工作空间感知”的 AI Agent 新纪元
Workspace-Bench 1.0: Benchmarking AI Agents on Workspace Tasks with Large-Scale File Dependencies
本文推出了 Workspace-Bench 1.0,这是首个针对 AI Agent 在大规模文件依赖(Workspace Learning)场景下的深度评测基准。该框架包含 5 种职业角色、2 万余个真实异构文件及 388 个复杂任务,旨在评估 Agent 在真实数字工作空间中识别、理顺和利用跨文件依赖关系的能力。
TL;DR
AI Agent 真的能像人类员工一样接手复杂的办公项目吗?答案是:还差得远。上海交大与字节跳动等机构联合发布 Workspace-Bench 1.0,通过模拟拥有 20,000+ 异构文件的真实办公环境,揭示了当前最强 Agent(如 Claude-Opus 4.7)在处理跨文件依赖、版本血缘和异构信息整合时的捉襟见肘。目前,Agent 的平均任务通过率不足 50%,人类专家依然是“工作空间学习”领域的绝对霸主。
1. 痛点:被“喂到嘴边”的评优,不是真正的办公
目前的 AI Agent 评测大多处于“温室阶段”:
- Prompt-Driven:信息全在提示词里。
- Task-File-Driven:任务相关的文件被提前剔除、打包好喂给 Agent。
- 现实情况:你有一个 20GB 的文件夹,里面存着五年的项目方案、七个版本的 Excel 预算表和无数封混杂的邮件。你需要 Agent 出一份“去年华东区产品策略对比”,Agent 必须自己去翻目录、避开过时的 V1 版、关联 PDF 里的图表和 Excel 里的原始数据。
这种“在混乱中寻找真相”的能力,被本文定义为 Workspace Learning(工作空间学习)。
2. 核心架构:构建“数字真实感”
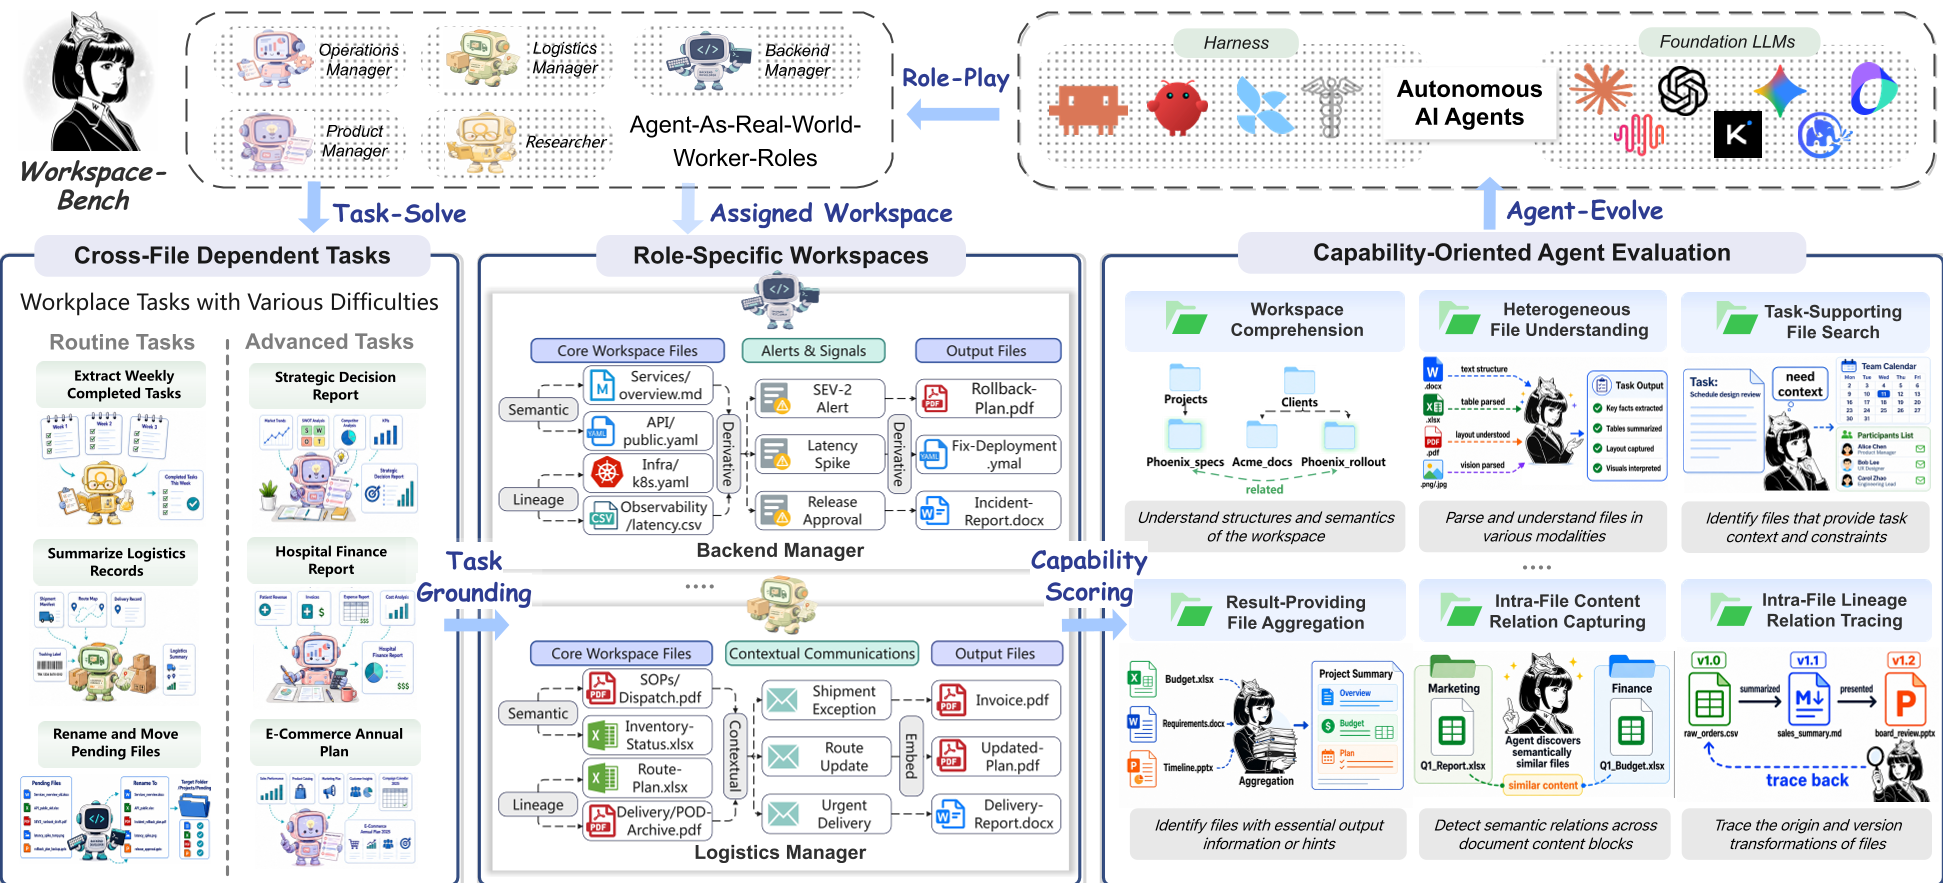
Workspace-Bench 不再提供孤立的任务,而是构建了 5 个完整的职业生态:
- 五大角色:运营经理、物流经理、AI 产品经理、后端开发、研究员。
- 异构文件系统:支持 74 种文件类型,模拟深层嵌套目录(最深 8 层)。
- 依赖图谱:每个任务都关联一个隐式的 Dependency Graph,包含语义关联(Content Relations)和血缘关系(Lineage Relations)。
3. 方法论:Agent-as-a-Judge 与双重并行加速
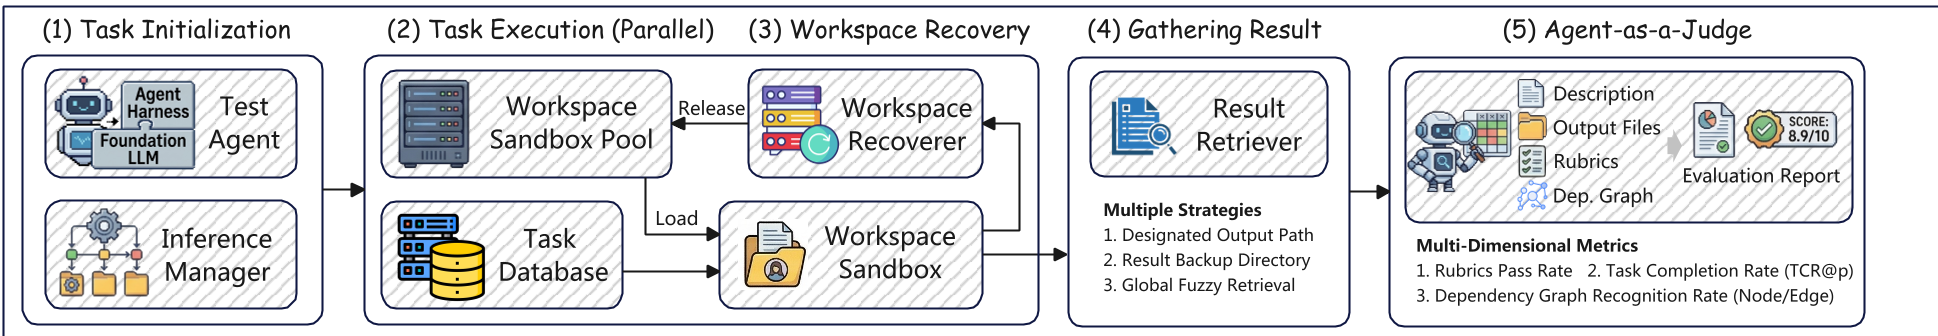
为了评估这些动辄需要几十步操作的长航时任务,作者设计了一套严密的工业级评测框架:
- 沙箱隔离与回滚:利用并行 BFS 算法实现工作空间状态的快速比对与回滚,确保每项任务都在干净的环境中进行。
- 多重评估维度:不再只看“结果对不对”,而是通过 7399 个 Rubrics 考察:
- 基础合规性:文件命名、存放路径对吗?
- 中间过程:Agent 找对文件了吗?避开废弃版本了吗?
- 结果质量:逻辑是否自洽,数据是否准确。
4. 深度实验洞察:谁才是最强打工人?
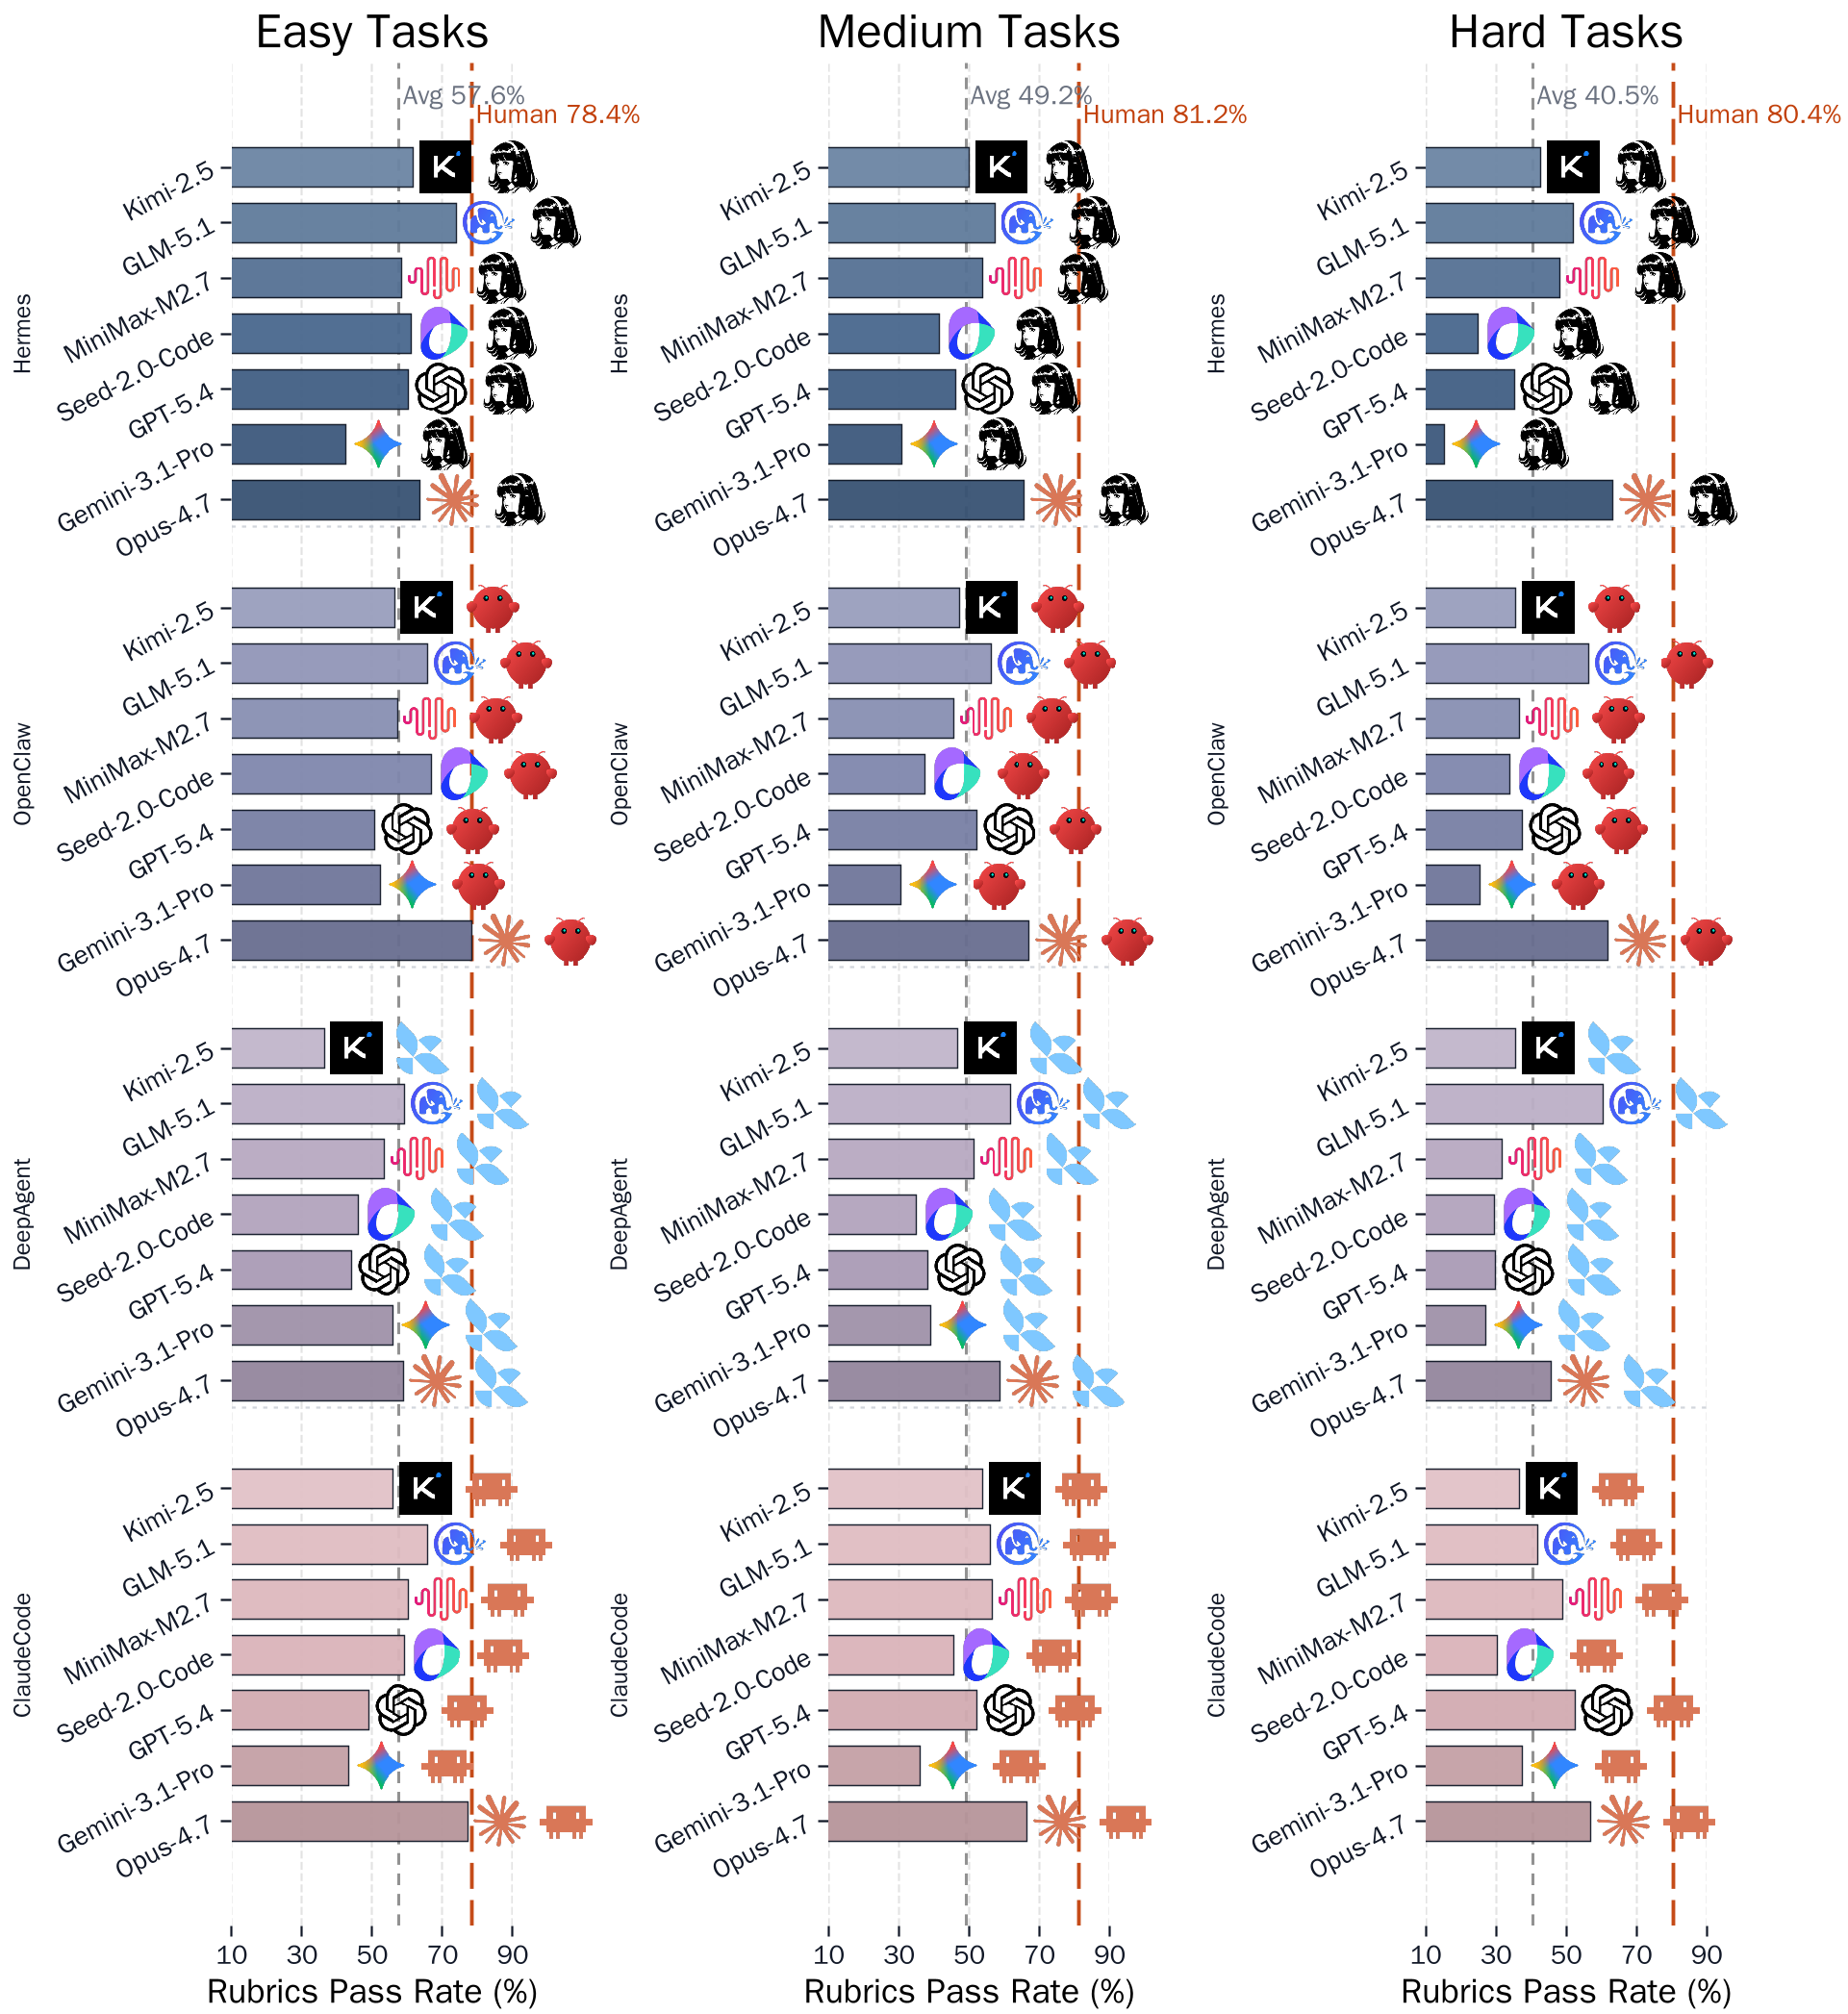
作者测试了 4 种 Agent 框架(ClaudeCode, OpenClaw, DeepAgent, Hermes)与 7 种主流基座模型。
核心发现 1:难度越高,跌得越快
随着任务从 Easy(简单汇总)向 Hard(跨异构文件血缘追踪)演进,Agent 的 Rubrics Pass Rate 从 57.6% 暴跌至 40.5%。
核心发现 2:依赖识别是致命伤
实验显示的 Edge F1 Score(边缘识别得分) 普遍极低。这意味着 Agent 虽然能找到相关的报表(Node),但很难理清楚报表 A 是如何基于邮件 B 修改而成的(Edge)。这种“血缘断裂”导致 Agent 经常引用过时信息。
核心发现 3:框架(Harness)是弱模型的“增幅器”
性能强大的模型(如 Claude Opus 4.7)在不同框架下表现都稳健;但对于中等模型(如 GLM-5.1),DeepAgent 等框架的编排能力能显著提升其在复杂任务中的稳定性。
5. 行业展望:解决“数据关联鸿沟”
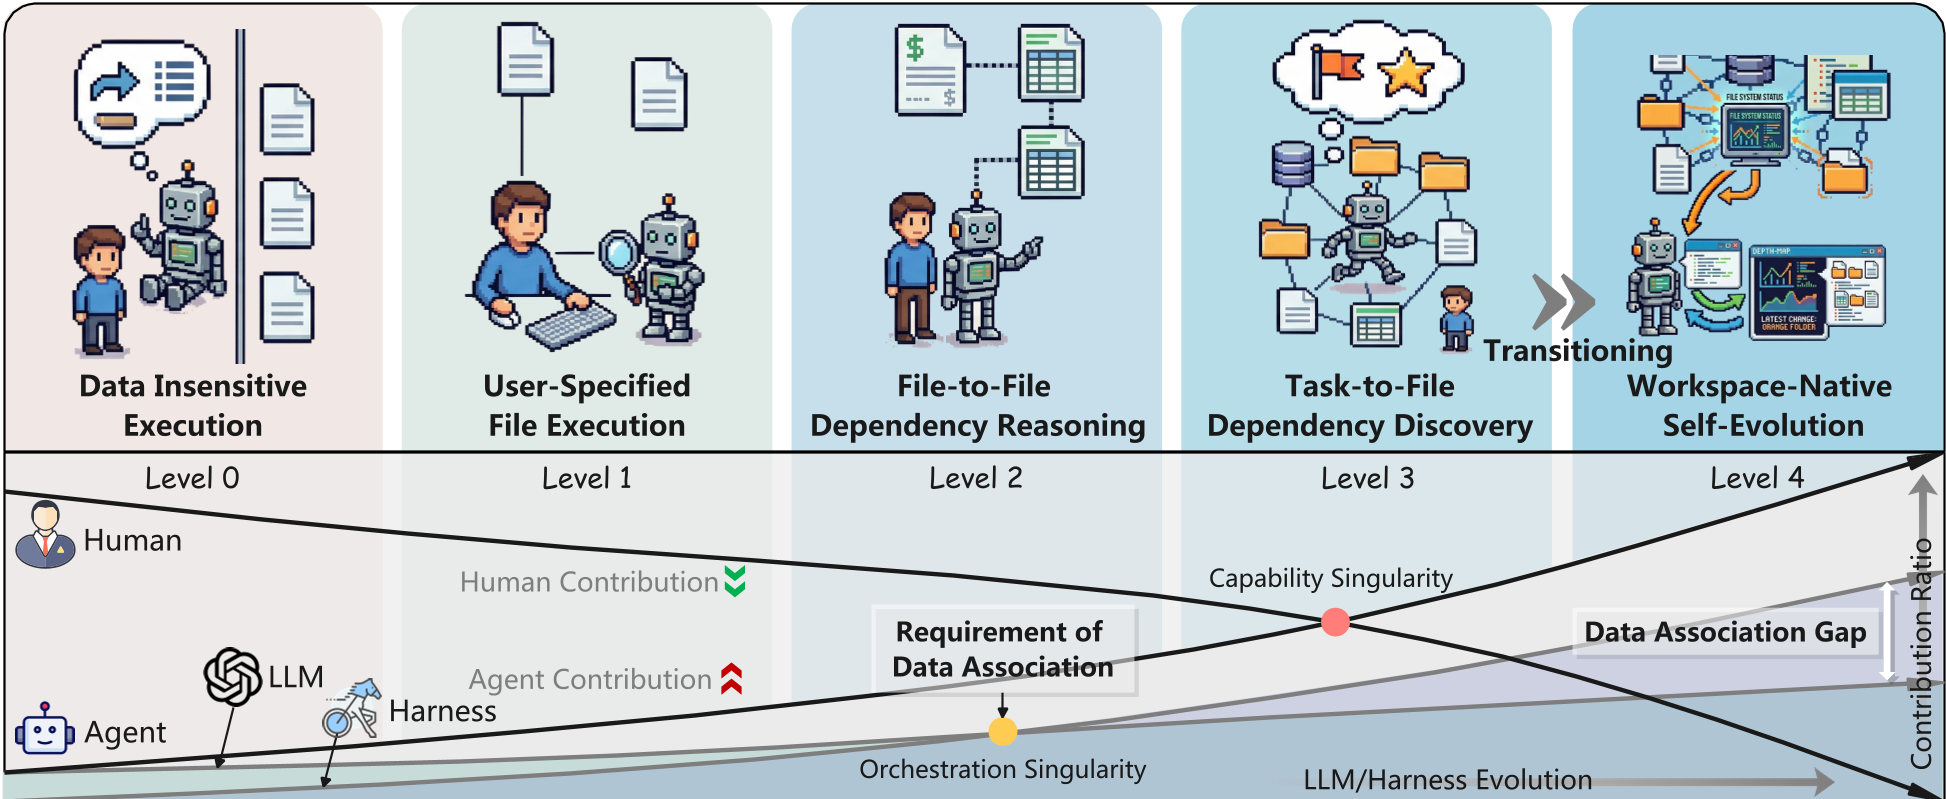
本文提出了 Workspace Learning 的 五个阶段 (L0-L4):
- L0-L1:被动咨询与指定路径执行。
- L2-L3:开始具备依赖推理与主动探索能力(当前 Agent 的天花板)。
- L4:工作空间原生自进化(Workspace-Native Self-Evolution),Agent 能够伴随用户工作习惯自动迭代工具库。
结论:当前 Agent 的核心短板在于 Data Association Gap(数据关联鸿沟)。未来的 Agent 不仅需要更大的上下文窗口,更需要一种能原生理解文件系统语义拓扑的“导航大脑”。
💡 资深主编点评: Workspace-Bench 的价值在于它打破了 RAG 任务中“检索即成功”的幻觉。在真实工作流中,检索只是第一步,理清万物之间的 Lineage(血缘)才是决策的关键。这篇文章不仅是一个榜单,更是为下一代“具身智能办公”划定了明确的战场。