
具身智能的“预言家”:机器人学习中世界模型的深度解析与前瞻
World Model for Robot Learning: A Comprehensive Survey
本文是关于机器人学习领域世界模型(World Models)的综述,系统梳理了预测性表示在策略学习、规划、模拟和数据增强中的核心作用。重点探讨了视觉-语言-动作(VLA)策略如何与生成式视频模型紧密耦合,并总结了当前 SOTA 模型在 LIBERO 等基准测试上的表现。
TL;DR
机器人策略正在经历从“见招拆招”到“算无遗策”的进化。本文深度解析了一篇关于机器人世界模型的重磅综述,揭示了研究者如何通过大规模视频预训练赋予机器人“ Foresight”(远见),使其在执行任务前能先在虚拟大脑中“预演”动作后果,从而突破复杂操作任务的瓶颈。
1. 为什么机器人需要一个“世界模型”?
当前的 Vision-Language-Action (VLA) 模型固然强大,但本质上仍是**反应式(Reactive)**的。当面临需要接触力学分析、长路径规划或环境剧烈变化的情况时,单纯依靠观察到动作的映射往往会因为微小的误差积累(Compounding Errors)导致任务彻底失败。
核心动机 (Motivation):作者认为这种局限性源于缺乏对物理世界演变规律的显式建模。世界模型(World Model)作为一个预测性的“预言机”,能够根据当前状态 和预选动作 ,预测未来的环境状态 ,为策略提供关键的归纳偏置(Inductive Bias)。
2. 架构演进:从“插件”到“灵魂”
论文将世界模型与策略的耦合方式细分为四种主要范式,展现了技术路线的演进过程:
2.1 解耦的反向动力学 (IDM-style)
这是早期的主流做法,如 UniPi。先用视频生成模型画出“未来长什么样”,再用一个独立的模型问:“为了达到这个变动,我该怎么动?”这种方式模块化强,但容易出现视频看起来很稳、机器人动起来很乱的“动作不一致”问题。
2.2 统一主干架构 (Single-backbone)
如 Cosmos Policy。它将动作、状态、奖励全部 Token 化,塞进同一个 Transformer 里。预测未来和产生动作在同一个隐空间(Latent Space)内进行计算。
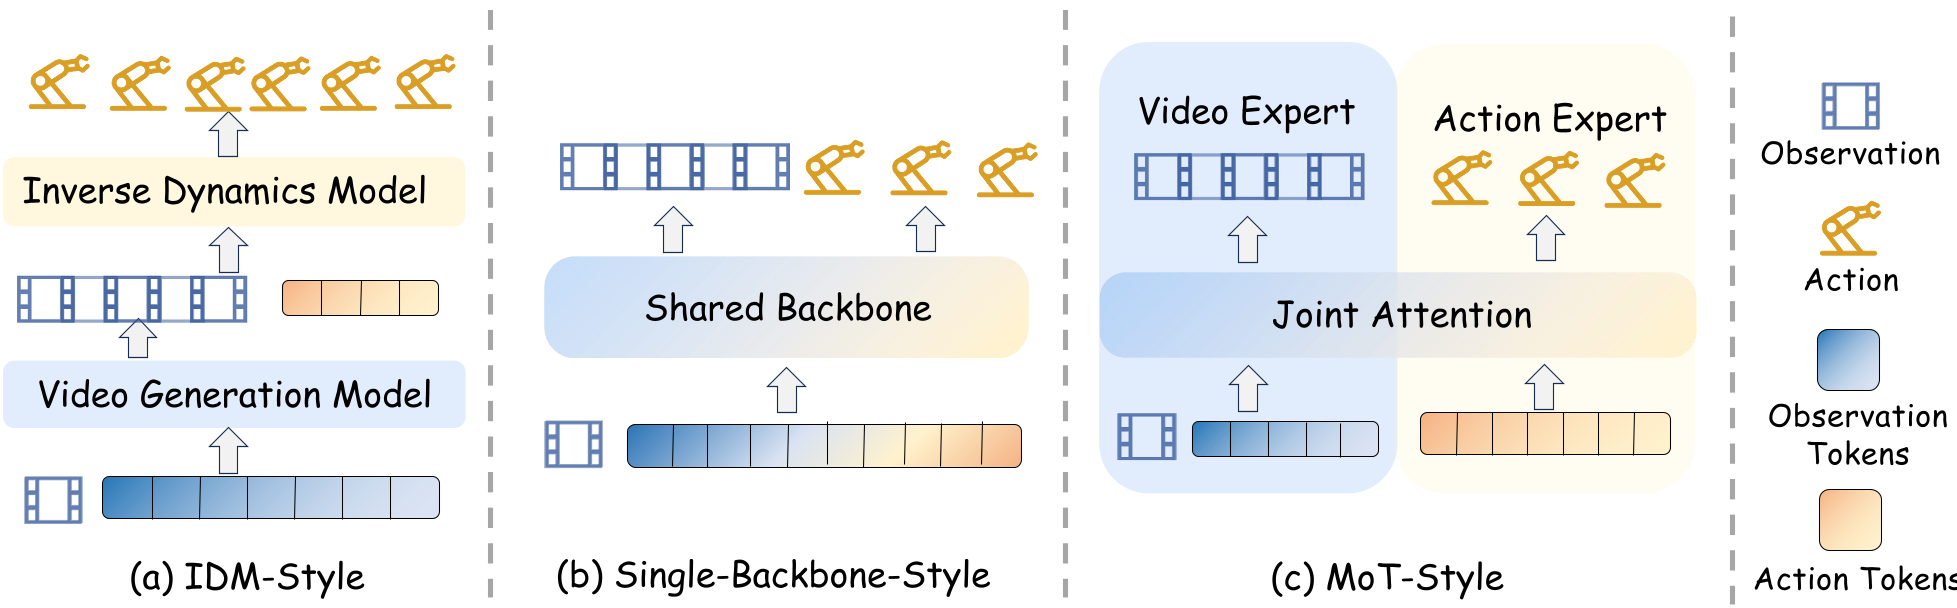 图 1:IDM 风格(左)、统一主干(中)与混合专家 MoT(右)架构对比
2.3 混合专家系统 (MoE/MoT)
这是目前表现最惊艳的方向。通过专用的视频专家(Video Expert)和动作专家(Action Expert)进行交叉注意(Cross-attention)交互。既保留了视频生成的高质量时空特征,又确保了控制的高灵敏度。
3. 世界模型作为“学会的模拟器” (Learned Simulator)
世界模型的另一项巨大价值在于强化学习的“数字孪生”。 以往的强化学习需要在昂贵的真机或不真实的物理引擎(如 Isaac Sim)中运行。现在的趋势是:
- Imagination-based RL:在世界模型生成的视频里练级,学习失败后的补救措施。
- 验证与评测:在真实执行前,先在头脑里跑 10 遍模拟,挑一个得分最高的去执行(如 GPC 方法)。
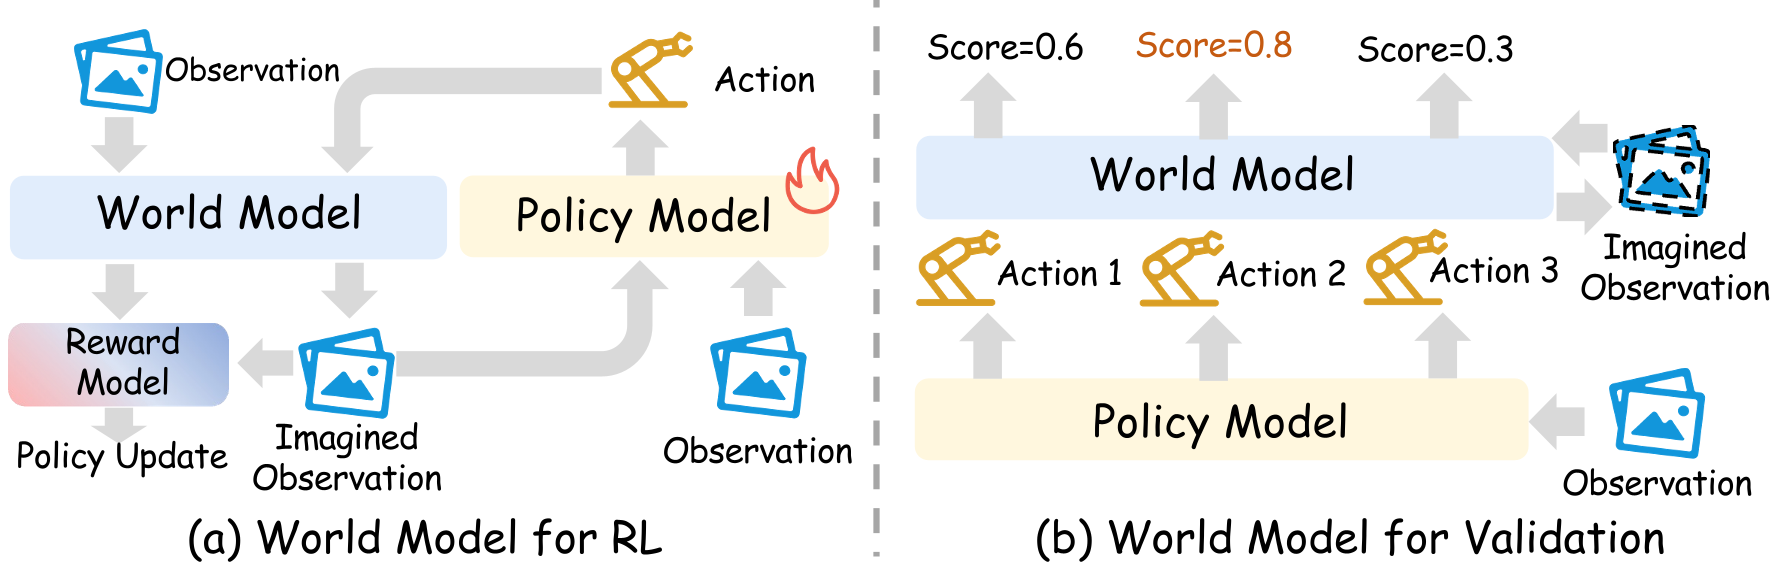 图 2:世界模型作为模拟器进行训练与验证的流程
4. 核心挑战:不仅是“画得像”,更要“动得真”
尽管通过大规模视频预训练,模型生成的视频已经接近影视级特效,但在机器人学习中,Action-conditioned Reliability(动作条件下的可靠性)仍是老大难问题:
- 因果失调:视频模型可能只是根据上一帧画面惯性绘图,而忽略了机器人手指捏捏的小动作。
- 计算瓶颈:Diffusion 模型迭代去噪太慢,难以满足 20Hz 以上的实时控制需求。
- 物理短板:视频里物体被穿模、重力感缺失等现象依然存在,缺乏触觉(Tactile)和力反馈的整合。
5. 总结与行业启示
这篇综述明确指出,世界模型不再是可有可无的辅助工具,而是通往**通用具身智能(G-EM)**的必经之路。
Takeaway: 对于开发者而言,未来的机会不在于单纯刷大 VLA 的参数量,而在于如何高效地将视频生成模型的“物理常识”蒸馏到轻量级的实时控制策略中。世界模型正在成为连接语义意图(Language Intent)与物理执行(Physical Execution)之间最关键的桥梁。