
WORLDJEN:突破低分辨率限制,构建视频生成的“物理真理性”评测深度基准
WorldJen: An End-to-End Multi-Dimensional Benchmark for Generative Video Models
本文推出了 WORLDJEN,一个针对生成式视频模型的端到端多维评测基准。通过引入 LLM 增强的复杂 Prompt 和基于 VLM 的 Likert 量表问卷评估,该基准在 6 个主流模型上实现了与人类偏好 1.0 的 Spearman 秩相关性。
TL;DR
生成式视频领域正在经历从“能看”到“合理”的跨越,但传统的评测工具(如 VBench)正因分辨率限制和简单的二元问答而失效。WORLDJEN 提出了一个全新的端到端框架:通过 VLM(如 Gemini 3 Flash)在原生分辨率下进行 16 个维度的 Likert 评分,成功复现了人类的审美与逻辑排序,揭示了当前 SOTA 模型在物理规律模拟上的集体滑铁卢。
痛点深挖:为什么现有的基准测试在“欺骗”我们?
目前的视频模型评估面临三大顽疾:
- 分辨率降级陷阱:VBench 等主流基准在提取特征前会将视频缩放至 224x224。在这种分辨率下,微弱的闪烁、肢体扭曲和物理穿模会被像素平滑掉,导致评分虚高。
- 二元偏见 (Yes-bias):当问 VLM“物理是否正确?”时,除非发生灾难性崩坏,VLM 通常倾向于回答“是”,缺乏对质量等级的细微区分。
- Prompt 简单化:现有的评测 Prompt 往往只针对单一维度(如“运动流畅性”),而真实用户的指令通常是多维度交织的(如“穿着披风的刺客在雨中急停”)。
核心方法论:WORLDJEN 的精密机制
WORLDJEN 的核心在于其Phase B 评估引擎,它放弃了简单的特征对比,转而采用类似“法官”的判断逻辑:
- 原生分辨率评估:VLM 直接处理原始比例帧,确保微小的物理瑕疵无所遁形。
- 针对性 Likert 问卷:系统不再问泛泛的问题,而是针对每条 Prompt 自动生成 10 个具体问题(例如:“马在急停时,刺客的头发是否因惯性向前甩动?”),并给出 1-5 分的评分标准。
- 维度感知采样:针对不同维度使用不同采样模式。
- Micro 模式(重点监测物理规律):对视频前 2 秒进行密集采样,捕捉起步和碰撞瞬间。
- Holistic 模式(审美维度):全局均匀采样 32 帧。
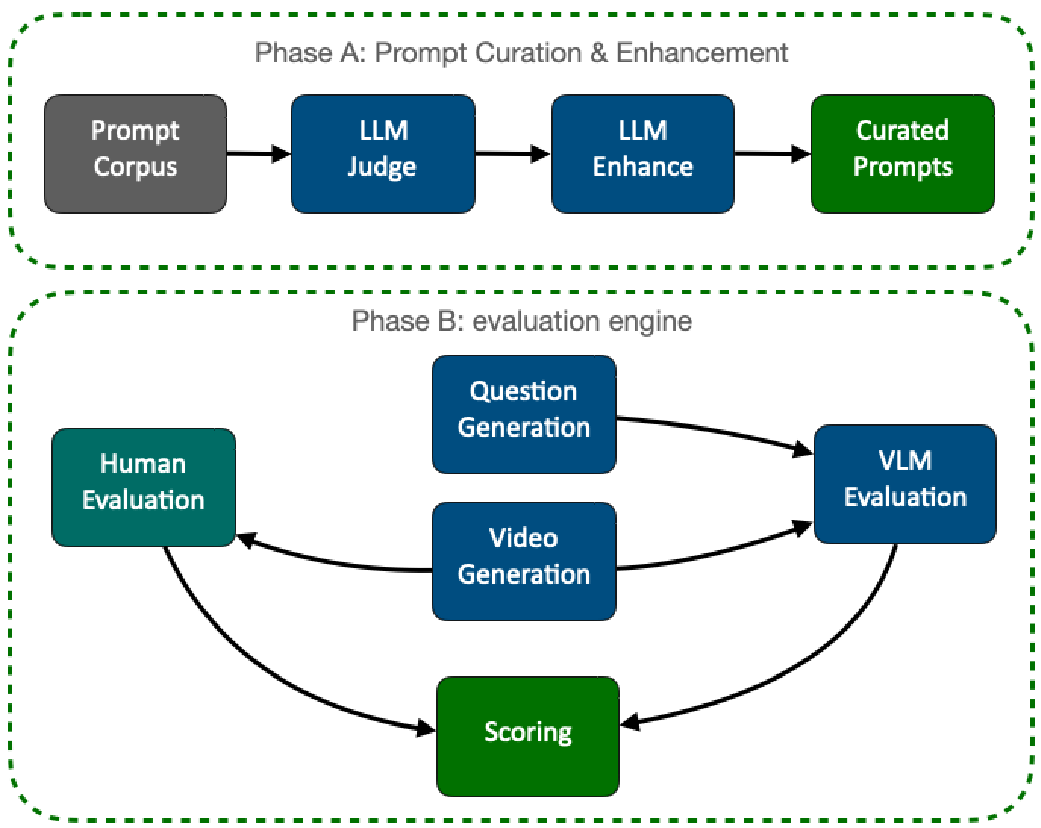 WORLDJEN 框架总览:从 Prompt 增强导出视频,再由 VLM 基于特定问卷评分,最终通过 BT 模型生成排名。
实验结果:谁才是真正的视频之王?
通过对 Veo 3.1, Kling v2.6, LTX-2 等 6 个 SOTA 模型进行横向测评,WORLDJEN 得出了极具启发性的结论:
- 阶级分化清晰:Veo 3.1 Fast 和 Kling v2.6 Pro 稳居第一梯队。人类专家标注与 VLM 自动评分在梯队划分上达到了 100% 的一致性。
- 物理规律是阿喀琉斯之踵:在 16 个维度中,物理力学 (Physical Mechanics) 和 惯性一致性 (Inertial Consistency) 是所有模型的重灾区,平均分仅在 3 分左右。相比之下,颜色和谐度等审美指标已趋于饱和(4.5 分以上)。
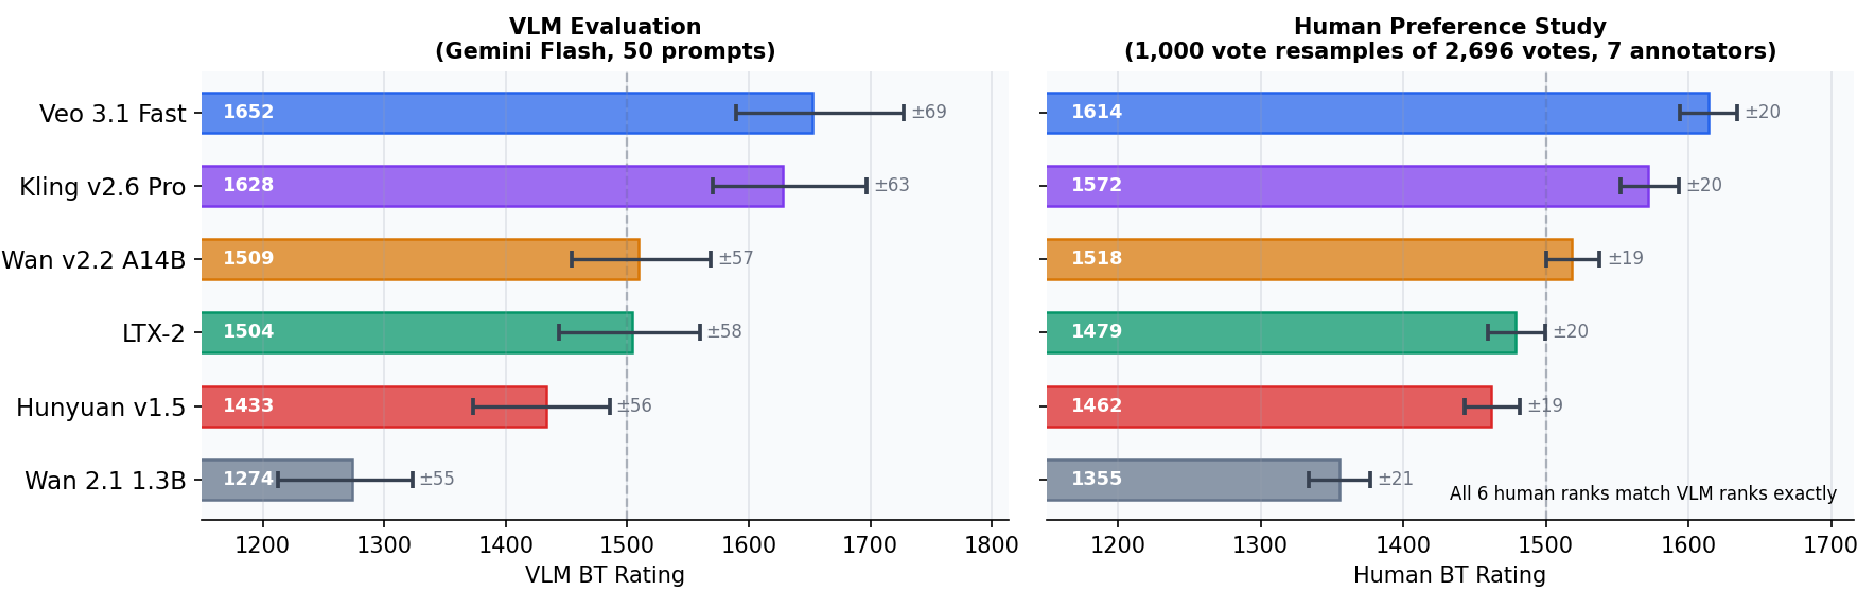 VLM 与人类 BT 评分对比:验证了 VLM 评分作为人类偏好代理的可靠性。
消融研究与鲁棒性
作者还验证了 VLM “法官”的独立性。使用 Claude 3.5 Sonnet 作为替代审计者,虽然绝对分值比 Gemini 更严格(低约 1 分),但得出的模型相对排名和三梯队结构完全一致。这证明了 WORLDJEN 定义的评估范式是跨模型鲁棒的。
此外,通过对比 VBench,WORLDJEN 展示了其在“动态程度”和“运动流畅性”上拥有 1-12 倍更高的区分度(Discrimination Power),有效解决了指标“触顶”导致排名失效的问题。
深度洞察与总结
Takeaway: WORLDJEN 的意义不仅在于提供了一个更准的榜单,更在于它定义了视频模型评测的新准则:必须在原生分辨率下进行逻辑质询。
局限性: 尽管 WORLDJEN 表现优越,但目前尚未全面整合视频配套音频的评测。此外,由于 VLM 推理成本较高,对数千条 Prompt 进行大规模扫描仍具有挑战。
未来展望: 随着原生多模态大模型的进化,类似 WORLDJEN 的自动化评测将集成到视频模型的训练循环中,作为 Checkpoint 择优的关键信号。当模型学会了如何“通过问卷”,它们也就真正学会了物理世界的运行逻辑。