
X-Voice:让每个人都能用 30 种语言“原声”对话
X-Voice: Enabling Everyone to Speak 30 Languages via Zero-Shot Cross-Lingual Voice Cloning
本文推出了 X-Voice,一个拥有 0.4B 参数、支持 30 种语言的多语言零样本任务(Zero-Shot)语音克隆模型。该模型基于 Flow-Matching 架构,通过 IPA 统一表示和两阶段训练范式,实现了无需参考文本(Transcript-Free)的跨语言语音合成,性能媲美 Qwen3-TTS 等十亿级模型。
TL;DR
在零样本(Zero-shot)语音克隆领域,X-Voice 的出现标志着多语言合成进入了“无文本依赖”的新阶段。这是一个 0.4B 参数量的 Flow-matching 模型,在 420K 小时的海量数据上炼就。它不仅支持 30 种语言,最核心的突破在于:当你克隆别人的声音时,你不再需要提供那段录音的文稿(Transcript-free)。
背景定位:从 AR 的泥潭到 NAR 的超车
目前多语言语音克隆主要分为两派:
- 自回归(AR)派:如 VALL-E、Qwen3-TTS。虽然能力强,但推理速度慢(RTF 高),且存在“一步错步步错”的误差累积问题。
- 非自回归(NAR)派:如 F5-TTS、Voicebox。这类模型速度极快,但在多语言扩展、尤其是跨语言发音的“地道感”上一直存在挑战。
X-Voice 选择了 NAR 路径,并针对多语言环境下的文本依赖和口音污染两大痛点进行了外科手术式的改进。
核心直觉:如何摆脱文稿的束缚?
通常克隆声音需要输入:参考音频 + 参考音频文本 + 目标文本。
但在很多现实场景(如方言、录音质量差)中,我们根本拿不到参考音频的准确文稿。
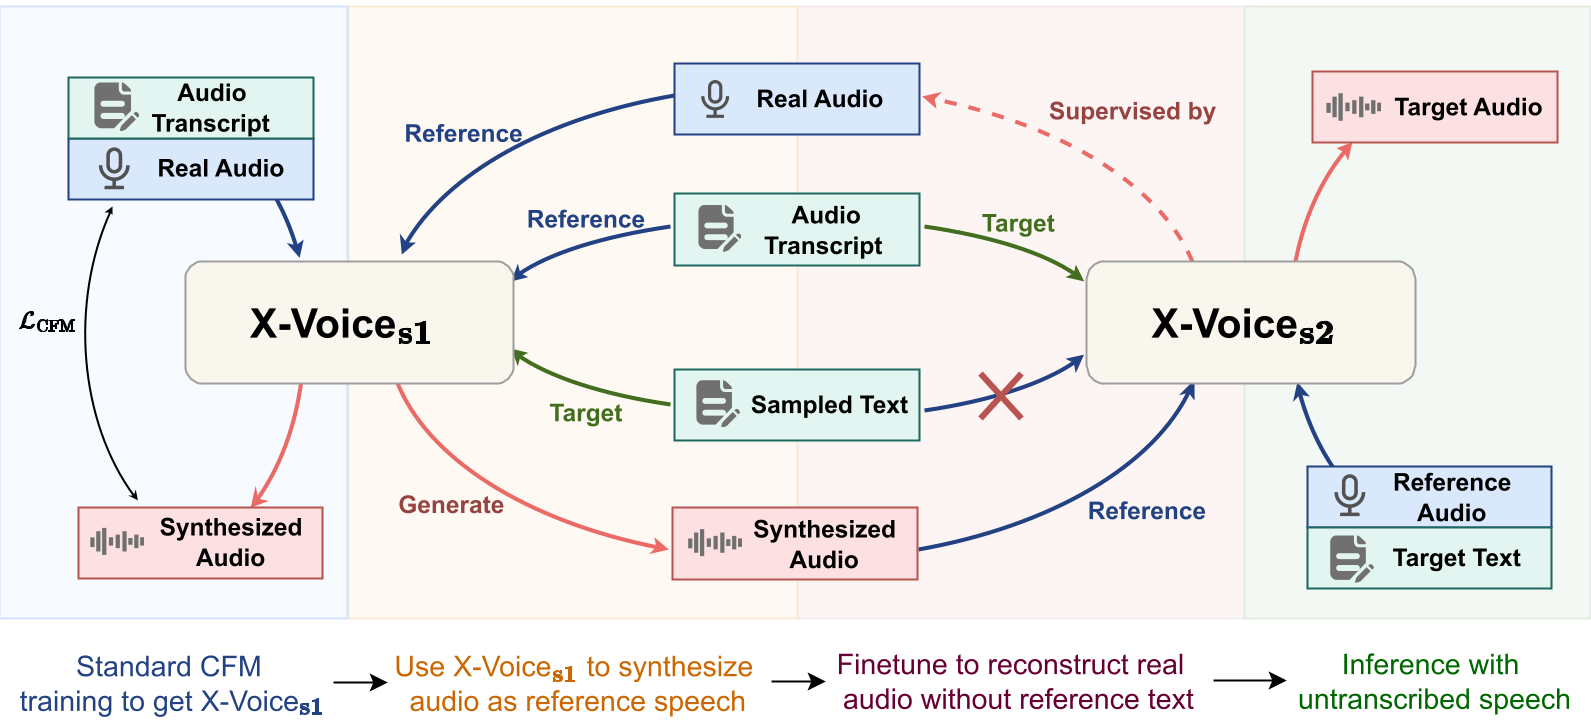
X-Voice 提出了一个非常巧妙的两阶段训练范式:
- Stage 1 (建立基座):在 420K 小时全量数据上训练 X-Voices1,建立强大的多语言声学空间。
- Stage 2 (伪数据蒸馏):利用 Stage 1 的模型生成 10K 小时音色极其稳定的“伪音频”,这时候我们已确切知道伪音频对应的文本。接着,在 Fine-tuning 时故意屏蔽掉 Prompt 的文本,强迫模型学会直接从音频信号中抽取音色和韵律特征。
架构黑科技:消灭“外国口音”
跨语言克隆最怕的是:用英语母语者的音色说中文,结果带了一股浓厚的“大茬子味儿”。
1. 双层语言注入 (Dual-level Language Injection)
作者发现只在文本层面告诉模型语言 ID 是不够的。X-Voice 在**时间步(Time level)和文本令牌(Textual level)**双重注入语言信息。
- 在时间步上,将 Language ID 与时间嵌入结合,引导 ODE 轨迹。
- 在文本步上,使用 FiLM (Feature-wise Linear Modulation) 对 IPA 嵌入进行动态缩放,确保发音单元被模型以目标语言的方式“激活”。
2. 解耦与异步引导 (Decoupled & A-Warmup CFG)
在推理时,传统的引导(CFG)往往在“音色相似度”和“发音准确度”之间拆东墙补西墙。X-Voice 引入了异步预热(Asymmetric Warmup):
- 前期:火力全开增强音频引导,锁定说话人的身份轮廓。
- 后期:线性增加语言引导,确保发音的清晰度。
实验战果:小参数,大能量
尽管只有 0.4B 参数,X-Voice 在多语言测试集上的表现却丝毫不逊色于工业级的巨无霸模型。
- 速度优势:RTF 仅为 0.073,比 Qwen3-TTS 快了整整一个数量级,非常适合实时交互场景。
- 克隆精度:在涉及中文、英文、俄语、韩语等 30 种语言的跨语言测试中(如 zh -> ru),WER 保持在极低水平。

总结与价值
X-Voice 不仅仅是一个更好的 TTS 模型,它更像是一个开源的多语言生态。作者不仅开源了模型,还开源了 420K 小时的清洗后语料和一套经验证的基准测试集。
学术洞察:它告诉我们,当数据量达到数十万小时级别时,参数量不再是唯一的瓶颈,精巧的训练范式(如两阶段蒸馏)和更强的电感偏置(如双层语言注入)能让小模型迸发出巨大的潜力。
局限性:虽然 30 种语言已经很多,但在同一个句子内混合多种语言(Code-switching)的表现仍有待优化。这或许是下一个版本 X-Voice 3 的攻克方向。