
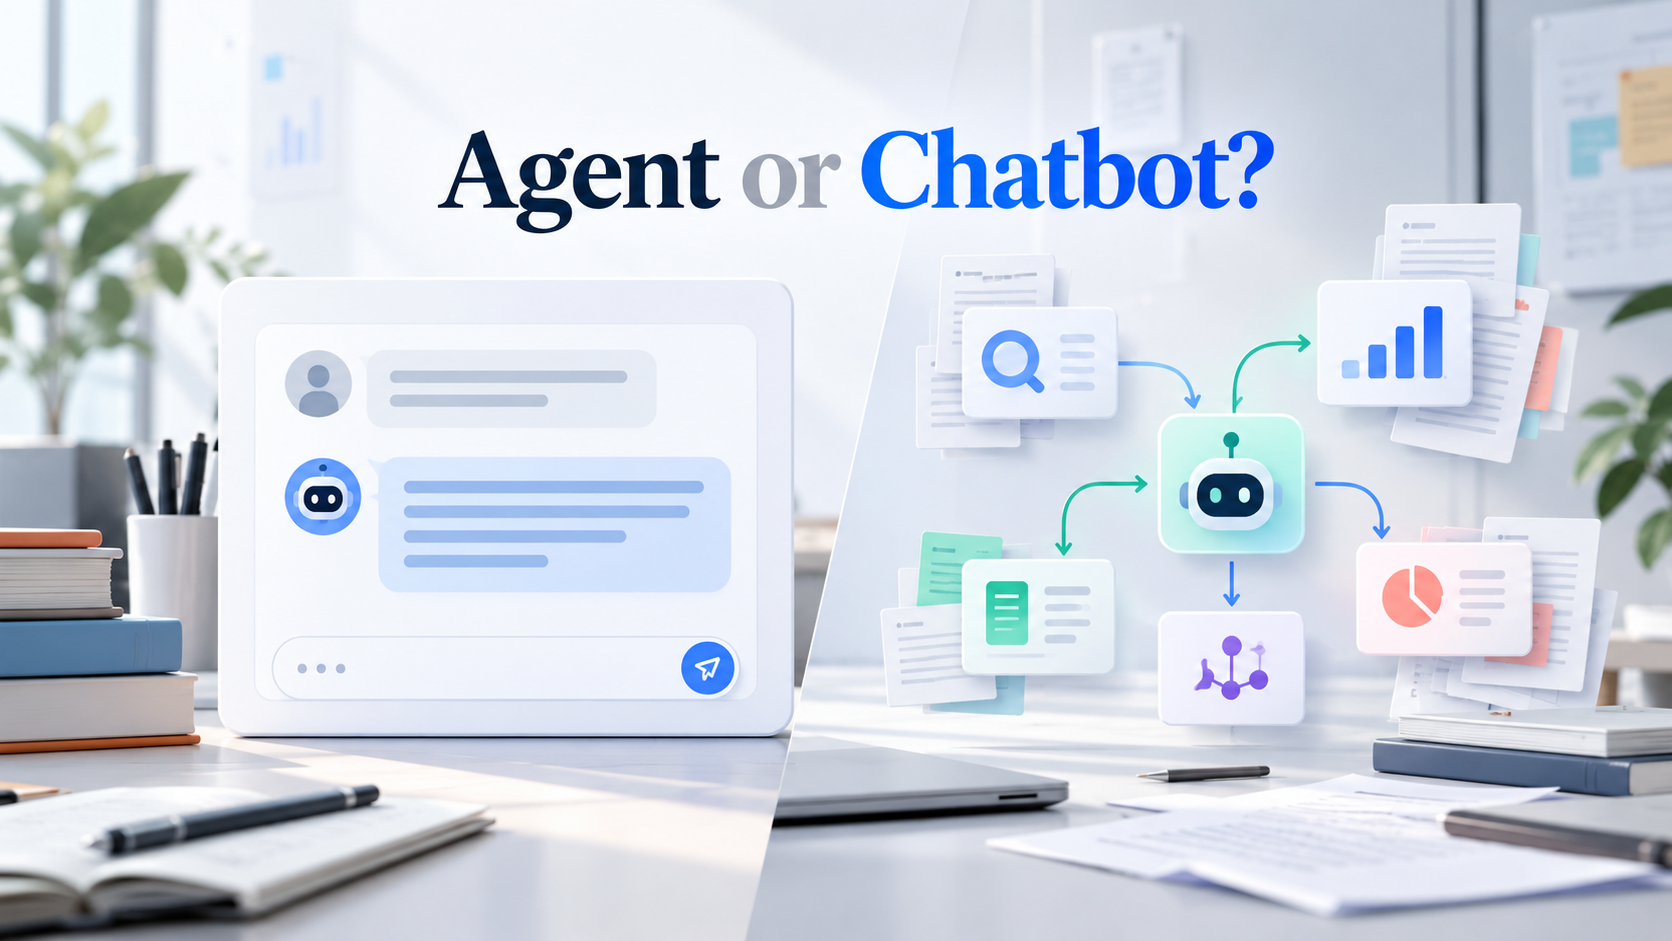
如果你已经知道要读哪篇论文、要解决哪个段落,普通聊天机器人通常就够了。如果任务是“搜索多个来源、调整问题、比较资料,再交付一份带过程记录的报告”,研究 Agent 才更有价值。
两者的区别不只是回答长短,而是从问题到结果之间,系统替你完成了多少规划和工具操作。
局部问题,用聊天机器人
上下文已经在眼前时,聊天机器人很合适:
- 解释这一段研究方法
- 把这些纳入标准改成检查表
- 比较我上传的两段文字
- 从三篇相关摘要中扩展检索词
- 帮我重组一段文献综合
你提供来源,也控制每一步。回答很快,方向错了也能及时纠正。
当一个问题暗藏很多任务时,它的弱点就出现了。“综述 AI 反馈在护理教育中的研究”至少包含搜索、修改检索式、筛选、去重、综合和引用核查。普通聊天可能立刻给出答案,却没有交代这些步骤是怎么处理的。
多步调查,用研究 Agent
研究 Agent 可以规划检索、访问来源、根据结果改变方向,再整理报告。OpenAI 把 deep research描述为适合综合多个来源的多步问题,并在结果中提供引用或来源链接。
它适合:
- 梳理一个窄问题的主要研究路线
- 寻找近期论文并追踪重要引用
- 比较几篇综述怎样界定领域
- 提出候选 research gap 及其证据
- 生成带纳入理由的来源表
自主性减少了来回操作,也会让错误连续放大。起始范围一旦设错,Agent 可能在你看到报告前已经沿着错误方向搜了很多轮。
根据不确定性选择,不要只看功能新不新
问自己两个问题:
- 我是否知道应该使用哪些来源?
- 我是否知道回答问题需要哪些步骤?
两个答案都是“知道”,用普通聊天或基于固定来源的文献库工具即可。来源未知,但任务和验收标准明确,可以让 Agent 探索。如果连问题和证据标准都模糊,先进行一段短对话。给 Agent 一个宽泛主题,不会自动把它变成研究问题。
应该怎样给研究 Agent 写任务说明?
写清研究人群或场景、核心概念、年份、资料类型、语言、排除项和最终格式,并要求保留检索记录和不确定项。
例如:
查找 2022 年以来 AI 生成反馈在本科护理教育中的实证研究,排除观点文章和 K–12 场景。把随机、观察性和定性研究分开。每篇提供稳定记录、研究设计、人群、实际测量结果和纳入理由,并列出尝试过的搜索及尚未解决的缺口。
这个任务既给了停止条件,也给你留下审核报告的依据。
WisPaper 在流程中放在哪里?
目标明确是寻找学术论文时,可以从 WisPaper Search 开始;任务较长时,也可以使用 Scholar Agent。把筛选后的论文存进 My Library,再由 Library QA 围绕你确认的集合回答问题。
这样分工更清楚:Agent 负责探索,你决定论文集合,文献库问答分析这个稳定集合。不要让探索报告悄悄变成最终文献综述。
常见问题
继续阅读
当你让 AI 寻找一篇根本不存在的论文,会发生什么?
我用五个故意编造的论文题目测试了这种失败方式。每个题目都像真的,也使用了真实研究词汇,但并非复制已有论文。我先在 Crossref 和 OpenAle…
AI Agent 能找到 Research Gap 吗?先这样检查它的答案
AI Agent 给出一句很漂亮的话:“很少有研究关注第一代大学生的长期变化。”听起来就是标准的 research gap。可“很少”也可能只是 Ag…
AI 能制作有用的文献矩阵吗?一次 10 篇论文测试
题目、年份、大致人群和文献类型通常容易提取。矩阵也很快呈现出范围差异:糖尿病研究、重度饮酒研究、系统综述和评论文章,不能悄悄与大学生试验并排,当成同类…