我让 AI 辅助比较三项面向学生的在线睡眠干预研究。两项较早研究报告了改善,一项较新的随机试验却发现,引导式项目在多数结局上并不显著优于主动数字教育对照。
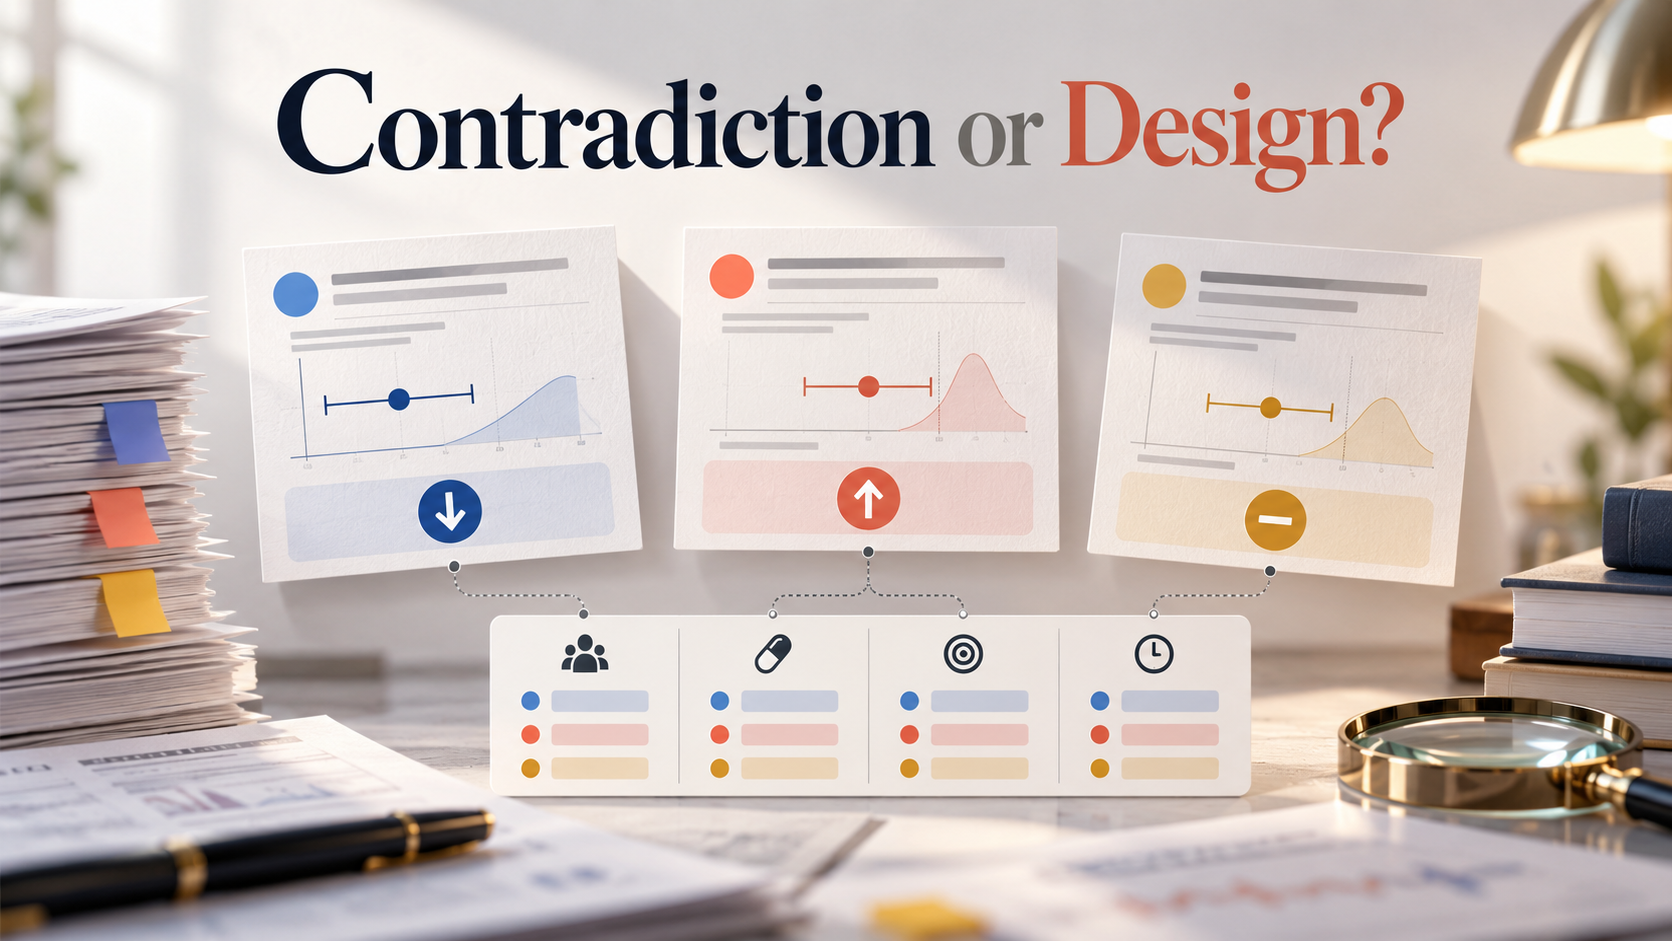
乍看之下,这是相互矛盾的结果。把人群、对照、结局和依从性放到一起后,它更像是研究设计不同。
这些论文看起来在争论什么?
一项 2015 年随机研究报告,完成互联网项目的学生睡眠质量获得中等改善。一项 2021 年研究发现,六次邮件 CBT-I 课程比学生健康网页带来了更好的睡眠相关结果。
2026 年试验则报告,引导式干预在主要失眠结局上并不显著优于对照。总结工具很容易把前两篇标为“正面”,把第三篇标为“负面”。
这种标签漏掉了关键设计:2026 年对照组包含睡眠监测、睡眠卫生、刺激控制、昼夜节律教育和时型反馈,比等待名单或普通健康网页积极得多;引导式干预的参与度也较低。
称为“矛盾”前,AI 应该比较什么?
让它建立一张矛盾检查表:
- 正在比较的精确主张
- 人群和纳入条件
- 干预剂量
- 对照内容
- 结局指标
- 测量时间
- 效应值与不确定性
- 依从性和缺失数据
只有两篇论文在足够相似的条件下提出无法同时成立的结论,才是真正冲突。“一项研究发现前后改善”和“另一项研究没有优于主动对照”完全可能同时为真。
这次小测试发现了什么?
AI 很擅长找到看起来方向相反的结论句,但需要更窄的提示词,才能解释这些句子为什么没有回答同一个比较。
有效的提示词是:
先不要把结论分成支持或矛盾。把每项结果改写为“人群 + 干预 + 对照 + 结局 + 时间点”,然后指出哪些元素不同。只有剩余主张无法同时成立时,才称为矛盾。
这样会把答案从语气匹配推进到真正的研究比较。
在 WisPaper 中比较证据集合
把论文保存到 My Library,通过 Library QA 追问:“哪些研究对在线睡眠干预给出了不同结论?它们是否使用相同对照和结局?”对于被标为分歧的论文组合,再打开方法和结果表核查。
WisPaper 可以帮助呈现比较,最终判断仍取决于这些研究是否真的问了同一个问题。
常见问题
一项研究报告组内前后改善,另一项报告组间没有差异。这是两种不同比较,可以同时正确。