
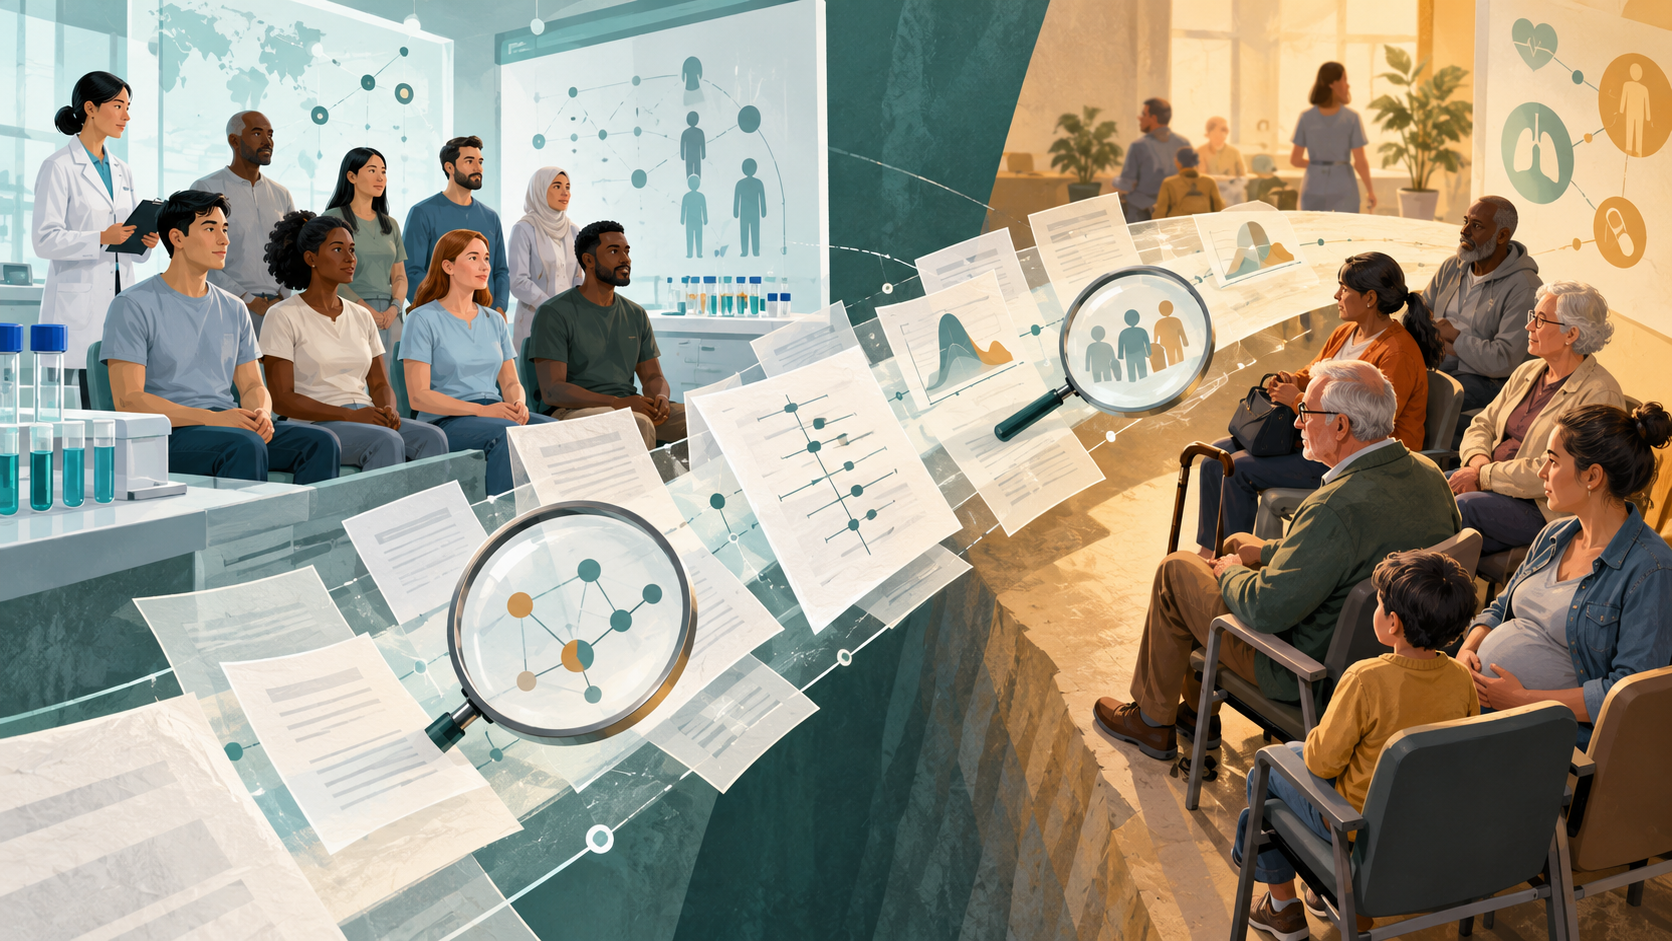
一个指南小组正在为一种常见慢性病起草推荐意见。主要试验规模大、随机化、被广泛引用。对主要结局的效应具有统计学显著性和临床意义。然后一位委员会成员提出了让会议停滞的问题:“我们的诊所人群比试验队列年龄更大、合并症更多、同时服用的药物更多。这些证据适用于他们吗?”
诚实的答案不是是或否。这是关于证据级别、适用性、间接性和研究局限性的结构化判断——这四件事常常被合并成一句话,比如“证据很强”。本文通过一个工作案例,展示证据摘要初稿错在哪里,并展示修正后的交付成果。最终得到的是一份可用于研究、指南制定或学术工作的适用性评价。
案例:聚焦的人群和结局
为了保持推理具体,严格固定问题。假设小组正在评价一项针对慢性病药物的随机试验,主要结局是固定随访期内复合临床事件。试验招募了符合明确资格标准的成人;小组的目标人群是在综合诊所就诊的成人,包括有多重疾病和多重用药的人。
一个聚焦的问题有五个部分:人群、干预、对照、结局和设置。小组的问题比“这种药物有效吗?”更窄。它是:在我们的诊所人群中,与常规护理相比,这种干预是否减少复合事件结局,以及试验结果中有多少能在试验队列与我们患者之间的差异中保留下来?
这种框架很重要,因为适用性是针对特定人群和结局来判断的,而不是抽象地判断。一项试验可以质量很高,但对特定诊所仍然只有部分适用性。
为什么“证据很强”不是答案
当摘要说证据很强时,通常意味着研究设计严谨,结果精确。这是关于内部有效性的陈述。它并不自动回答结果是否能转移到不同人群、设置或基线风险。
需要保持四个判断分开:
- 证据级别——研究如何设计以及它如何直接回答问题(例如,随机试验与观察性研究)。
- 适用性——试验的人群、设置、干预实施和结局与小组目标背景的匹配程度。
- 间接性——证据是否涉及与问题所问不同的人群、干预、对照或结局。
- 研究局限性——研究本身内的偏倚风险,例如随机化、盲法、失访或结局确定方面的问题。
一项试验可以有高证据级别和低适用性。它也可以直接适用但带有重要局限性。将这些合并成一个标签恰恰隐藏了小组需要的信息。
步骤1:从资格标准构建检索
证据摘要的初稿是基于在数据库中输入的单一检索字符串和少量熟悉的引用构建的。这是一个脆弱的起点。Cochrane关于检索的指南建议从资格标准规划检索,使用多个来源,并将自由文本词与主题词结合。
对于此案例,资格标准定义了人群(患有慢性病的成人,包括多重疾病)、干预、对照和结局。每个都成为一个检索概念。检索还应捕捉到重要的设置——例如,综合诊所与专科转诊人群。
一个实用的修复方法是先起草概念,然后将其翻译成数据库语法。这就是学术检索界面有帮助的地方:你可以运行概念块并检查返回结果,然后再确定筛选集。WisPaper的学术检索界面专为查找学术论文而构建,适合构建和测试检索的这一阶段。
步骤2:使用受控词汇捕捉自由文本遗漏的内容
仅自由文本检索会遗漏用不同词语描述同一概念的记录。NLM的医学主题词表提供了受控和分层的词汇:首选标题、入口词、范围注释、限定词和树位置可用于扩展或聚焦PubMed策略。
在实践中,这意味着检查人群概念是否有首选标题,是否应包括其下的更窄术语,以及限定词是否改变含义。这也意味着阅读范围注释,而不是假设标题意味着它听起来的意思。
PubMed自己的文档指出,检索细节揭示术语如何被翻译和组合。这是一个有用的审计步骤:运行检索后,检查翻译以查看你的术语是否按预期映射或被静默更改。
步骤3:记录过程并链接同一研究的多份报告
Cochrane指南还建议记录检索过程、去重记录、分阶段筛选,并链接一项研究的多份报告。这不是行政开销。在适用性评价中,同一试验可能作为主要报告、亚组分析和长期随访出现。如果这些被视为三项独立研究,证据基础看起来比实际更大、更一致。
分阶段方法有帮助:
- 记录检索日期、来源和确切字符串。
- 筛选前去重。
- 筛选标题和摘要,然后全文。
- 提取结果前按研究分组报告。
- 在最终确定前重新运行检索,如Cochrane所建议。
当小组需要组织纳入的报告并将主要试验、亚组论文和随访保持在一起时,图书馆工作区是自然的地方。WisPaper的我的图书馆允许你保存或上传论文并组织它们,这支持将一项研究的链接报告保持在一个地方。
步骤4:明确分离四个判断
研究集组装后,小组现在可以分别做出四个判断。一个简单的表格强制纪律:
| 判断 | 要问的问题 | 依据 |
|---|---|---|
| 证据级别 | 什么设计回答这个问题? | 研究设计和对问题的直接性 |
| 适用性 | 试验背景与我们的诊所多接近? | 人群、设置、基线风险、干预实施、结局定义 |
| 间接性 | 证据是否关于不同的人群、干预、对照或结局? | 问题与证据之间的不匹配 |
| 研究局限性 | 研究内什么可能使结果产生偏倚? | 随机化、盲法、失访、结局确定 |
为案例填写此表产生的摘要比“强证据”更有用。试验可能是随机设计(高证据级别),而人群比诊所更年轻、更健康(适用性担忧),结局可能是复合结局,其组成部分的权重与小组关心的不同(结局的间接性)。
步骤5:检查基线风险,而不仅仅是相对效应
最常见的适用性错误是从试验中取相对效应并将其应用于具有不同基线风险的人群。如果诊所人群的结局基线风险更高,相同的相对效应产生更大的绝对获益;如果更低,则更小。仅相对效应不能告诉小组预期什么。
因此,评价应记录试验的基线事件率以及小组对其自身人群的最佳估计,并说明每个所暗示的绝对差异。如果小组的基线风险不确定,说明这一点并显示范围。这比全盘导入试验的绝对数字更诚实。
步骤6:检查结局是否意味着相同的事情
复合结局可能隐藏分歧。如果试验的复合结局主要由一个组成部分驱动,而小组最关心另一个,结果可能看起来不如实际有信息量。评价应记录哪些组成部分驱动了试验结果,以及小组的优先结局是否得到代表。
同样,试验中实施的干预——剂量、监测、随访强度——可能与诊所所能提供的不同。这是适用性问题,不是研究局限性,它属于自己的一行。
步骤7:对组装的论文使用问答环节
一旦纳入的论文被组织好,小组通常有需要跨论文阅读的具体问题:排除标准是什么,对照组中的基线风险是什么,复合结局如何定义,哪些组成部分驱动了结果。通过重新阅读每个PDF来回答这些问题很慢。
对上传论文的问答步骤可以加速这一过程。WisPaper的图书馆问答支持基于上传到我的图书馆或从搜索结果添加的论文提问。在研究集组装后使用,它帮助小组定位为适用性表格提供信息的特定细节。
步骤8:在草稿传阅前验证引用
适用性评价引用密集。草稿可能引用主要试验、亚组分析、随访报告、方法学论文和几个背景参考文献。该列表中打错或捏造的参考文献会破坏整个文档。
引用筛选步骤在传阅前捕捉这一点。WisPaper的TrueCite检查BibTeX与真实学术数据库,以标记幻觉引用。在交付成果提交给小组之前,将参考文献列表通过该检查是一个具体的最后步骤。
修正后的交付成果
修复后的证据摘要看起来与初稿不同。它不是“强证据支持干预”,而是按顺序陈述:
- 问题,明确命名人群、干预、对照、结局和设置。
- 证据级别,说明设计以及它回答问题的原因。
- 适用性,将试验人群与诊所人群在年龄、合并症、多重用药和基线风险上进行比较。
- 间接性,命名人群、干预实施、对照或结局定义中的任何不匹配。
- 研究局限性,与适用性担忧分开列出。
- 绝对效应,显示试验的基线风险和小组估计的基线风险,并说明不确定性。
- 结论,说明预期有多少试验结果会转移,以及什么仍不确定。
这种结构让读者看到哪个判断驱动结论。它也使得评价可更新:如果出现新的亚组报告,它插入相关行,而不是强制重写。
可迁移的经验
此案例的几个经验适用于任何适用性评价:
- 检索前固定问题。 人群、干预、对照、结局和设置应首先写下来;检索随之而来。
- 保持四个判断分开。 证据级别、适用性、间接性和研究局限性回答不同的问题,不应合并成一个标签。
- 按研究分组报告。 一项试验的多份报告不是多项试验。
- 明确比较基线风险。 相对效应不会在具有不同基线风险的人群中不变地转移。
- 检查结局定义。 复合结局的组成部分权重与小组优先结局不同是间接性问题。
- 记录并重新运行。 在最终确定前重新运行记录的检索比一次性查询更可辩护。
对于跨越许多论文的较长评价,结构化研究工作区可以将问题、纳入的研究和提取的细节放在一起。WisPaper的研究项目区域支持为此类工作创建项目。
常见问题
继续阅读
最相关的论文被付费墙挡住:合法获取与诚实引用的可复现工作流
你正在起草一份手稿,而唯一最相关的论文却藏在付费墙后。摘要确认了这正是你需要的研究,但全文却被锁住了。诱惑在于:仍然引用它,转述摘要,然后继续。这种捷径会制造一个你无法辩护的引用和一个你无法验证的论断。 更好的路径是一个简短、可审计的序列:确认引用身份,寻求合法获取途径,定位替代版本,然后明确决定你实际持有的内容能让你得出什么结论、不能得出什么结论。本文通过一个具体的手稿案例走完这个序列,展示修复过程,并以修正后的交付物和可迁移到下一次
试验注册库与期刊论文:哪份记录回答哪个问题?
同一试验的注册库条目和期刊论文并非同一记录的两个版本。它们在不同时间、由不同人员、为不同目的而产生。注册库条目在结果出现之前撰写,描述研究者计划做什么。期刊论文在数据齐备之后撰写,描述实际做了什么和发现了什么。当你回答一个聚焦的证据问题时——为指南、系统评价或学术论证——有用的做法是将它们作为一对来阅读:比较计划结局和方法与报告的分析和结果,然后调和任何不一致之处。 本文为该项任务设定一个实用的比较,使用一个贯穿始终的示例,并展示每种记
两位评审员对纳入哪些研究意见不一:在截止日期前修复筛选决策
你有一篇周五截止的课程论文,一份奖励可辩护方法部分的评分标准,以及两位评审员对同一批摘要给出了相反结论。一位说某项研究应纳入综述;另一位说不应纳入。分歧不是性格冲突。它是一个信号,表明你的纳入标准规定得不够具体,而且除非你现在就修复流程,否则它会在写作中再次浮现。 本文介绍一种具体的修复方法:重新审视标准、用示例进行校准、记录原因、解决模糊案例,并保留审计轨迹。文章最后给出一个你可以向导师辩护的提交决策。