“AI 科学家”听起来像是:周一把研究问题交给系统,周五回来领取一项发现。现在的系统确实有用,但实际能力比这个想象窄得多。
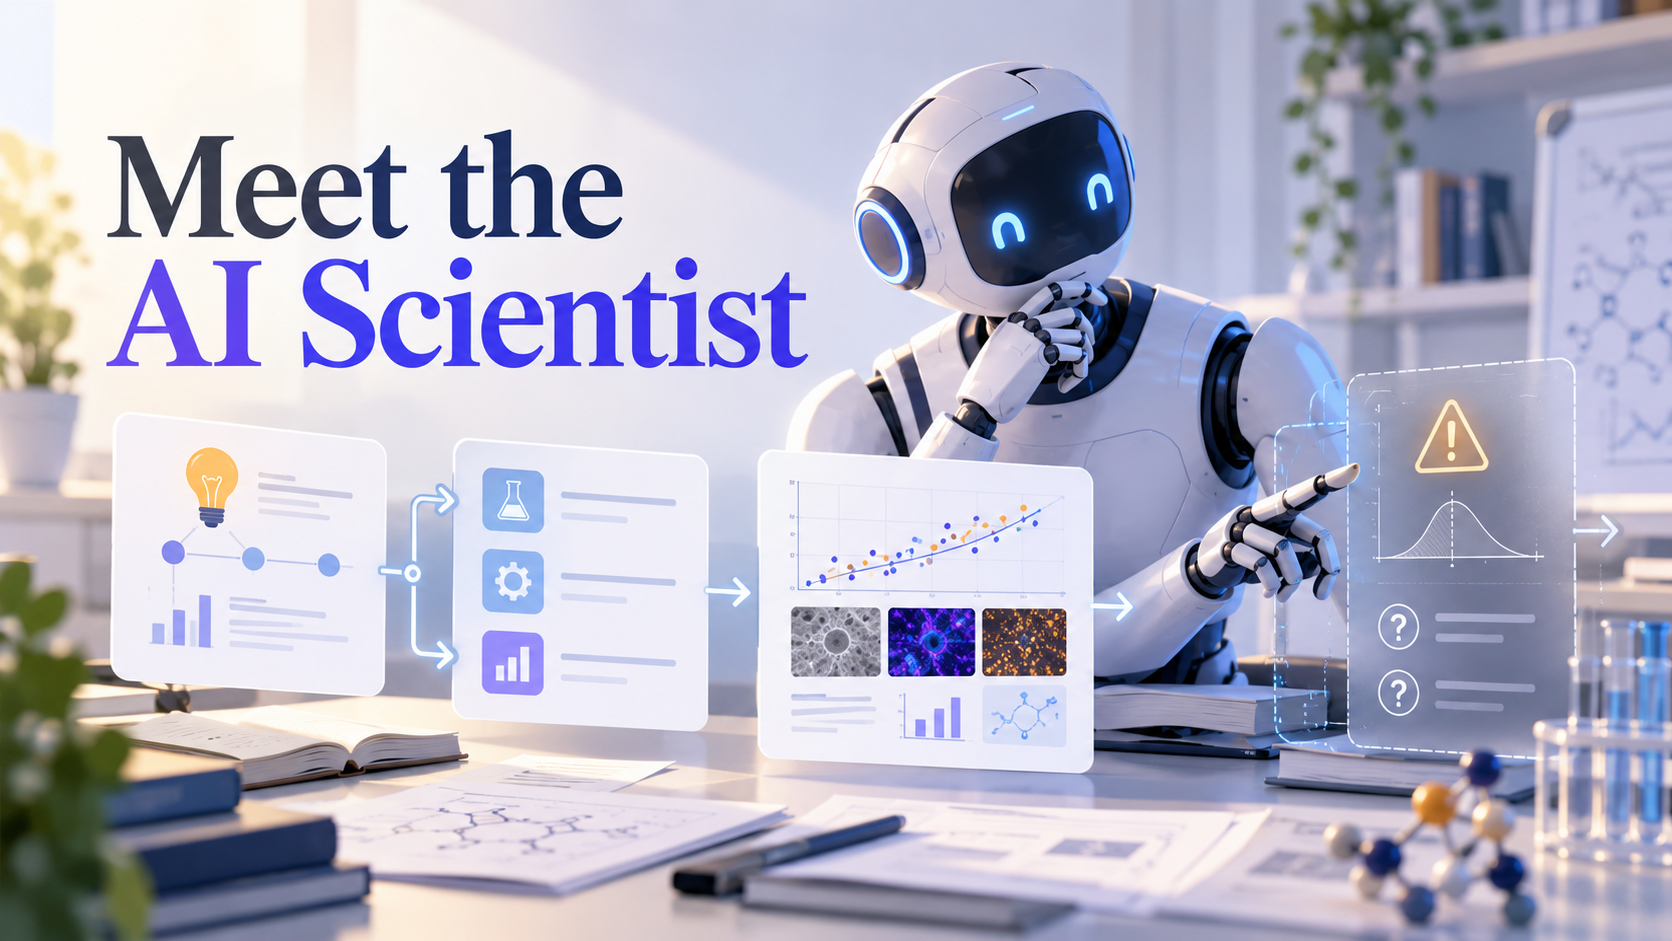
AI Scientist 通常指一种能够尝试串联多个研究环节的智能体系统,而不是只回答一次提问。它可能搜索文献、提出假设、编写和运行代码、评价结果、批评候选想法,再生成报告。关键在“尝试”:流程可以自动化,不代表每个科学判断都可靠。
它和普通聊天机器人有什么区别?
聊天机器人通常按一轮问题给一轮回答。研究 Agent 会规划并执行多步信息任务。AI Scientist 更进一步,试图把构思、实验、分析和评价连成一个循环。
例如,最初的 AI Scientist 在机器学习研究中展示了生成想法、修改代码、运行实验、制作图表、撰写论文和自动评审的流程。Google DeepMind 的 AI Co-Scientist 则让不同 Agent 生成、辩论、排序和改进假设。
这些都是值得关注的研究系统,但不能由此推断,一个通用工具已经能够独立完成任何博士课题。可以执行代码的计算基准,与田野调查、湿实验、档案解释或涉及人类参与者的研究完全不同。
它现在能帮博士生做哪些事?
最适合交给它的,是边界清楚、结果可以检查的任务:
- 把宽泛问题拆成几个可检验假设
- 为每个假设寻找支持与反对证据
- 提出相互竞争的解释
- 起草分析代码或实验计划
- 在受控环境中运行计算实验
- 列出假设条件和失败情形
- 从不同学科角度批评研究方案
可以把它看成一个速度很快的研究工作坊。它能在一次会话里产生很多候选方向,而你要判断哪些方向有意义、可执行、符合伦理,也真正进入了这个领域的学术对话。
哪些判断不应该交出去?
不要让系统独自决定一个想法是否新颖。对自动研究系统的独立评价已经发现,系统可能把已有概念误判成创新。新颖性取决于检索覆盖、最新文献、领域术语和专家背景。
以下责任也应该留在人手里:
- 选择值得研究的问题
- 审批实验或参与者风险
- 判断方法是否真的回答问题
- 解释意外结果
- 核查数据来源和分析
- 处理作者身份与 AI 使用披露
Agent 可以模拟批评,但不能为错误研究承担责任。
给它一个工作包,而不是“替我完成博士论文”
一个可执行的任务通常包含五部分:
- **问题:**要调查的准确问题
- **证据边界:**来源、年份、领域和排除项
- **交付物:**假设表、检索记录、代码或批评报告
- **检查项:**引用、反面证据、假设条件和停止规则
- **人工节点:**必须留给你决定的部分
例如:
请为某模型在低资源语言上表现不佳提出三种解释。分别寻找 2022 年以来的支持和反对研究,使用我们现有数据集设计一个计算测试,列出必要假设,并在运行代码前停止。
这个任务会产生可以审核的结果。“帮我找一个全新的博士课题”则不会。
WisPaper 可以支持哪一段?
可以用 WisPaper Search 为候选方向建立证据集合,再把相关论文存进 My Library。面对较长的探索任务时,Scholar Agent 可以帮助展开研究方向;任何看起来有价值的主张,都应回到论文集合,并通过 Library QA 继续核对。
真正有价值的交接,是把 Agent 产生的可能性变成研究者核实过的证据。少了这一步,更高的自主性只会产生一条更长的未检查决策链。