
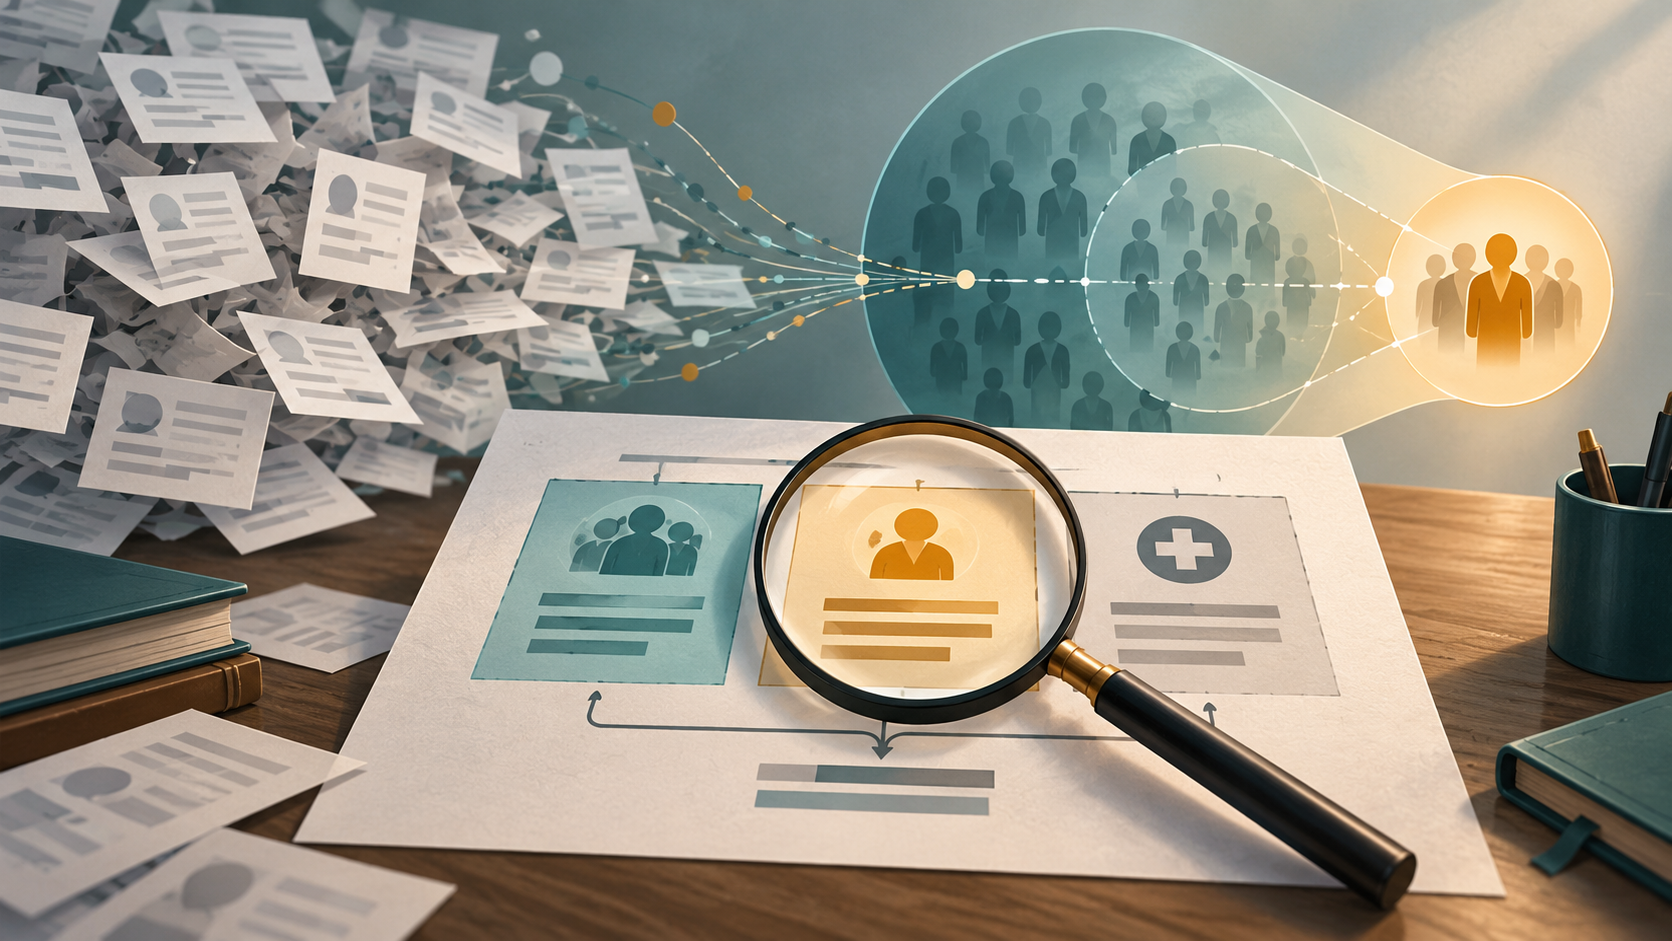
检索返回错误的患者人群通常不是数据库故障,而是翻译问题。PubMed可能将自由文本词映射到覆盖范围比你的纳入标准更广或定义不同的MeSH标题,也可能将人群词与字段或过滤器组合,从而引入相邻人群。修复方法是诊断性的:阅读术语如何被翻译,将人群概念与结局概念分开,明确测试排除条件,并记录检索干净后仍存在的间接性。
本文通过一个聚焦示例来演示修复过程:一个成人人群与特定结局,第一次检索不断出现儿科队列、混合年龄队列以及结局仅为替代指标的研究。目标是形成可辩护、有记录的检索,为研究、指南制定或学术工作提供依据。
起始问题:检索回答了不同的问题
假设问题关于患有特定疾病的成人及特定临床结局。第一条PubMed检索行是通俗语言字符串:疾病名称、同义词和结局。它返回大量结果。筛选时,三个问题反复出现:
- 尽管问题关于成人,却出现儿科和青少年研究。
- 出现混合年龄队列,其中成人亚组未单独报告。
- 出现测量相关但不同结局的研究,因此结局仅间接相关。
每种都是不同类型的错配,需要不同的修复。儿科研究是人群错配。混合年龄队列是人群模糊性。替代结局是结局间接性。将三者都视为“噪声”掩盖了检索策略(而非文献)造成了部分问题的事实。
第1步:阅读PubMed如何翻译你的术语
PubMed支持字段标签、短语检索、过滤器、高级检索、保存的检索、相似文章、引文查找以及可用时全文链接。关键的是,检索详情揭示了术语如何被翻译和组合。该翻译视图是第一个诊断工具,因为自动术语映射可能将自由文本词转换为范围比你预期更广的MeSH标题。
打开检索详情并检查三件事:
- 哪些术语映射到MeSH标题。 一个简单的疾病名称可能映射到范围注释覆盖更广疾病家族的标题。
- 哪些术语保持为自由文本。 未映射的同义词作为文本检索,在不同记录中可能表现不一致。
- 概念如何组合。 确认你的人群和结局术语是否按预期连接,以及是否有过滤器悄悄缩小或扩大了结果集。
如果翻译显示一个宽泛标题代替了你狭窄的人群,你就找到了错误人群结果的可能来源。在更改任何内容之前记录映射,以便修订可追溯。
第2步:有意识地使用MeSH,而非自动使用
MeSH是NLM用于索引和检索生物医学信息的受控且分层的词汇表。首选标题、入口词、范围注释、限定词和树位置可用于扩展或聚焦PubMed策略。这种层级正是MeSH强大的原因,也是意外扩大范围的可能原因:一个标题位于树中,检索它可能触及该节点索引的记录,并且取决于检索方式,还可能触及相关节点。
对于聚焦的人群问题,以三个有意识的动作使用MeSH:
- 阅读范围注释。 范围注释告诉你标题实际覆盖什么。如果它包括你纳入标准之外的年龄组,仅靠标题无法强制你的人群。
- 检查入口词。 入口词显示映射到标题的同义词。它们解释了你输入的同义词为何可能拉入更广的结果集。
- 使用限定词和树位置来聚焦。 限定词和更具体的树位置可以将标题缩小到你需要的概念,而非接受默认广度。
Cochrane的指南与此一致:从纳入标准规划检索,将自由文本词与主题词结合,而非单独依赖任一。MeSH提供受控召回;自由文本捕捉索引不完整或术语不同的记录。
第3步:将人群、结局和研究设计分成块
单一扁平字符串难以看出哪个概念导致了坏结果。将策略构建为概念块:人群、结局,以及——如果你的问题需要——研究设计。然后你可以单独测试每个块。
对于成人人群示例,人群块应同时包含MeSH标题和自由文本同义词,并在数据库支持时包含明确的年龄概念。结局块应包含结局的首选标题、其入口词以及作者实际使用的自由文本短语。保持块分离让你在结果看起来错误时能问一个精确的问题:是人群块纳入了错误组,还是结局块纳入了替代指标?
这也是字段标签发挥作用的地方。字段标签让你将术语定向到特定字段,而非让它漂浮在记录中。当同义词在纯文本中有歧义时,字段标签可以减少它匹配无关上下文的机会。
第4步:将排除作为假设测试,而非条件反射
添加NOT子句感觉像修复,但排除可能移除相关记录,并可能与术语映射方式产生不良交互。测试每个排除,而非堆叠它们。
实用顺序:
- 单独运行人群块并检查它检索到什么。
- 添加结局块并比较。
- 一次添加一个排除,检查什么消失了。
- 确认排除集仅包含你真正打算排除的记录。
对于年龄问题,人群块内的明确年龄概念通常比在儿科标题上使用宽泛NOT更可辩护,因为NOT可能剔除报告成人亚组的混合年龄研究——正是聚焦问题可能需要的记录。记录你保留了哪些排除及原因,以便读者看到排除是经过测试而非假设的。
第5步:区分证据级别、适用性、间接性和研究局限性
当结果仍包含不完美匹配时,精确命名不完美之处。这四个概念不可互换:
- 证据级别描述针对该问题的证据体的设计和强度。
- 适用性询问证据是否适合你的环境、人群和决策背景。
- 间接性描述现有证据与你的确切问题相距多远——不同人群、替代结局或相邻比较。
- 研究局限性是研究内部的弱点,例如队列如何组建或结局如何测量。
儿科研究不是你检索的“局限性”;它是为成人问题创造间接性的人群错配。未单独报告成人亚组的混合年龄队列是人群模糊性。替代结局是结局间接性。保持这些标签分开,防止将干净的检索描述为好像解决了它无法解决的间接性。
第6步:记录策略和剩余间接性
Cochrane建议记录检索过程,使用多个来源,去重记录,分阶段筛选,链接同一研究的多份报告,并在发表前重新运行检索。将同样的纪律应用于人群问题。
至少记录:
- 最终概念块及其MeSH标题、入口词、自由文本同义词和字段标签。
- 最终字符串的翻译视图,以便映射可见。
- 每个经过测试后保留的排除,及其保留原因。
- 应用的过滤器及其对结果集的影响。
- 关于剩余间接性的简短陈述:哪些人群或结局仍相邻而非精确,以及为何保留或搁置它们。
最后一项是最常缺失的交付物。检索可以技术上正确,但仍依赖间接证据。明确说明这一点是方法的一部分,而非最后附加的注意事项。
WisPaper在工作流程中的位置
WisPaper是一个AI研究助手,用于查找、筛选、组织和使用学术论文。在此工作流程中,它支持特定步骤,与上述PubMed诊断配合使用。
- 当你想扩展到单一数据库之外时,使用WisPaper检索通过其学术检索界面查找学术论文,然后将它呈现的内容与你记录的PubMed块进行比较。
- 当修复变成更长的文献任务——构建概念块、比较候选研究、起草方法段落——Scholar Agent区域支持文献综述和相关研究任务。
- 随着记录在修订中累积,在My Library中保存和上传它们,以便人群和结局决策与其涉及的论文保持关联。
- 一旦候选集进入你的图书馆,使用Library QA基于那些上传的论文或从检索结果添加的论文提问,这有助于你检查保留的研究是否实际报告了成人亚组或确切结局。
每一项都支持你原本需要手动完成的步骤;它们与你亲自阅读翻译视图和测试排除的工作相辅相成。
修正后的交付物
修复后的检索不仅仅是一个新字符串。它是一个简短、可审计的包:
- 块结构策略,人群、结局和任何设计概念保持分开。
- 翻译记录,显示哪些术语映射到MeSH,哪些保持为自由文本。
- 经过测试的排除列表,每个排除都有理由。
- 过滤器日志,描述每个过滤器对结果集做了什么。
- 间接性陈述,命名仍相邻而非精确的人群和结局。
有了这个包,读者可以看到为何出现儿科和混合年龄记录,为何保留或丢弃替代结局研究,以及证据仍不能直接回答什么。
可迁移的经验
- 先诊断再重写。 翻译视图告诉你映射或组合是否导致了错误人群。
- 使用MeSH时打开范围注释。 层级是特性;未检查的广度是风险。
- 将概念保持在块中。 分离的块使隔离纳入错误记录的概念成为可能。
- 测试每个排除。 NOT子句是关于你不需要什么的假设;验证它。
- 精确命名间接性。 人群错配、人群模糊性和结局间接性是不同发现,具有不同含义。
- 记录残留。 剩余间接性是结果的一部分,而非事后想法。
常见问题
继续阅读
参考文献列表标题、年份和DOI冲突:稿件修复工作流
一份自相矛盾的参考文献列表是个小问题,但影响范围很大。一条条目说论文发表于2019年;DOI却解析到2020年的版本。合著者的BibTeX文件给出的标题与出版商页面略有不同。审稿人标记了一条引用,它似乎指向两篇不同的文章。在重新提交之前,你需要知道哪条记录是权威的,哪些字段只是错误的,以及哪些冲突是真实存在且必须披露的。 本指南将这一修复过程作为一个可审计的流程来介绍:从冲突开始,解析标识符,比较出版商存储的元数据,纠正明显错误的内容,
你的研究团队将同一批论文保存了五次:清理共享文库而不丢失证据链
一个在稿件草稿、修订和基金摘要中不断增长的共享文库很少会大声报错。它悄无声息地出错:同一项随机试验以预印本、会议摘要和最终期刊文章的形式出现;两位共同作者以不同标题保存了相同的 DOI;一篇综述的参考文献列表被整体导入,连同其引用的原始研究。当你最终为方法部分进行计数时,数字是错误的,而且没有人能重建原因。 本文为一个准备稿件及其证据摘要的研究团队,逐步演示针对这种情况的具体修复过程。目标不是为了一尘不染的文库本身。目标是一个可辩护的结
导师说你的文献太旧:如何更新?
“你的文献太旧了”是学生收到的最常见也最令人困惑的反馈之一。这很少意味着每一条引用都是错的。更常见的情况是,审阅者无法看出你的基础仍然有效,并且你已经考虑了自那以后发生的变化。解决办法不是删除旧参考文献,然后随便抓取最新的 PDF。解决办法是将模糊的评论转化为一个有日期范围、有边界的更新检索:保留那些奠定领域基础的研究,找到此后出现的证据,并在正文中解释新工作改变了什么。 本指南通过一个具体案例来演示这种修复:一名学生在截止日期前完成课