
DIVER:强化扩散模型,突破端到端自动驾驶的模仿瓶颈
2507.04049v3
本文提出了 DIVER,一个结合 Diffusion 生成模型与强化学习(RL)的端到端自动驾驶(E2E-AD)框架。通过引入策略感知扩散生成器(PADG)和 GRPO 算法,DIVER 成功突破了传统模仿学习在多模态轨迹规划中的“模态崩溃”瓶颈,在 Bench2Drive、NAVSIM 和 nuScenes 等多个基准测试中达到了 SOTA 性能。
TL;DR
传统的自动驾驶模仿学习(IL)正如同一名“死记硬背”的学生,只能机械地模仿专家留下的单一路径。DIVER 通过引入**扩散生成模型(Diffusion Models)提供“灵感”,并利用强化学习(GRPO)**作为“导师”进行安全纠偏,彻底解决了规划中的模态崩溃(Mode Collapse)问题。在 Bench2Drive 和 NAVSIM 等严苛测试中,DIVER 在安全性、多样性和成功率上均显著超越了现有 SOTA 方法。
1. 痛点:为什么模仿学习会“扼杀”多样性?
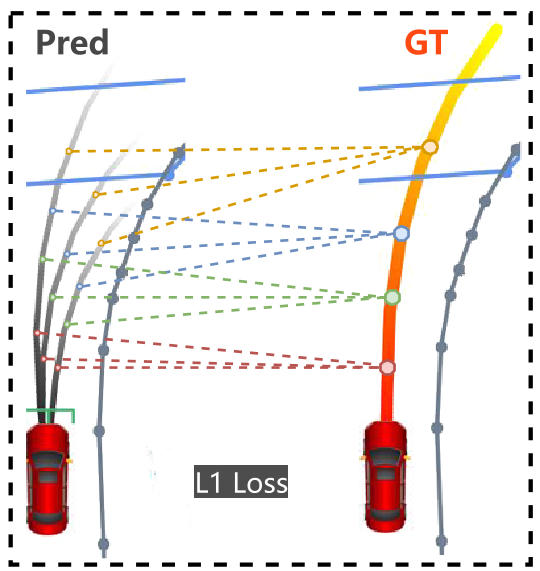
现有的端到端自动驾驶模型(如 UniAD, VAD)大多基于模仿学习。其核心逻辑是:最小化预测轨迹与专家真实轨迹(Ground Truth, GT)之间的 L2 距离。
然而,论文通过数学推导指出,当数据集中每个场景只提供一个 GT 时,模型的概率分布会退化为一个狄拉克函数(Dirac delta)。这意味着:无论扩散模型有多强的生成潜力,一旦只受单一 GT 监督,它最终生成的 6 条甚至更多的轨迹都会坍缩在 GT 周围。 在遇到十字路口左转还是直行的两难抉择时,这种模型往往会因为模态崩溃而表现得犹豫不决或极度保守。
2. 核心方案:PADG 与强化的联手
DIVER 的架构由两个核心模块驱动,旨在将“生成多样性”与“任务安全性”解耦优化。
2.1 策略感知扩散生成器 (PADG)
PADG 不再只是单纯的噪声还原,它引入了环境约束。它通过一个双分支架构:
- 一支学习重建预测轨迹的分布;
- 另一支对专家轨迹进行建模。
模型引入了 TrajPooler 模块(如下算法所示),它并不全盘接收图像特征,而是根据预测轨迹的路径,“点对点”地从 BEV 特征图中聚合信息。这种注意力机制让模型能够只关注那些“关乎生死”的环境局部细节。
2.2 强化学习引导 (GRPO)
为了让生成的 6 条轨迹不仅“长得不一样”,而且“每一条都得好”,作者采用了 GRPO(Group Relative Policy Optimization) 算法。
与传统的 PPO 相比,GRPO 能够在一个组内(即多模态轨迹组)计算相对优势。DIVER 设计了四个维度的奖励函数(Rewards):
- 多样性奖励 ():惩罚那些重合度高的轨迹。
- 安全奖励 ():引入偏微分避障成本。
- 一致性奖励 ():确保前后帧操作平滑,不乱打方向盘。
- 车道偏离奖励 ():惩罚无意义的变道。
3. 实验战绩:多维度的霸榜
DIVER 在多个主流榜单上展示了统治级的性能:
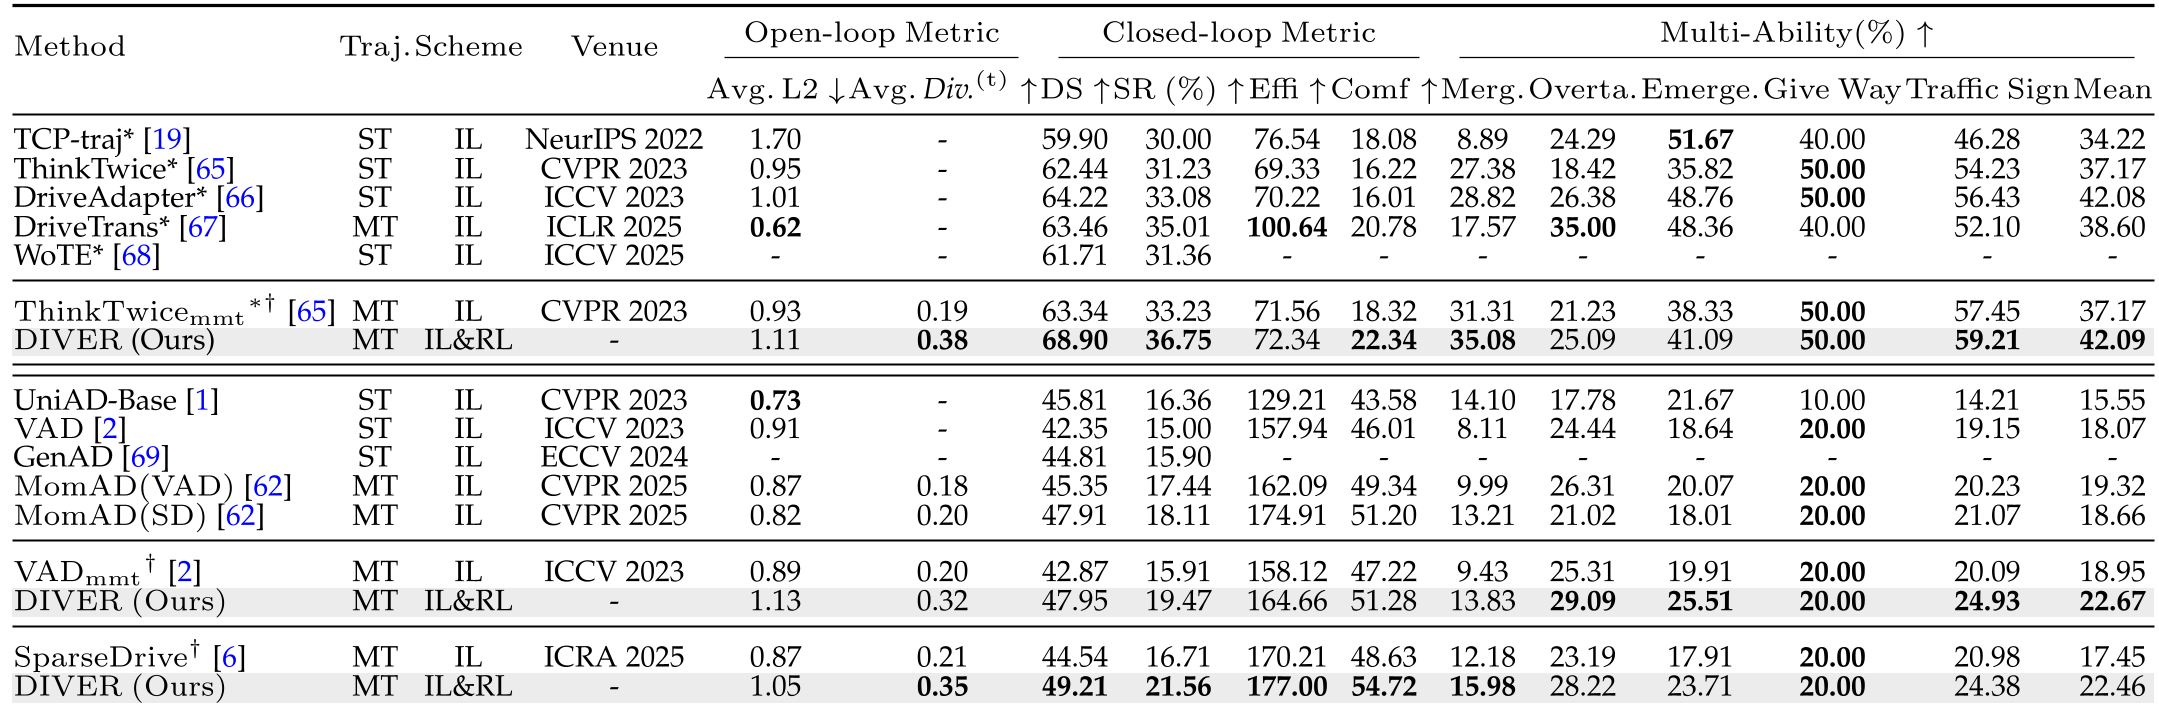
- Bench2Drive (闭环测试):
- 成功率提升 29.0%,且在“超车(Overtaking)”和“紧急制动(Emergency Brake)”等高难度操作上得分最高。
- NAVSIM:
- 在 PDM 指标上达到 88.3。
- 抗干扰与长时规划:
- 在恶劣天气(雪、雨、雾)下,碰撞率保持在最低水平;
- 在长达 6 秒的预测周期内,其轨迹多样性优势依然显著。
4. 深度洞察:为什么 DIVER 有效?
为什么单纯堆算力或改 Transformer 结构无法解决问题,而 DIVER 做到了?
本质上,DIVER 承认了“模仿”的局限性。在自动驾驶中,专家的行为只是“解空间”中的一个点,而强化学习赋予了模型探索该点周围安全区域的能力。通过 (匹配损失)和 RL 的结合,DIVER 允许 6 条轨迹分别向“左转”、“直行”、“减速”等多个合理的物理模态对齐,而非强制全部拟合到唯一的专家点上。
5. 总结与未来
DIVER 证明了“扩散+强化”这对组合在端到端驾驶中的巨大潜力。它不仅解决了模态崩溃,还提升了系统在面对罕见长尾场景(如对抗性干扰)时的鲁棒性。
局限性:尽管轨迹生成的多样性得到了保证,但如何在复杂的动态博弈中进行最终的“最优轨迹选择(Selection)”仍然依赖于后处理打分,未来的研究方向可能是将 VBM(视觉大模型)融入决策层,实现真正的类人逻辑。
本文基于 arXiv 论文 《DIVER: Reinforced Diffusion Breaks Imitation Bottlenecks in End-to-End Autonomous Driving》 编写。