
[Honor & 复旦] MagicAgent:打破 100B 迷思,通用 Agent 规划新 SOTA
2602.19000v1
本文推出了 MagicAgent 系列大模型(包括 32B 稠密版和 30B MoE 版),旨在通过统一框架解决智能体泛化规划难题。核心方法涵盖了轻量级可扩展的合成数据生成框架以及集成了监督微调(SFT)与多目标强化学习(RL)的两阶段训练范式,在 Worfbench 和 BFCL-v3 等多个主流 Agent 榜单上取得了超越 GPT-4o 和 DeepSeek-V3 的 SOTA 成就。
TL;DR
在 Agent 领域,"规划"(Planning)一直是从被动文本处理器迈向主动智能体的天堑。近日,荣耀(Honor)联合复旦大学推出了 MagicAgent 系列模型。通过创新的合成数据框架和名为 χPO 的强化学习算法,MagicAgent-32B 在多个核心 Agent 指标上横扫 sub-100B 模型,甚至在函数调用和逻辑编排上超越了 GPT-4o 等顶尖闭源模型。
痛点深挖:Agent 训练的“跷跷板效应”
为何现有的 LLM 在处理复杂 Agent 任务时依然显得力不从心?作者指出两个核心矛盾:
- 数据孤岛与稀缺性:开发者往往针对单一场景(如工具调用)优化,缺乏覆盖“任务分解 -> 工具选型 -> 执行监控 -> 动态纠偏”全链路的高质量数据。
- 多任务干扰:Agent 需要同时学习严谨的逻辑编排(DAG 结构)和灵活的自然语言调度。简单的多任务混合训练会导致“跷跷板效应”——由于梯度方向不一致,模型往往顾此失彼。
Methodology:MagicAgent 的双重炼金术
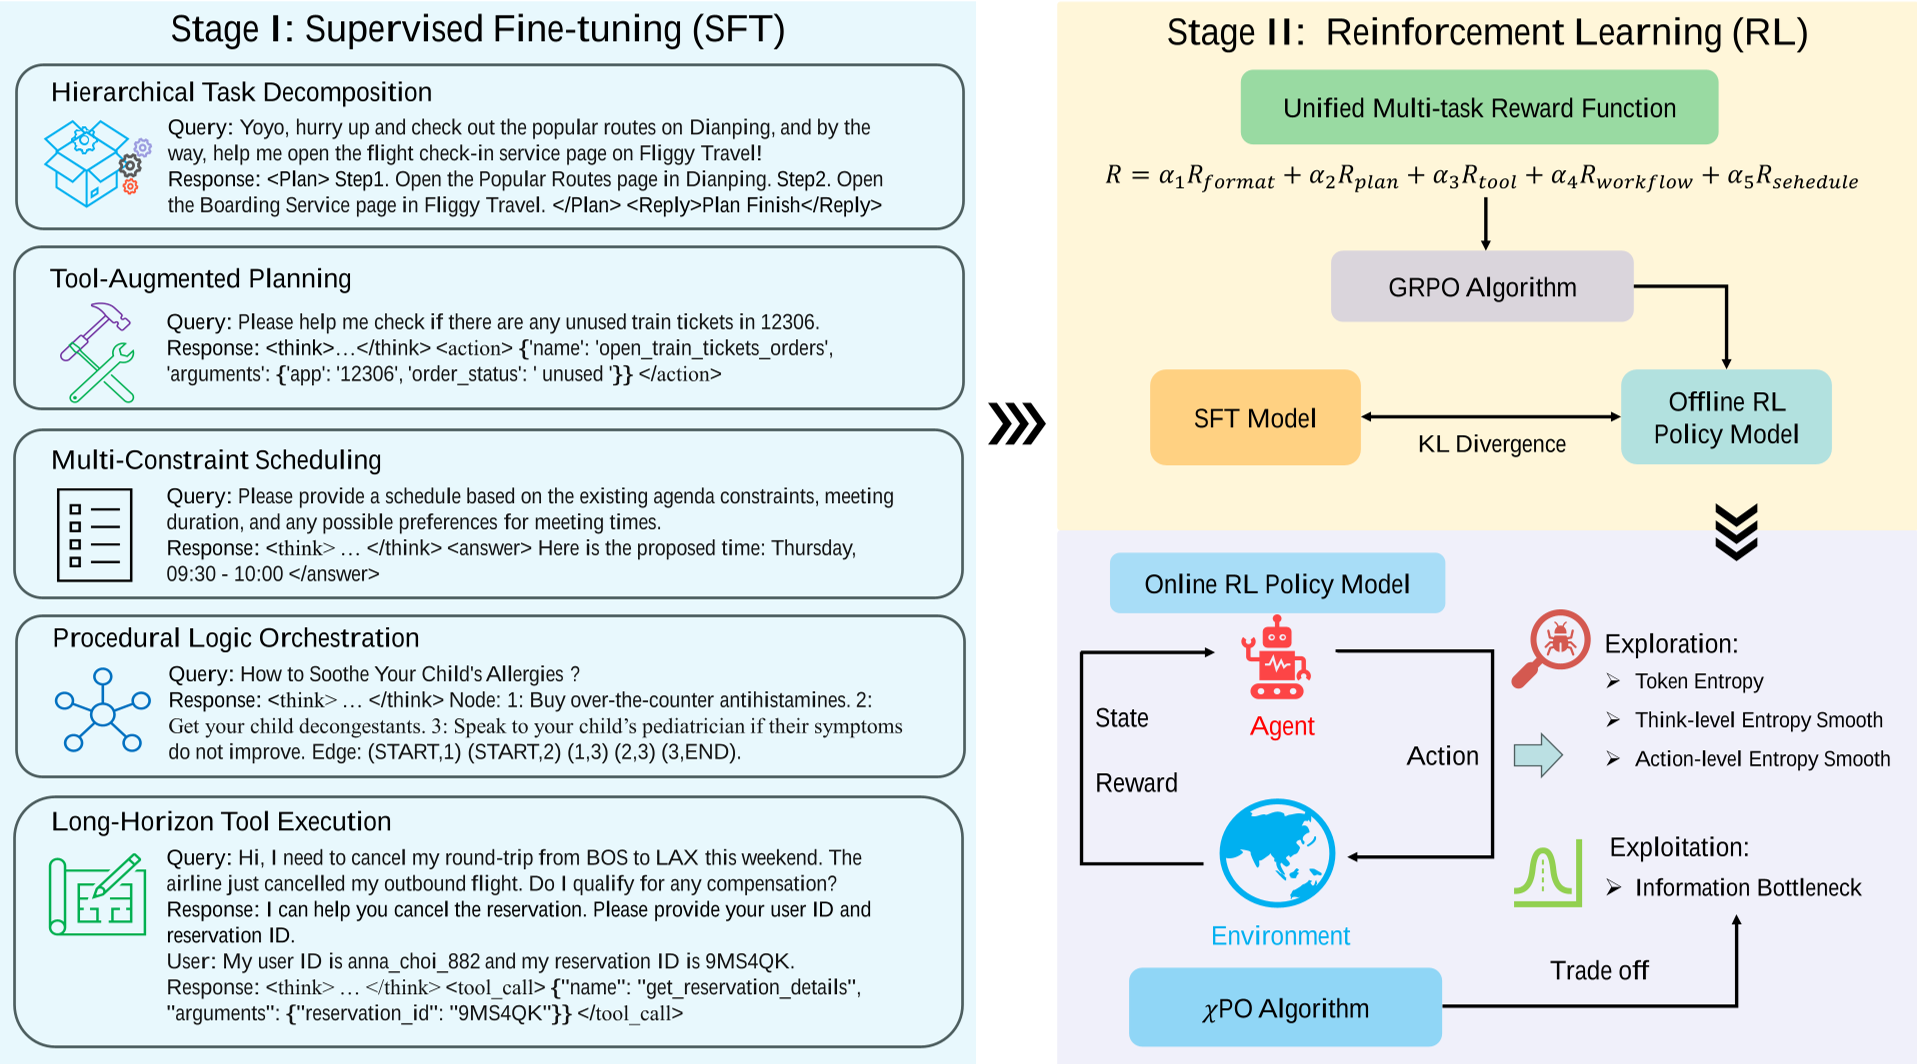
1. 五维合成数据流水线
MagicAgent 不再依赖昂贵的人工标注,而是构建了一套自动化的“数据工厂”,涵盖:
- 层次化任务分解 (Hierarchical Decomposition):将复杂意图拆解为原子 API 调用。
- 工具增强规划 (Tool-Augmented):引入 API 模拟器,构建 (Reasoning + Acting) 的轨迹。
- 多约束调度 (Multi-Constraint):将行程规划等建模为 CSP 问题生成数据。
- 逻辑编排 (Logic Orchestration):利用 DAG 结构处理分支逻辑。
- 长程执行 (Long-Horizon):强化模型在多轮对话中的状态追踪能力。
2. χPO:平衡探索与利用的强化学习
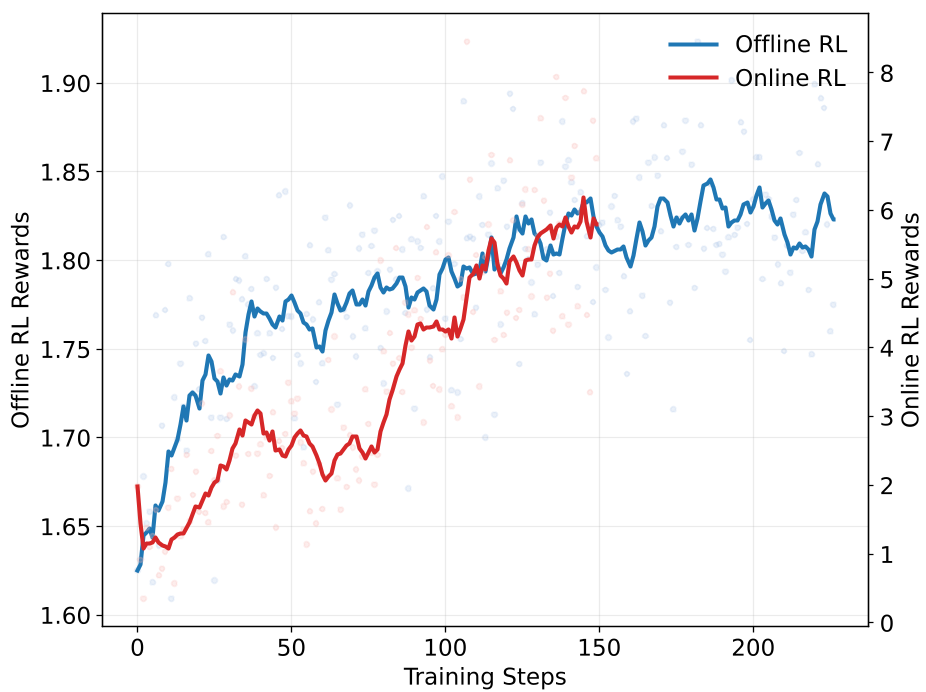
在强化学习(RL)阶段,作者提出了 χPO (eXploration-eXploitation Policy Optimization)。其物理直觉在于:
- 思考级熵正则项:在模型“思考”阶段(
<think>标签内)允许更高的随机性,鼓励生成多样的推理路径。 - 动作级熵约束:在最终“动作”生成时实施更严格的约束,确保决策的果断性。
- 信息瓶颈 (Information Bottleneck):剔除冗余推理,只保留对决策最有助益的信息。
实验与结果:小模型也能有大智慧
在多项严苛的 Benchmark 下,MagicAgent 展示了极强的统治力:
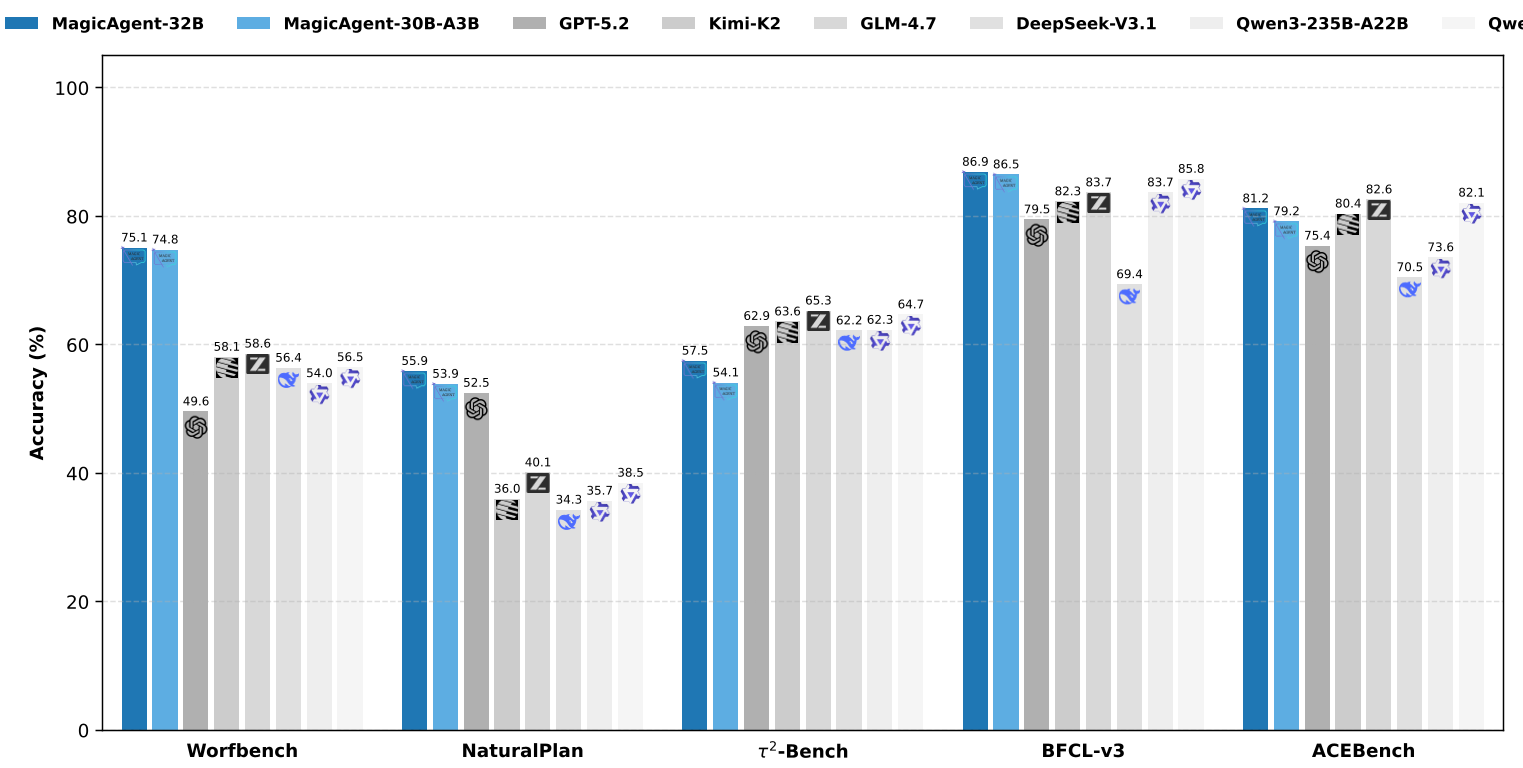
- BFCL-v3 (函数调用):MagicAgent-32B 准确率达 86.9%,显著领先 GPT-4o 的 66.9%。
- NaturalPlan (自然语言规划):在复杂的行程与会议安排任务中,MagicAgent 以 55.9% 的准确率甚至压制了同门“巨无霸” Qwen3-Max。
- 消融实验验证:实验证明,如果不采用 CHI-PO 的熵平滑机制,模型在长程任务(τ2-Bench)中极易陷入循环或崩溃。
深度洞察:MoE 系列的端侧潜力
值得注意的是,MagicAgent 的 MoE 版本(30B-A3B)在保持同等性能的同时,推理延迟降低了近一倍。这对于像荣耀这样的终端厂商至关重要——它意味着强大的 Agent 规划能力可以被真正部署到手机端侧,由模型自主控制 Intent-Routing(意图路由),实现真正的个人智能助理。
总结
MagicAgent 的成功告诉我们:Agent 能力的本质不在于参数量的无限堆砌,而在于数据结构的严谨性与训练目标的多样性平衡。通过 χPO 算法对推理过程的微观调控,MagicAgent 为我们展示了一个具备常识推理、工具调用和多步骤规划能力的智能体雏形。
局限性:虽然目前在文本逻辑规划表现优异,但针对多模态环境下的具身智能(Embodied AI)反馈闭环仍有待进一步结合。