
双潜在空间世界模型:把「长程选路」和「局部走准」拆给两套几何
2609.37644.pdf
本文提出 Dual-Latent World Model(Dual-WM),用两套彼此独立的状态表示与动力学模型分别承担局部执行与长程规划:低层模型建模细粒度动作条件转移,高层模型在学习的 macro-action 上做时间跨度更长的规划。配套的 LoRe 训练机制在两层都用指数衰减的地平线权重监督自生成 rollout。在五个目标条件视觉控制任务上,Dual-WM 在 goal offset 50 和 100 处的平均成功率分别从 75.9% 提升到 84.4%、从 61.4% 提升到 69.5%。
TL;DR
潜在世界模型长期受困于一个反直觉的事实:短期预测越准,长程规划不一定越好。Dual-Latent World Model(Dual-WM)把这一问题归因于两种独立失效机制——递归 rollout 的误差累积,以及高维潜在空间中距离向维度相关基线集中导致的远距离候选不可分——并提出按时间角色切分表示与动力学:低层模型管细粒度动作条件转移,高层模型在学习的 macro-action 上做粗粒度选路。训练侧用 LoRe 在两层以不同指数衰减率监督自生成 rollout,推理侧用三阶段 coarse-to-fine 规划串联两者,且不需要任何从高层到低层的逆映射。在五个目标条件视觉控制任务(含离散动作的 Sokoban-Long)上,goal offset 50 与 100 的平均成功率从 75.9% 提升到 84.4%、从 61.4% 提升到 69.5%,offset 100 处相对 LeWM 平均提升 30.8 个百分点。
背景定位
这是一篇典型的「结构性修补 + 刷新 SOTA」型工作,而不是开坑之作。它的出发点是:flat world model(如 LeWM、DINO-WM、PLDM)把预测精度当做唯一抓手,分层模型(HWM、Hi-LeWM)通过压缩 rollout 深度来缓解误差累积,但只要这些方法仍保留共享的潜在状态接口,局部执行和长程目标评估就仍共用一套几何。判断依据来自 Table 2:作者列出 LeWM(单一状态空间、one-step 训练)、HWM(跨尺度共享状态空间、均匀权重 rollout)、Hi-LeWM(共享且低层冻结、one-step waypoint)与 Dual-WM(跨尺度分离状态空间、尺度专属衰减 rollout)的对照。Dual-WM 的推进点不在于更强的预测器,而在于「状态空间本身是否应该只有一个」。
问题与动机
论文把长程规划的失败拆成两个可分别度量的机制,这一点比笼统地说「长程效果差」要有力得多。
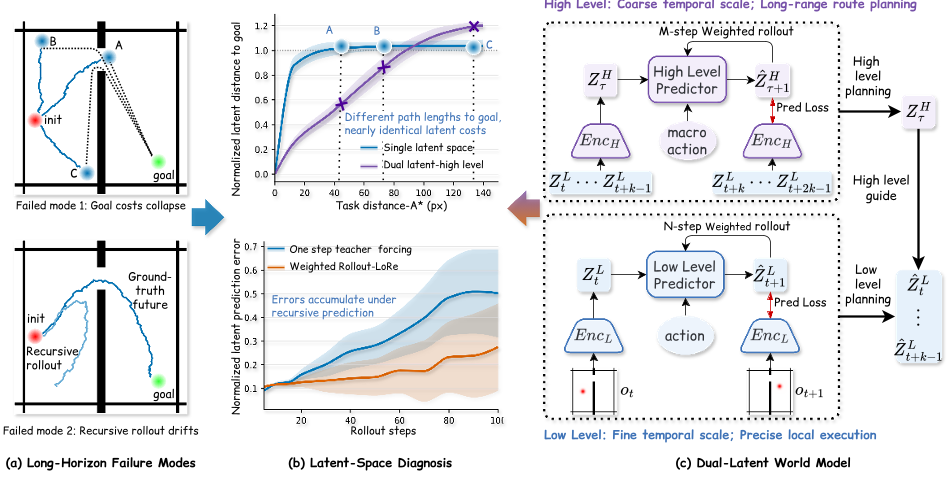
第一个机制是递归误差累积。反复复合一个只在相邻状态上训练过的转移模型,会让想象轨迹偏离真实演化。第二个机制是距离集中:在各向同性高斯正则化的高维表示中,若编码状态零均值、单位协方差,定义 ,则
其中 是相隔 步的两个编码状态, 是它们的平均归一化内积(取值范围约在 到 之间), 是潜在维度。这个式子给出的关键信息是:当时间相关性 随时间衰减趋近于零,均方距离会单调趋近 这个只由维度决定的常数,与任务进度无关。因此哪怕预测完全准确,远处候选的 goal cost 也会挤在同一条水平线附近,规划器无从排序。反过来,若 保持较大,说明状态间仍有可区分的时间结构——这正是高层表示希望保住的性质。论文在附录 A 中进一步说明,高斯边缘分布并不蕴含独立性,one-step 训练在数学上也不强制时间相关性消失;问题在于它从不显式要求远距离状态的距离去反映任务进度,所以距离趋于参考值是「无人约束」的自然结果,而不是某种被优化的目标。
论文对这两个机制并不只停留在叙事层面,还给出了一个可验证的排序条件。附录 A.1 里,固定潜在空间与目标 ,两条候选控制序列 的真实端点编码为 、模型预测为 ,令 、,并假定端点预测误差 。那么当真实距离差(margin) 满足
其中 是两个候选在真实潜在成本上的间距, 分别是两个候选端点的预测误差上界(非负标量), 是模型给出的估计成本。这个条件的角色是把两个看似独立的失效机制绑在同一个不等式里:递归预测误差抬高 的和,距离集中则压低可用 margin ,两者共同决定排序能否被认证。它的边界也很清楚——这是充分条件而非必要条件,更小或部分抵消的成本误差同样可能保住排序;但一旦 margin 被距离集中压到很小,就必须有极紧的预测误差界才能维持同样的排序保证。这就是「为什么必须同时改善预测一致性和几何」的形式化理由。
作者的研究直觉因此不是纯工程性的,而是被这一条件与 Figure 1 的诊断共同支撑的:Figure 1(a) 在 held-out TwoRoom 数据上直接展示了 goal cost 对远距离状态塌缩、以及递归 rollout 漂移这两个现象。
核心章节
一、出发点:共享几何无法同时服务两种时间角色
论文的问题设定是离线数据集 上的目标条件规划,不要求任务奖励,也不要求真实状态距离标签。记号上, 索引低层模型步,每个低层输入 打包 个环境动作,因此一个低层模型步覆盖 个环境步;macro-action 段 跨越 个低层模型步,即 个环境步。这一时间单位的区分后文反复用到,读者需要记住:低层的「一步」与高层的「一步」物理长度不同。
形式化地,两套表示与两套动力学被定义为
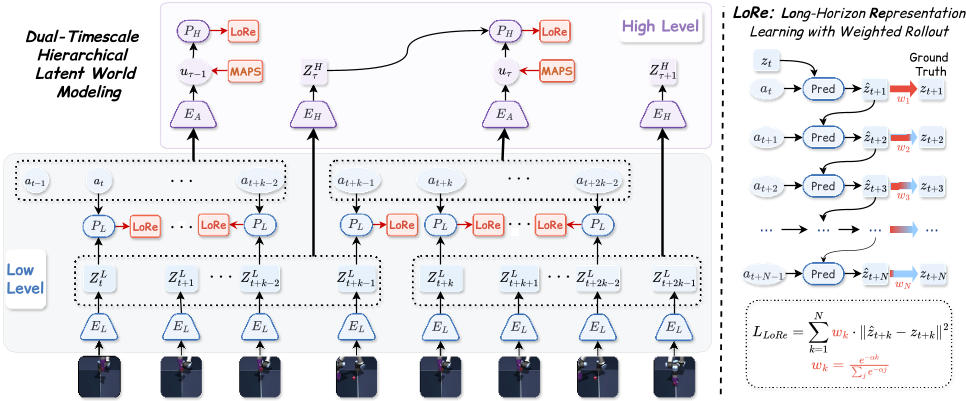
其中 是与高层状态 关联的长度 的低层潜在窗口(当只有一帧可用时,其低层潜在被重复填满该窗口), 分别是低层与高层状态编码器, 是两个潜在空间的维度; 是对应的动力学预测器, 是原始动作输入, 是由 posterior 汇总得到的 macro-action。相比单空间做法,这里的改动是:高层预测的训练目标不再是相邻低层状态,而是相隔 个低层模型步的状态——这使高层几何天然按较长的时间尺度组织状态差异,而低层预测继续保留对立即动作结果敏感的区分度。若把两者强行合并成一个空间(即把 换成恒等映射或直接拼接),几何就必须同时满足两套时间尺度上的要求,这正是后文 Window-Concat 消融所检验的情形。
值得注意的是梯度路径设计:训练时高层分支接收 , 保持数值不变但阻断梯度,因此高层损失更新高层模块而不改动 与 。这个设计的边界在于——它意味着高层表示的好坏完全取决于低层特征是否已包含足够信息,如果低层编码器塌缩,高层没有任何手段去挽救。论文未给出对这一风险的进一步分析。
macro-action 接口还需要在搜索时行为良好,为此引入 MAPS:
其中 是从数据集中采样的动作段, 是 macro-action posterior, 是 维标准高斯先验, 是 KL 散度。它的作用位置很特殊:整条训练链条里,唯一直接约束 macro-action 空间形状的就是这一项。规划时 macro-action 是优化变量,其 posterior 编码器只在训练时需要,因此这个先验的作用不是压缩信息,而是给候选生成一个共同分布,使 CEM 采样有合理的初始支撑。边界体现在后文 Figure 21 的经验结果上:加入 MAPS 后规划成功率显著上升,但 one-step 与 six-step 的潜在 MSE 反而更高——说明它塑造的是「利于搜索的空间」而非「预测误差最小的空间」,二者在这里并不一致。若把 设为零,该约束完全消失,只剩确定性编码或未正则的随机编码。
二、LoRe:把递归误差传播变成地平线权重
LoRe 的核心主张是:动力学模型应该在它规划时真正会用到的那种递归预测上接受训练,同时控制不同 rollout 地平线对损失的贡献。对尺度 ,设 、(以低层模型步为单位),从编码锚点出发的 rollout 为
这里的符号需要逐一交代:、 是两个尺度各自的输入(低层用记录的动作,高层用从对应段编码出的 macro-action),、 是训练 rollout 长度, 是未来观测提供的目标, 是尺度专属的衰减率。与单步或均匀权重做法的差别有两处:第一,rollout 初始化之后不再被重置回观测到的未来状态,损失对整条递归预测链求导;第二,权重不再是常数,而是按地平线指数衰减。若令 ,指数权重退化为均匀权重,这正是 HWM 报告的自回归目标的形式;若令 ,如附录 B.3 所示,加权损失的极限退化为 one-step 预测 ,而终端误差的界会随 变小而变松——也就是说衰减无限大等于放弃了多步监督。有限衰减是这两端之间的折中。
权重为什么是指数族?论文给出了一条从递归误差到权重形式的推导。固定控制序列与共享编码起点,假设 在所遇到的编码与预测输入上是 -Lipschitz 的、单步残差至多为 ,记 且 ,则
其中 是 Lipschitz 常数, 是单步残差上界, 是几何级数部分和( 时为 , 时为 )。这个界的作用是把「多步误差如何增长」写成了显式形式:参照权重 可以均衡各地平线的加权平方误差包络。它的边界同样明确——附录 B.2 指出,当 且 远大于 1 时,相邻地平线的衰减率趋近 ,即指数族;但当 远小于 1 时 ,有限的训练地平线未必进入指数区间,因此论文明确不主张取 ,而是把 当作自由参数。Lipschitz 与残差界都是对「所考虑的 rollout」的条件性假设,并非模型的实测全局性质,且推导未假设局部残差会相互抵消,因此该界可能偏保守。
还有一处容易被忽略但很关键的设计理由:两个尺度使用各自独立的衰减率,因为一个高层步覆盖 个低层步( 个环境步),相同的步索引并不代表相同的物理地平线。附录 B.3 进一步指出,若要求「每个环境步相对衰减率 相同」,会导出 这一关系,这只对齐物理衰减率;两个预测器的残差与敏感度可以不同,采样地平线与归一化常数也不同,因此仍需分别参数化。
总训练目标是
其中 是两个尺度 LoRe 的损失权重(实验配置中均为 1), 是 MAPS 系数, 是沿用 LeWM 的各向同性高斯状态正则项(含两个尺度的正则权重)。相比只做单步预测的目标,这一式子在精度项之外显式加入了跨地平线的一致性与 macro-action 空间形状约束。若去掉两个 LoRe 项只保留 与单步监督,就退化为 LeWM 式的训练;Figure 5 显示这种退化在 offset 100 处把成功率从 92% 拉低到 48%。
三、三阶段 coarse-to-fine 规划与它的代价
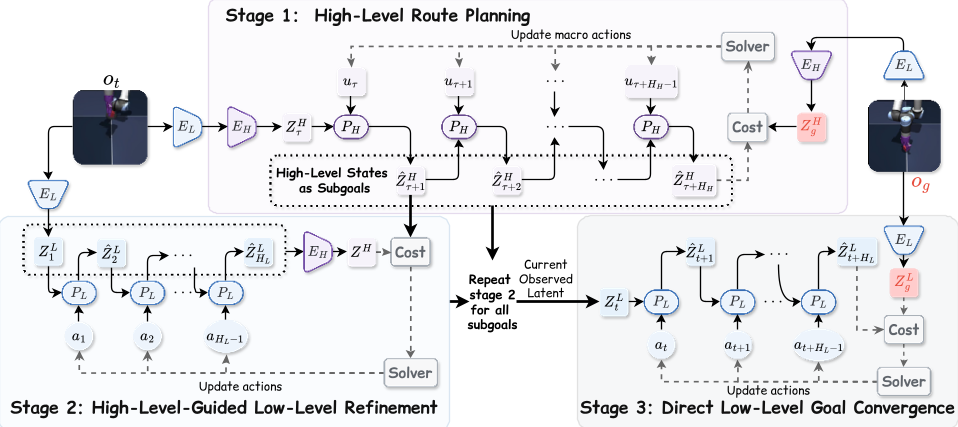
规划阶段完全不使用逆映射,这是理解耦合方式的关键。令 表示从 出发、在动作序列 下递归应用 共 次,规划地平线 不必等于训练地平线 。
阶段一是高层路由规划,在连续 macro-action 空间用 CEM 求解
其中 是待优化的 macro-action 序列, 与 分别是当前观测与目标观测经高层编码得到的状态。这条式子定义的是粗粒度选路:一条覆盖 个低层模型步(即 个环境步)的路由只需 次转移,因此把路由搜索的预测深度压了下来。它的边界来自 MAPS——没有先验正则时,这个连续优化在训练分布之外的 macro-action 上行为未知。
阶段二做高层引导的低层细化。给定选中的子目标 ,记 是由低层 rollout 构造、用于与该子目标比较的长度 潜在窗口,优化
其中 是低层动作输入序列。这一式的角色是提供两个空间之间的耦合:动力学仍是低层的,但比较发生在高层——低层计划的好坏由它的潜在窗口经 投影后与抽象子目标的匹配程度来评判。它的设计理由很值得追问:为什么不用一个逆映射把 解码回 ,或用解码器把 macro-action 展开成原始动作?论文给出的理由是这样做可以避免额外引入这两个映射,但同时也意味着低层计划完全受高层子目标支配;若子目标本身选错,细化阶段没有独立的纠偏机制。
阶段三切换到直接低层目标收敛:
其中 是目标观测的低层编码。这一式替换掉了阶段二的投影成本,改用低层潜在距离直接收尾。论文的解释是:在高层空间里匹配的状态,在完成度上仍可能有重要差异,直接低层匹配保留了对这些差异的敏感度。三阶段的分工因此是——高层动力学选路,低层动力学加投影成本执行,低层成本精确收尾。若跳过阶段三、只在高层空间收敛,就会丢掉完成度所需的细粒度区分;这一点在 Figure 4 与 Figure 18 的诊断中有间接支持。
实验与证据
主结果
Table 1 报告了 goal offset 50 与 100(环境步)下的成功率,对比对象是 LeWM 与逐任务最强的非 Dual-WM 结果(不含 actor-guided proposals):
| 任务 | 偏移 50 的 LeWM | 偏移 50 的最强其他 | 偏移 50 的 Dual-WM | 偏移 100 的 LeWM | 偏移 100 的最强其他 | 偏移 100 的 Dual-WM |
|---|---|---|---|---|---|---|
| TwoRoom | 61.50 | 94.83 (Gemini) | 99.33 | 27.00 | 90.00 (Gemini) | 92.50 |
| Reacher | 85.33 | 92.33 (INTACT) | 98.67 | 75.67 | 84.83 (Gemini) | 93.30 |
| Sokoban-Long | 41.50 | 52.00 (Gemini) | 75.17 | 16.33 | 35.00 (Gemini) | 52.33 |
| PushT | 56.00 | 78.00 (HWM) | 86.17 | 20.00 | 31.00 (HWM) | 41.33 |
| Cube-Single | 51.33 | 62.17 (DINO-WM) | 62.67 | 54.17 | 66.33 (Fast-LeWM) | 67.83 |
| 平均 | 59.1 | 75.9 | 84.4 | 38.6 | 61.4 | 69.5 |
最值得注意的不是平均值本身,而是 TwoRoom 与 Sokoban-Long 上的巨大差距:92.50% 对 27.00%、52.33% 对 16.33%。这两个任务恰好都需要「先到达门另一侧」或「先建立正确推箱姿态」这类长程中间决策,与距离集中假设中「远距离候选不可分」的失效场景高度对应。Sokoban-Long 使用离散动作,说明收益不止于连续控制。作者还报告,offset 25 时同一模型在 TwoRoom、Reacher、PushT 上分别达到 100%、99.0%、98.0%——短程上各方法差距本就有限,收益主要出现在长程。
拆解性证据
分层本身的贡献可以在 Table 5 与 Table 7 中看出:offset 100 处,完整配置相对 low-level-only 变体在 TwoRoom、Reacher、Sokoban-Long、PushT、Cube-Single 上分别高出 23.83、4.13、6.50、21.50、6.33 个百分点,且两者共享同一低层 checkpoint。这排除了「增益来自更好的低层预测器」这一替代解释。
表示接口的消融在 TwoRoom 上给出很干净的对照(Figure 4 与附录 H):Shared-Identity、Endpoint-MLP 与 Window-Concat 都使用端点或直接拼接,全部共享同一低层 checkpoint 与 coarse-to-fine 规划器。offset 100 处 Dual-WM 达 93%,Window-Concat 只有 41%——两者使用完全相同的长度 k 输入窗口,差距 52 个百分点,因此增益不能归因于窗口上下文本身,而必须归因于学习到的高层表示。Endpoint-MLP 与 Shared-Identity 分别为 69% 与 47%。在最远距离分箱中,Dual-WM-H 的目标排序准确率为 84.9%,Window-Concat 仅 51.0%(Figure 18)。
LoRe 的尺度激活消融(Figure 5)显示:offset 100 处,单步监督为 48%,仅低层 LoRe 为 79%,仅高层 LoRe 为 76%,双层 LoRe 为 92%,比更强的单尺度设置高 13 个百分点。低层 LoRe 在 offset 25 时已达 100%,说明高层 rollout 监督的价值主要体现在更长偏移处。
低层训练地平线与权重同样有细粒度扫描:在 low-level-only 规划下,offset 100 的成功率从 N=1 的 32% 升到 N=5 的 69%,再到 N=10 的 37%;在 N=5 时指数权重为 69%,线性权重 62%,均匀权重 54%。相应的物理状态探针也与之一致——评估地平线 10 上的位置误差为 N=1 时 12.0 px、N=5 时 5.7 px、N=10 时 8.9 px。
MAPS 的结果是最能说明「预测精度与规划价值不必然同向」的一处证据:offset 100 处,确定性 macro-action 编码为 67%,随机编码但无 MAPS(beta = 0)为 81%,加入 MAPS 后在 beta = 10^-2 达到 93.5%,尽管此时的 one-step 与 six-step 潜在 MSE 都高于 beta = 0;继续把 beta 提到 5×10^-2 则降到 91.5%。作者据此主张 MAPS 塑造的是更利于搜索的 macro-action 空间,而不是单纯压低预测误差。
证据质量评估
有两类证据值得区分。跨任务、跨动作空间的结论相对稳健:五个任务中包含连续控制与离散动作,且 offset 100 处 Dual-WM 在全部五个任务上都超过 LeWM。但另一些结论明显是在有利设置下取得的。VFM-adaptor 变体在 Reacher 上最强(offset 100 达 98.50%),却在 PushT 上弱于 from-scratch 版本(11.67% 对 41.33%),说明预训练视觉特征的收益是任务依赖的,论文对此并未给出机制性解释。作者自己也指出 Cube-Single 的成功率对数据集偏移是非单调的,因为「记录轨迹上的时间间隔本身不是最小控制难度的度量」——这是一个诚实的限定,但也意味着该任务上的数字不应被当作纯长程难度的度量。
此外,论文明确指出组件消融(Figure 4、5、19、20、21)全部只在 TwoRoom 上进行,且规划结果只平均三个 planning seed 且不显示误差条;horizon 与 weighting 研究使用 low-level-only 规划而非完整层级规划器,因此 N=5 的 69% 对应的不是主表里的完整配置。actor-guided 比较(Table 8)更揭示出这种扩展的脆弱性:在 offset 50 处,actor 引导把 INTACT 从 57.17% 提到 58.50% 附近的同时,却把 Dual-WM 从 62.67% 降到 58.50%——增益方向依赖评测设置。最后,Sokoban-Long 的定性执行图(Figure 12)来自标准 200 任务样本之外的补充 held-out 数据对,属于个案展示而非统计证据。
时间代价方面,Figure 7 给出的结论对工程实践有价值:TwoRoom offset 100 处,Dual-WM 以 92.4 ms 每个环境步达到 90% 成功率,而 low-level-only 变体以 93.3 ms 只达 68%,即便把预算拉到 247.7 ms 也只到 84%;同一范围内 LeWM 稳定在 40%,HWM 从 7% 升到 33%。这说明双潜在规划的收益不是靠更长的搜索时间换来的。
深度洞察与总结
Dual-WM 最有价值的部分不是那套三阶段规划流程,而是它把「世界模型好不好用」拆成了三个可分别度量的维度:长程目标可区分性、递归预测一致性、以及低层收敛精度。附录 A 的距离集中分析、附录 A.1 的排序充分条件、附录 B 的有限地平线权重推导,以及 Figure 13–18 的一系列几何诊断,共同构成了一个可以脱离具体架构复用的评估框架。特别地,把递归误差界与候选排序 margin 放进同一个不等式(),给「为什么预测精度不足以决定规划质量」提供了一个可证伪的表述。
局限也很具体。第一,评测完全基于离线数据与固定的时间抽象(每个任务的 、 由 Table 3 固定,如 TwoRoom 的 f=5、k=3),论文在结论中承认「自适应时间尺度」是未来方向,但未给出任何关于 或 敏感性的实验——这意味着双尺度分离的一半参数空间尚未被探索。第二,高层表示完全依赖 阻断后的低层特征,一旦低层表示塌缩,高层无从挽救,论文未分析这一依赖的风险边界。第三,关键超参(如 MAPS 系数 beta = 10^-2、各任务的两层正则权重)按 Table 3 逐任务设定,但组件消融仅报告了 TwoRoom 上的趋势,其他任务是否重新搜索过 beta 或正则权重,论文未说明。第四,actor-guided 扩展在 offset 50 处反而降低 Dual-WM 表现,说明该组合的收益依赖设置,尚不是一个稳定可推广的改进。
如果要把这个思路往前推,最有技术含量的方向不是「换更大的模型」,而是回答两个具体问题:其一,能否让两个尺度的时间抽象( 与 )在训练中自适应,从而不必依赖逐任务手调;其二,能否把附录 A.1 的排序条件变成一个显式的训练目标——即直接最大化候选 margin 相对预测误差的比值,而不是像现在这样仅通过分离表示和指数权重间接地改善它。