
[FAST 2026] PPC & MAIO:解锁 LLM 启动性能,让模型加载速度翻倍的“黑科技”
Accelerating Model Loading in {LLM} Inference by Programmable Page Cache
本文提出了 PPC (Programmable Page Cache) 框架及其针对大模型加载优化的缓存策略 MAIO。通过将内核页缓存变为可编程,MAIO 在不修改模型框架和内核前提下,利用 I/O 模板实现了极致的加载加速,在主流 LLM 上将加载延迟降低了高达 79%。
TL;DR
在云原生 AI(MaaS)时代,大模型的“冷启动”延迟往往以分钟计。华为技术团队在 FAST '26 发表的这项工作通过 PPC (Programmable Page Cache) 框架,首次实现了在不改动 Linux 内核及模型框架的前提下,通过用户态策略管控页缓存。其配套的 MAIO (Model-Accelerated I/O) 策略利用 I/O 模板技术,将加载速度提升了近 5 倍。
背景定位:这是一项深度的系统级优化工作,处于存储系统与 AI 推理架构的交叉地带。它不追求修改底层硬件,而是通过精巧的软件重构(Stacking FS)打通了内核缓存与应用需求之间的“最后一百米”。
痛点深挖:为什么原生 Linux 喂不饱你的 GPU?
当你在加载一个 70B 甚至 671B 的大模型时,传统的 Linux 内核显得相当“迟钝”:
- 预取机制太保守:内核默认只看当前文件的一小段(如 128KB),而 SSD 的并行带宽往往高达数 GB/s,绝大部分带宽在模型加载时处于闲置状态。
- NUMA/XPU 亲和性缺失:内核不知道数据最终要去哪个物理 GPU,导致数据加载到了错误的 NUMA 节点,产生了昂贵的跨节点访问开销。
- 无效内存占用:模型一旦载入专用显存(HBM),宿主机的 Page Cache 逻辑上就可以释放了,但 LRU 算法并不知道这一点,导致内存白白浪费并在压力大时导致系统崩溃。
核心架构:PPC 与 MAIO 的协奏曲
1. PPC:非侵入式的“上帝视角”
作者设计了一个 Routing File System (RFS)。它像一层透明的薄膜覆盖在 EXT4 或 XFS 之上。当发生 Page Miss 时,它不会直接阻塞,而是通过 UPC (Userspace Procedure Call) 发出信号给用户态运行时。
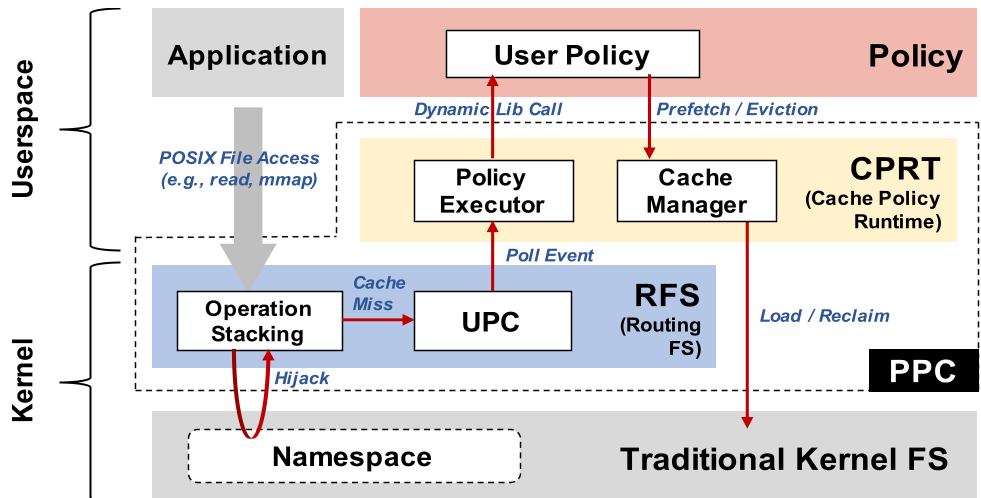 PPC 架构展示:内核层 RFS 劫持事件,用户态 CPRT 执行定制策略
2. MAIO:基于模板的精准打击
由于同一推理服务(模型+并行策略)的 I/O 访问顺序是高度确定的(Reproducible),MAIO 会提前录制一份 I/O 模板。有了这份“剧本”,它能做到:
- 可中断预取:激进地抢占带宽。如果推理框架处理得快,预取会自动跳到最新位置,防止无效 I/O。
- 读后即焚 (Burn-after-Reading, BAR):一旦数据离开宿主机进入 NPU,立即触发标记释放内存,为 KV Cache 腾出空间。
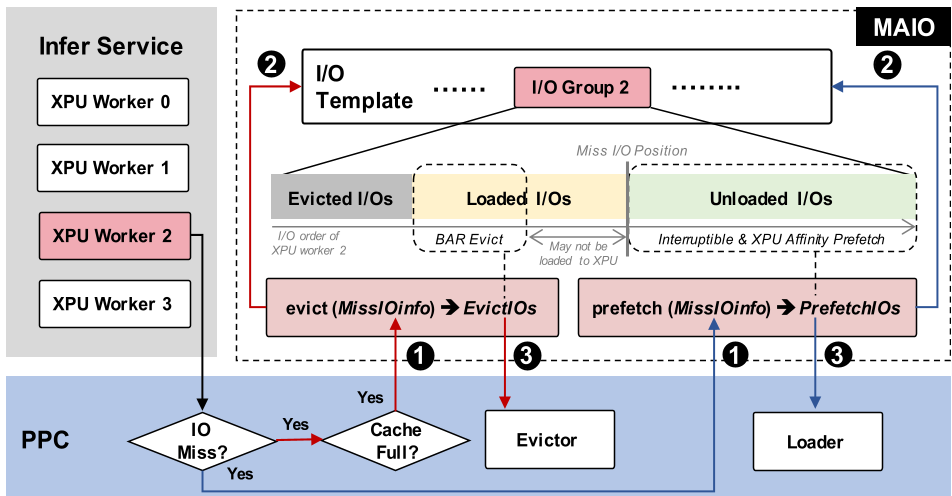 MAIO 实现流程:通过 I/O 模板感知 XPU 亲和性并匹配预取策略
实验与结果:全方位碾压
在测试 Qwen2.5-72B 和 Llama-70B 时,MAIO 的表现令人惊艳:
- 加载时间:相比原生内核策略,延迟从分钟级锐减(降低 79%)。
- 内存受限场景:通过 BAR 驱逐机制,MAIO 在仅有 64GB 内存(远小于模型体积)的机器上表现极稳,而传统的 PreCache 或 EagerLoad 方法会因为“缓存颠簸”直接导致性能滑坡。
- 推理吞吐量:在弹性扩展(Elastic Deployment)测试中,MAIO 带动了整个 MaaS 系统的推理吞吐提升了 36%。
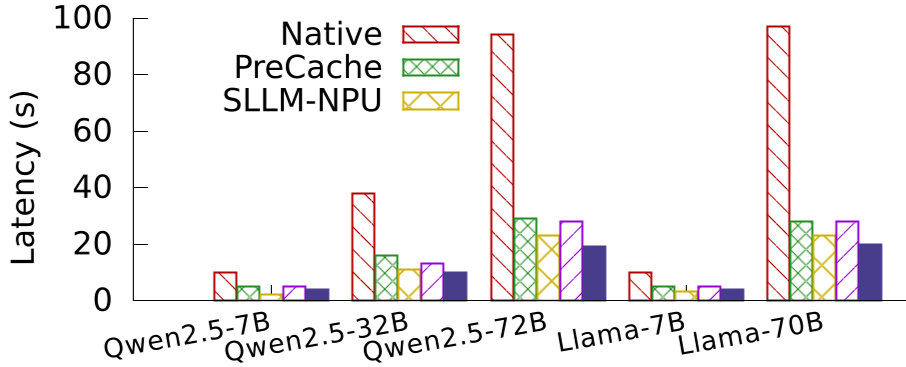 实验数据显示:MAIO 在不同模型规模下均保持 SOTA 领先
深度洞察与总结
Takeaway:
- 兼容性即生命:MAIO 之所以具有吸引力,是因为它不需要用户修改一行 vLLM 或 PyTorch 代码。
- 用户态是未来:随着 SSD 速度和模型体积的同步爆发,将 I/O 策略从僵硬的内核中剥离出来,交给灵活的用户态程序处理,是未来的必然趋势。
局限性: 目前 PPC 仅支持只读场景(Read-only),这对于模型加载是足够的。但在未来,如果想优化大模型的训练断点恢复(Checkpointing),则需要进一步支持复杂的写入一致性语义。
启示: 对于企业级 AI 平台,MAIO 提供了一个极佳的范式——通过“离线画像(I/O Template)+ 在线调度(PPC)”的方式,可以极低成本地榨干现有硬件资源。