
机器学习加速 MOFs 重构:精准预测 N₂ 吸附容量的新高度
Toward accurate prediction of N2 uptake capacity in metal-organic frameworks
本文利用 3246 组实验测量的多维数据集,开发并对比了四种先进的机器学习模型(XGBoost, CatBoost, DNN, GPR-RQ),用于预测金属有机框架(MOFs)的氮气(N₂)吸附容量。实验证明 XGBoost 在该任务中表现最优,实现了 R² = 0.9984 的极高预测精度。
核心速览
TL;DR:本研究针对天然气纯化中的核心痛点——N₂/CH₄ 分离,构建了包含 3246 组真实实验数据的大型数据库。通过对比四种主流算法,本文提出了一种基于 XGBoost 的高性能预测框架,其 R² 达到惊人的 0.9984。研究不仅实现了工程预测的精准化,还通过 SHAP 解释工具深入剖析了吸附背后的物理主导因素,为“材料基因组工程”提供了有力的技术路径。
背景定位:该工作是 MOF 气体吸附建模领域的一项 SOTA 刷榜实践,其核心价值在于从小样本、特定类型的实验尝试转向了大规模、跨品种(65 种 MOF)的稳健机器学习预测。
痛点与动机
工业界对天然气的纯度要求极严(N₂ 含量通常需低于 4%),然而 N₂ 与 CH₄ 的动力学直径极其接近(3.64 Å vs 3.81 Å),导致传统分离手段(如深冷蒸馏)极其能耗。
虽然 金属有机框架(MOFs) 凭借其可调的拓扑结构和超高空隙率成为理想吸附剂。但问题在于:
- 维度爆炸:MOFs 种类以万计,通过实验逐一测试吸附等温线如同大海捞针。
- 非线性限制:温度、压力与材料孔隙结构之间存在复杂的非线性耦合,简单的物理公式难以全域拟合。
- 黑盒困境:以往的 AI 模型虽有预测力,但对化学家来说缺乏“可解释性”——为什么这个材料吸附能力更强?
方法论详解 (Methodology)
1. 技术全流程架构
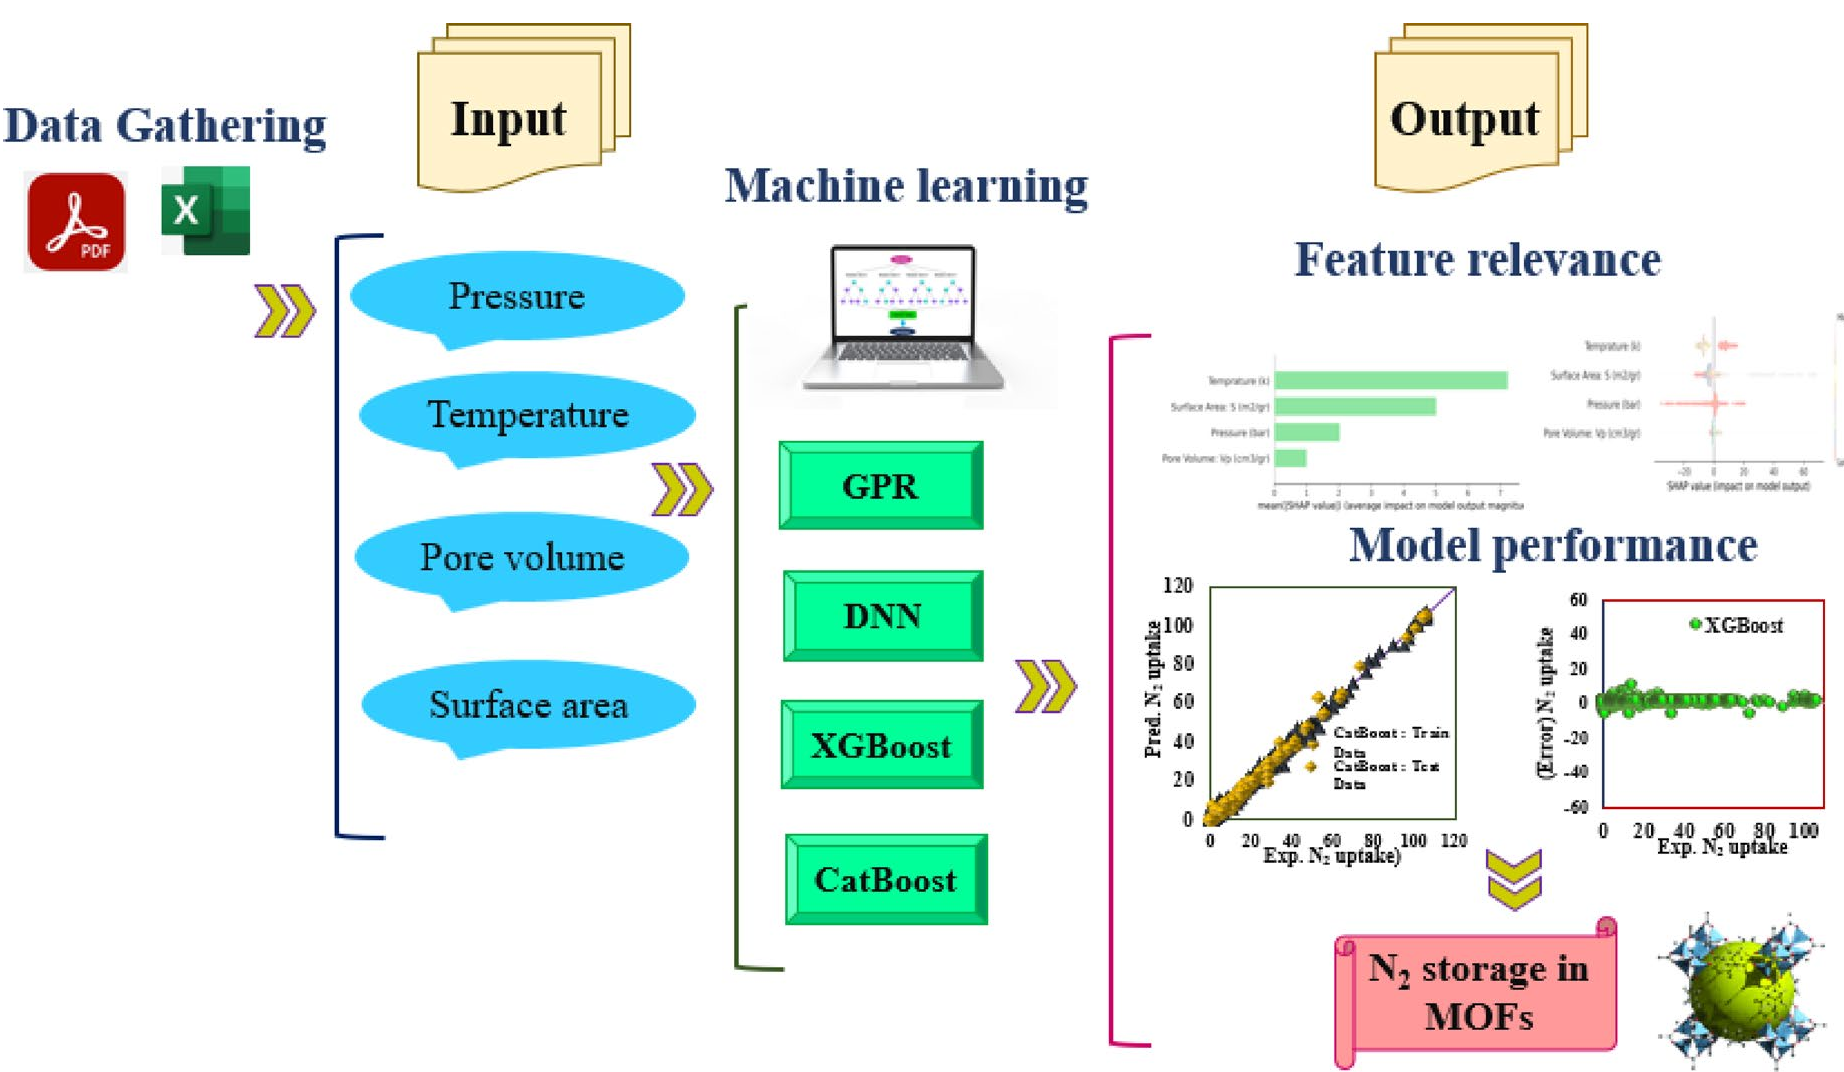
作者设计了一个从数据预处理到不确定性量化的闭环流程。关键点在于引入了 K-fold 交叉验证 来规避过拟合,保证了模型在未知材料上的泛化性。
2. 算法竞技场:为何 XGBoost 胜出?
研究对比了:
- CatBoost:擅长处理分类变量。
- XGBoost:通过二阶泰勒展开和正则化防止过拟合,在平衡效率与精度上达到最优。
- DNN:虽然表达能力强,但在处理此类表格化实验数据时,容易陷入局部最优。
- GPR-RQ:高斯过程回归提供概率估计,适合捕捉非线性趋势。
3. 物理直觉的量化:SHAP 分析
通过 SHAP 分析,研究者定量地展示了四个输入变量的影响(Temperature, Pressure, Pore Volume, Surface Area)。研究发现 温度 (Temperature) 是影响力最大的负相关参数,这完美符合物理原理:升温会加剧分子的热运动,降低气固界面的范德华力,从而抑制吸附。
实验与结果
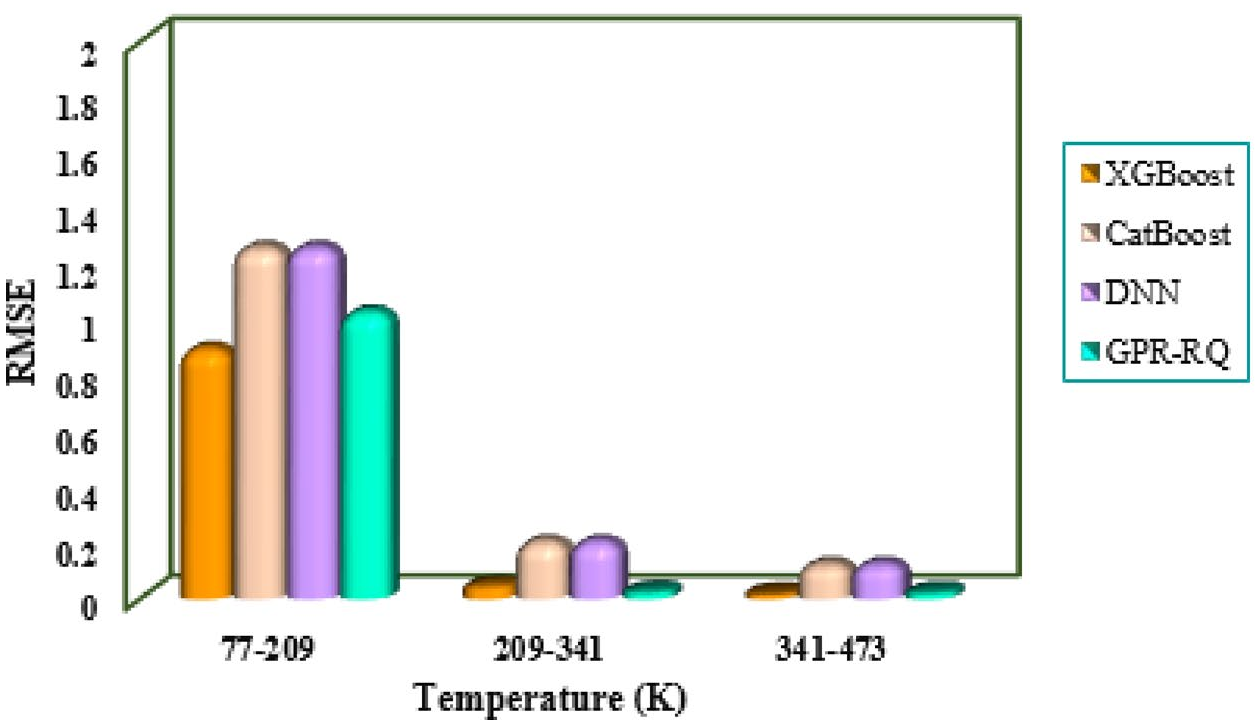
在 650 组独立的测试集上,XGBoost 的表现堪称完美:
- R² = 0.9984:意味着模型可以解释 99.8% 以上的吸附容量波动。
- 误差分布:绝大多数预测误差聚集在 0 附近,没有明显的系统性偏差。
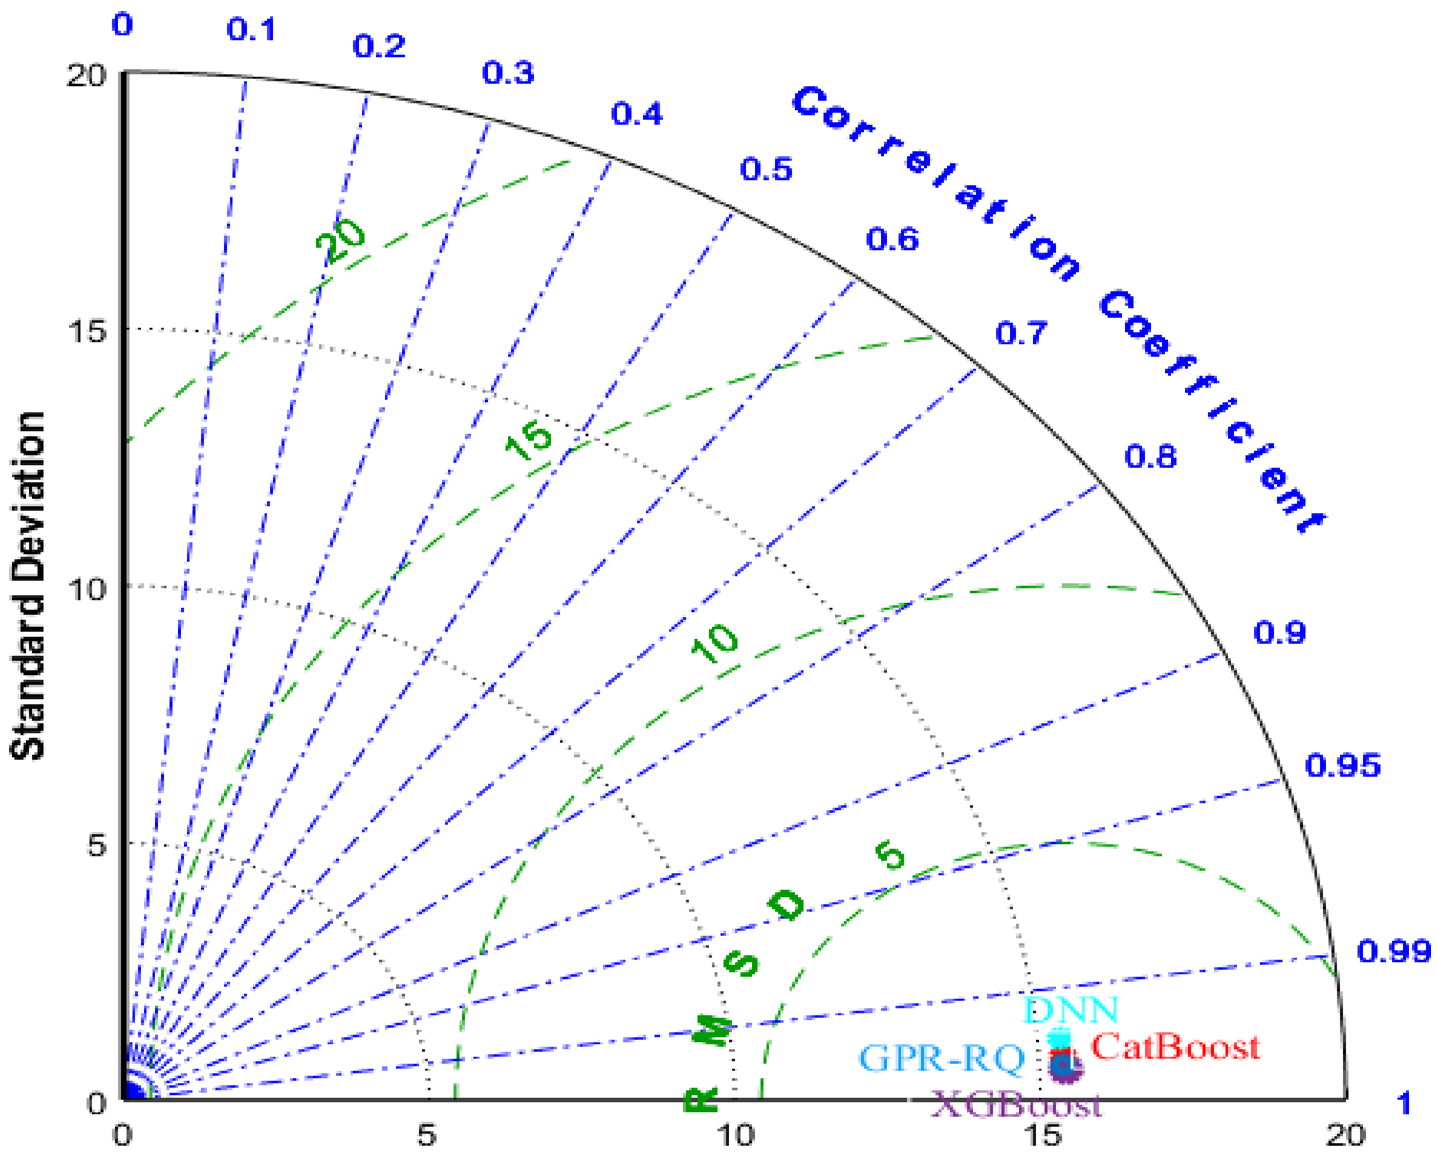
此外,通过 Taylor Diagram(泰勒图)的对比,可以直观地看到 XGBoost 是最接近“观测中心”的算法。
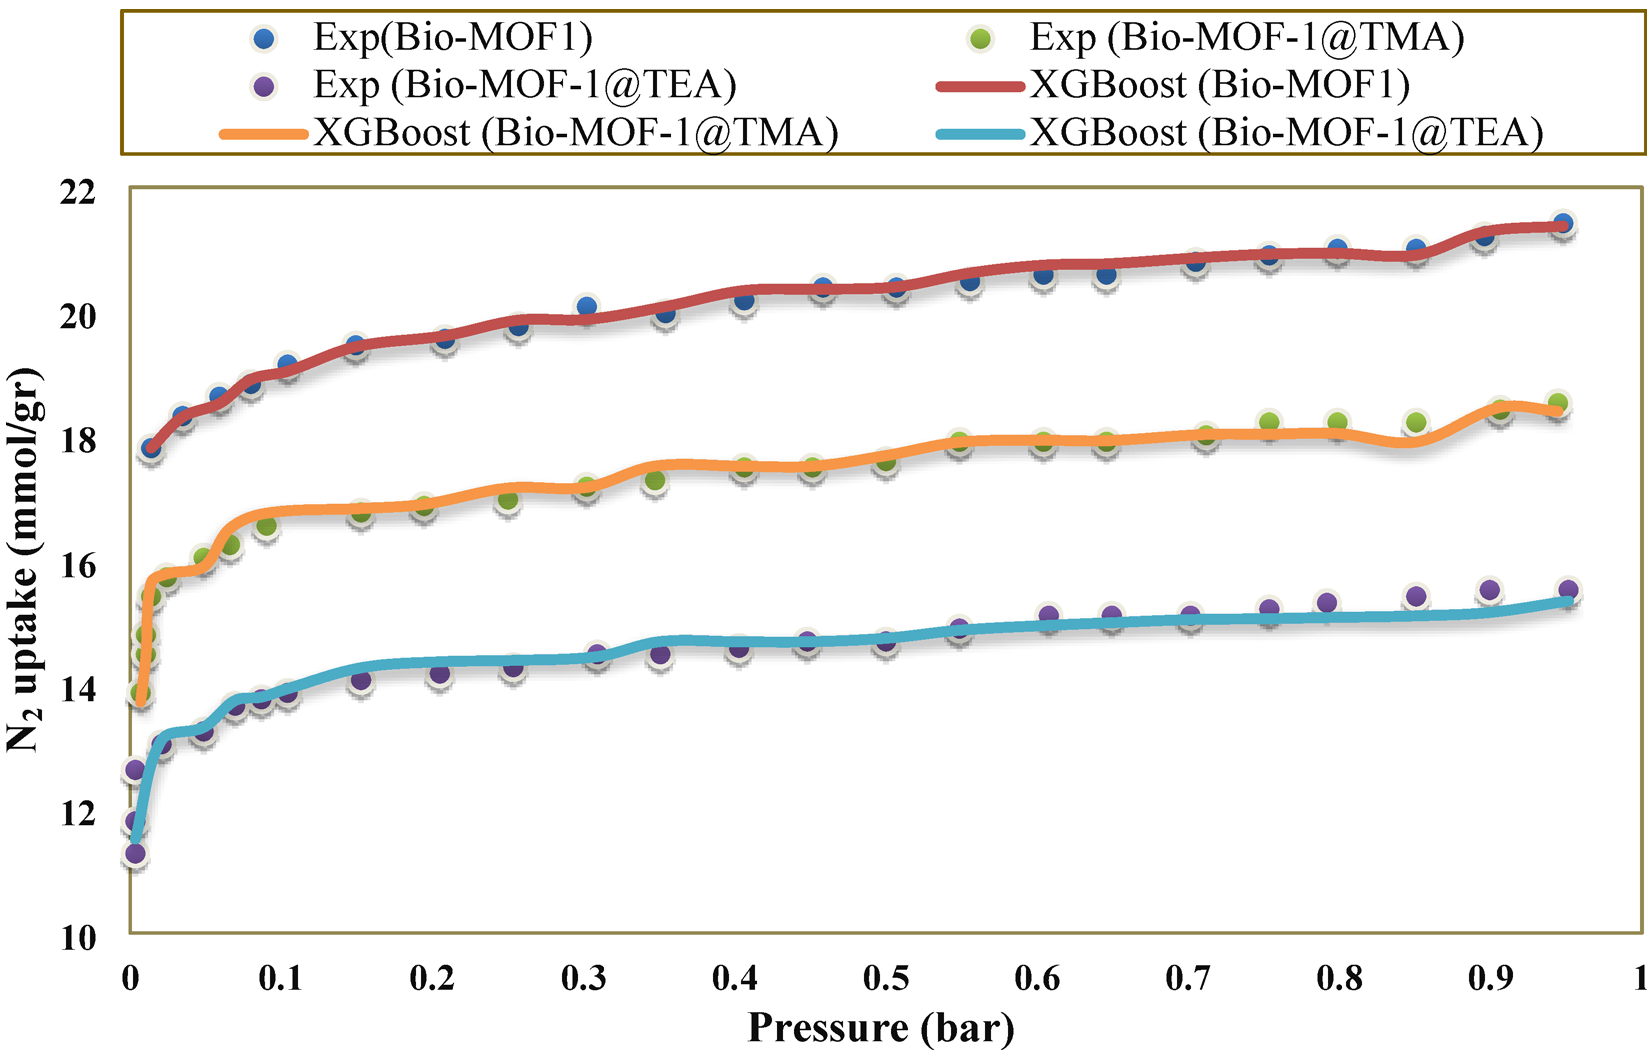
为了验证模型是否真的学到了物理规律,作者还进行了 Trend Analysis。结果显示模型预测的吸附量随压力增加的趋势与 Bio-MOF-1 等真实材料的实验曲线高度重合。
深度洞察与总结 (Critical Analysis)
局限性与挑错
尽管精度极高,但本研究主要依赖于全局物理参数(孔体积、表面积),而忽略了 MOF 的 微观拓扑结构 (Topology) 和 化学官能团 (Functional Groups) 的向量化表示。目前的输入特征更像是“宏观统计”,在预测具有特殊协同效应的新型拓扑结构时,可能会遇到瓶颈。
未来启示
这项研究向我们展示了“数据驱动科学”的力量。它不再只是对某个特定 MOF 做实验,而是将 MOF 研究带向了 标准化和数字化。
- 工业意义:可以作为 PSA(变压吸附)系统设计的数字孪生组件。
- 产品启示:未来的研发可以先在 XGBoost 模型进行“虚拟筛选”,锁定高潜力材料后再进入实验室,将研发投入产出比提升 10 倍以上。