
ACLSum:不仅是摘要,更是对学术逻辑的深度解构
ACLSum: A New Dataset for Aspect-based Summarization of Scientific Publications
本文推出了 ACLSUM,这是一个由领域专家手动构建的多维度科学论文摘要数据集。该数据集包含 250 篇 NLP 论文,针对 Challenge(挑战)、Approach(方法)和 Outcome(结果)三个维度提供了专家标注的关键句子(抽取式)和极简摘要(生成式),在学术文献多维度摘要任务中达到了新的基准。
TL;DR
在海量爬取的噪声数据充斥 AI 训练集时,来自曼海姆大学的研究团队反其道而行之,推出了 ACLSUM。这是一个完全由 NLP 专家人工标注、专注于科学论文的多维度摘要数据集。它不仅提供了高质量的参考摘要,还为每一条摘要匹配了原文中的“证据句”。通过对 BART、T5 和 Llama 2 的详尽测评,研究揭示了现有模型在理解科研“挑战(Challenge)”维度的深度乏力。
1. 痛点:被“自动生成”掩盖的低质量黑盒
目前的摘要模型看起来很美,但底座却很虚。大多数数据集(如 CNN/DailyMail, XSum)依靠 Lead-3 或语义重叠等启发式算法自动生成。这种做法在新闻领域尚可,但在科学领域却会导致三大致命伤:
- 不忠实 (Unfaithful):AI 常会“脑补”出原文没有的结论。
- 高噪声:爬虫数据常混入 URL、占位符甚至乱码。
- 缺乏透明度:模型生成了摘要,你却不知道它参考了原文哪一页哪一码。
2. ACLSUM:专家的雕琢
为了解决这些问题,作者邀请了 NLP 领域的研究生,对 250 篇顶级会议论文进行了精细化标注。
2.1 三大核心维度 (Aspects)
数据集不仅给出一个总结,而是将摘要拆解为:
- Challenge (挑战):研究针对的痛点与动机。
- Approach (方法):具体的模型架构或理论框架。
- Outcome (结果):最终的结论与验证。
2.2 两阶段标注流程
如下架构图所示,标注者先标记“Salient Sentences”(显著性句子),再将其浓缩为 25 字以内的“Extreme Summary”。
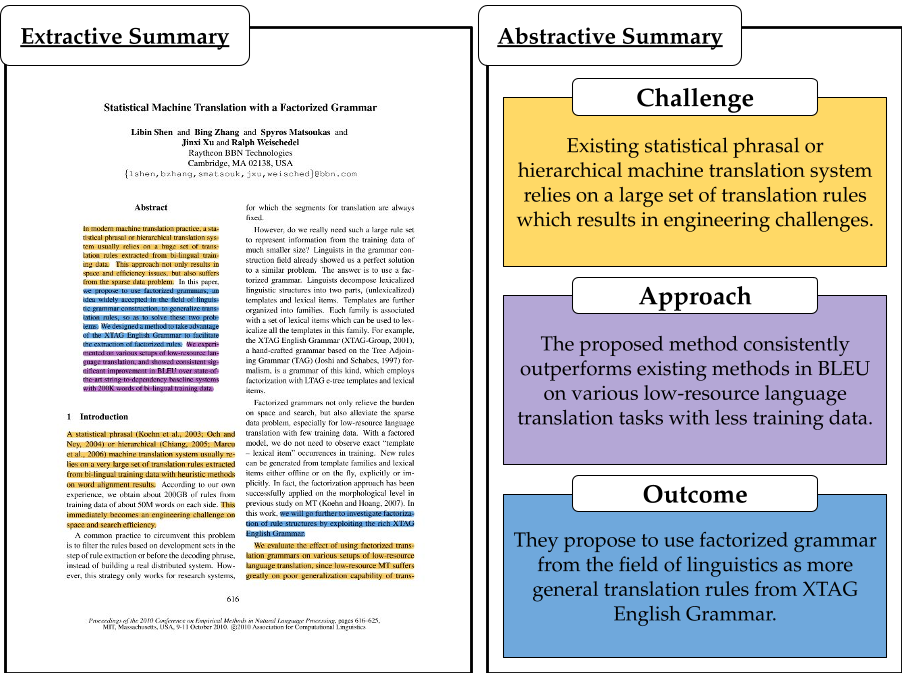 Figure 1: ACLSUM 数据样例。左侧为原文高亮,右侧为对应的三维度专家摘要。
3. 核心发现:模型真的懂我们的研究吗?
作者对比了**端到端生成(E2E)和先抽取后生成(EtA)**两种方案。
为什么 Challenge 这么难?
实验结果显示,所有的模型(包括 Llama 2 7B)在 Challenge 维度上的 ROUGE 值都显著低于其他维度。
- 抽象程度差异:Challenge 的关键信息往往散布在全文各处,且语义多样性最高(Entropy 达 9.39)。
- 语义离散性:如下图所示,Challenge 部分的语义向量(Centroid Similarity)最为分散,要求模型具备极高的跨段落融合能力。
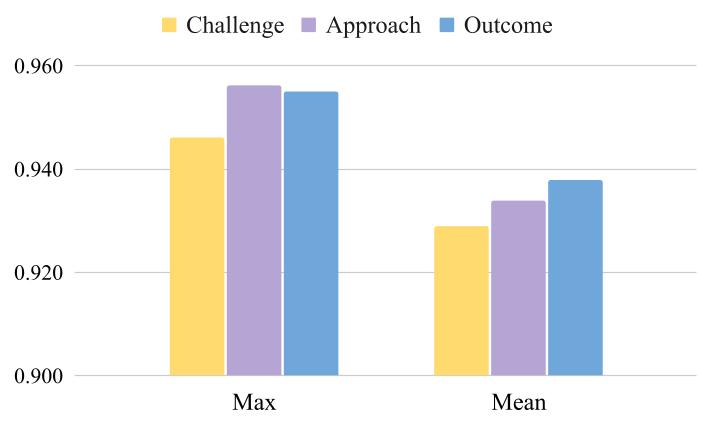 Figure 2: 不同维度的语义离散度对比。Challenge 维度的散度最大,导致生成难度激增。
4. 实验战绩与 SOTA 对比
在具体的 Benchmarking 中:
- PLMs (BART/T5):EtA 模式(如果使用专家标注的 Gold 句子作为输入)依然具有压倒性优势,其 R-1 往往比 E2E 高出 3-5 个点。
- LLMs (Llama 2):由于 LLM 的指令遵循能力更强,E2E 表现不俗。有趣的是,尝试让 Llama 2 像人类一样进行 Chain-of-Thought(先提取索引再生成)反而效果欠佳,这反映了当前开源模型在精确行号提取上的弱势。
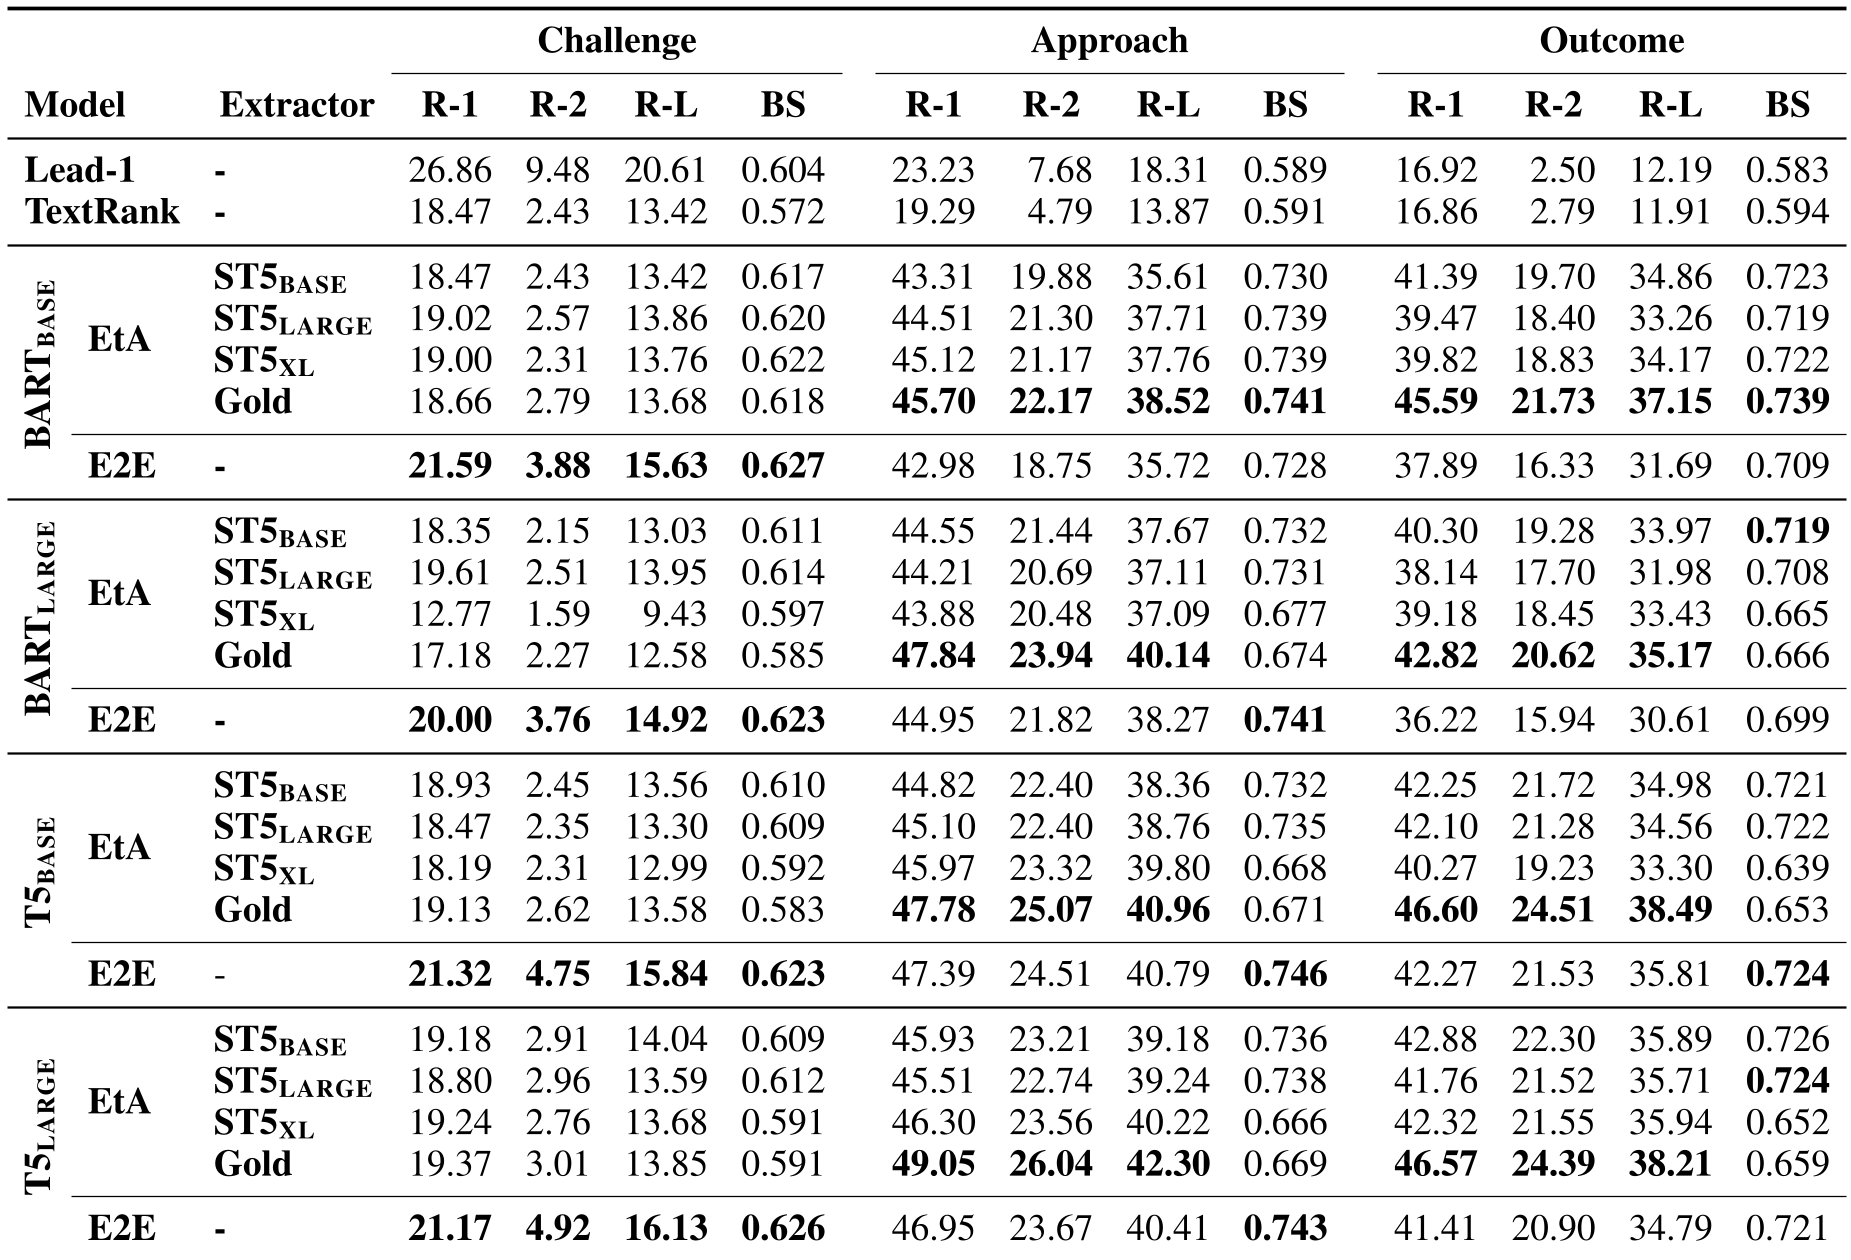 Table 5: 各类模型在三个维度上的性能表现,展示了 EtA Gold 模式的性能天花板。
5. 深度洞察与总结
ACLSUM 的价值不仅仅在于这 250 篇论文,而在于它揭示了一个事实:学术领域没有捷径。
- 启发式标签的破产:长期以来学术界使用的“贪心搜索”自动生成标签的方法,与专家标注的重合度 F1 仅为 70 左右,这解释了为什么很多模型在实验指标上刷得高,但实际用户体验差。
- 未来方向:如何利用此类高质量小样本数据进行“对齐(Alignment)”,引导模型在学术理解上从“复述摘要”进化到“逻辑推理”,是下一个学术攻坚的方向。
局限性:数据集目前仅涵盖英文 NLP 领域。未来希望能扩展至计算机视觉、医学及跨语言领域。