
ACM:智能体自主上下文管理——让 LLM 在长程任务中“学会遗忘”与“精准回忆”
ACM: Agentic Context Management for Long Horizon Tasks
本文提出 Agentic Context Management (ACM),一种让 LLM 智能体通过两个专用工具(manage_context 和 query_memory)自主进行无损上下文管理的框架。受人类短期/长期记忆交互启发,智能体自行决定何时压缩、卸载和检索上下文,无需外部启发式规则。在 BrowseComp-Plus 上,ACM 将 Qwen3.5-9B 的 Pass@1 从 0.570 提升至 0.727(+27%),接近 40 倍大模型性能。
TL;DR
核心痛点:LLM 智能体在长程任务(多轮搜索、代码修复)中,上下文窗口很快被冗余的 tool 输出和失败尝试填满。现有方法依赖外部触发(如固定阈值压缩),但触发器与智能体推理焦点脱节,且压缩后原始信息丢失。
关键方法:本文提出 Agentic Context Management (ACM),赋予智能体两个工具:manage_context(无损压缩并保存原始消息到外部文件)和 query_memory(按需查询原始消息)。智能体自主决定何时压缩、何时检索。配合双约束 teacher-student 后训练 pipeline,模型学会在正确时机使用这些工具。
量化成果:在 Qwen3.5-9B 上,BrowseComp-Plus Pass@1 提升 27%(0.570→0.727),DeepSearchQA 提升 16%,SWE-Bench Verified 提升 8%。峰值 token 减少约 20%,工具调用频率增加,探索步数延长。
论文定位:这是一篇将上下文管理从“外部启发式规则”推向“智能体自主决策”的实用工作,并开源了完整的训练数据生成流程,具有很高的工程参考价值。
痛点与动机
现有方法的局限
LLM 智能体(如 ReAct)在长程交互中会积累大量上下文:搜索返回的 snippets、代码执行结果、失败重试记录等。即使模型支持百万 token 窗口,实际性能在长序列中仍会严重退化(Lost in the Middle)。
现有上下文压缩方法有以下不足:
- 启发式触发:ReSum、ACON 等使用固定 token 阈值触发压缩,无论智能体此时是否需要。例如,智能体可能刚获得关键信息,却因超出阈值被压缩。
- 信息有损:压缩后原始消息被丢弃,智能体无法事后回顾,导致需要重新搜索。
- 外部寄生:压缩决策由外部模块做出,不与智能体自身的推理状态对齐。
作者的 Insight
作者观察到人类认知中短期记忆与长期记忆的交互:我们只保留当前推理所需的信息在“工作记忆”中,将不立即需要的信息持久化到外部(如笔记),并在需要时检索。理想情况下,LLM 智能体也应具备这种能力——自主决定何时将当前上下文压缩归档,并能在需要时精准检索原始内容。
方法论详解
ACM 框架
ACM 的核心是提供两个工具,让智能体像人类管理记忆一样管理上下文:
manage_context:将当前上下文(从上次压缩边界至今)压缩为摘要,并将原始消息保存到磁盘上的外部文件。摘要包含知识状态、推理路径和下一步建议。调用后,工作上下文被压缩,但原始内容无损。query_memory:通过指定summary_id和自然语言查询,从对应的原始消息中检索相关信息。返回的 tool result 包含精确匹配的内容。
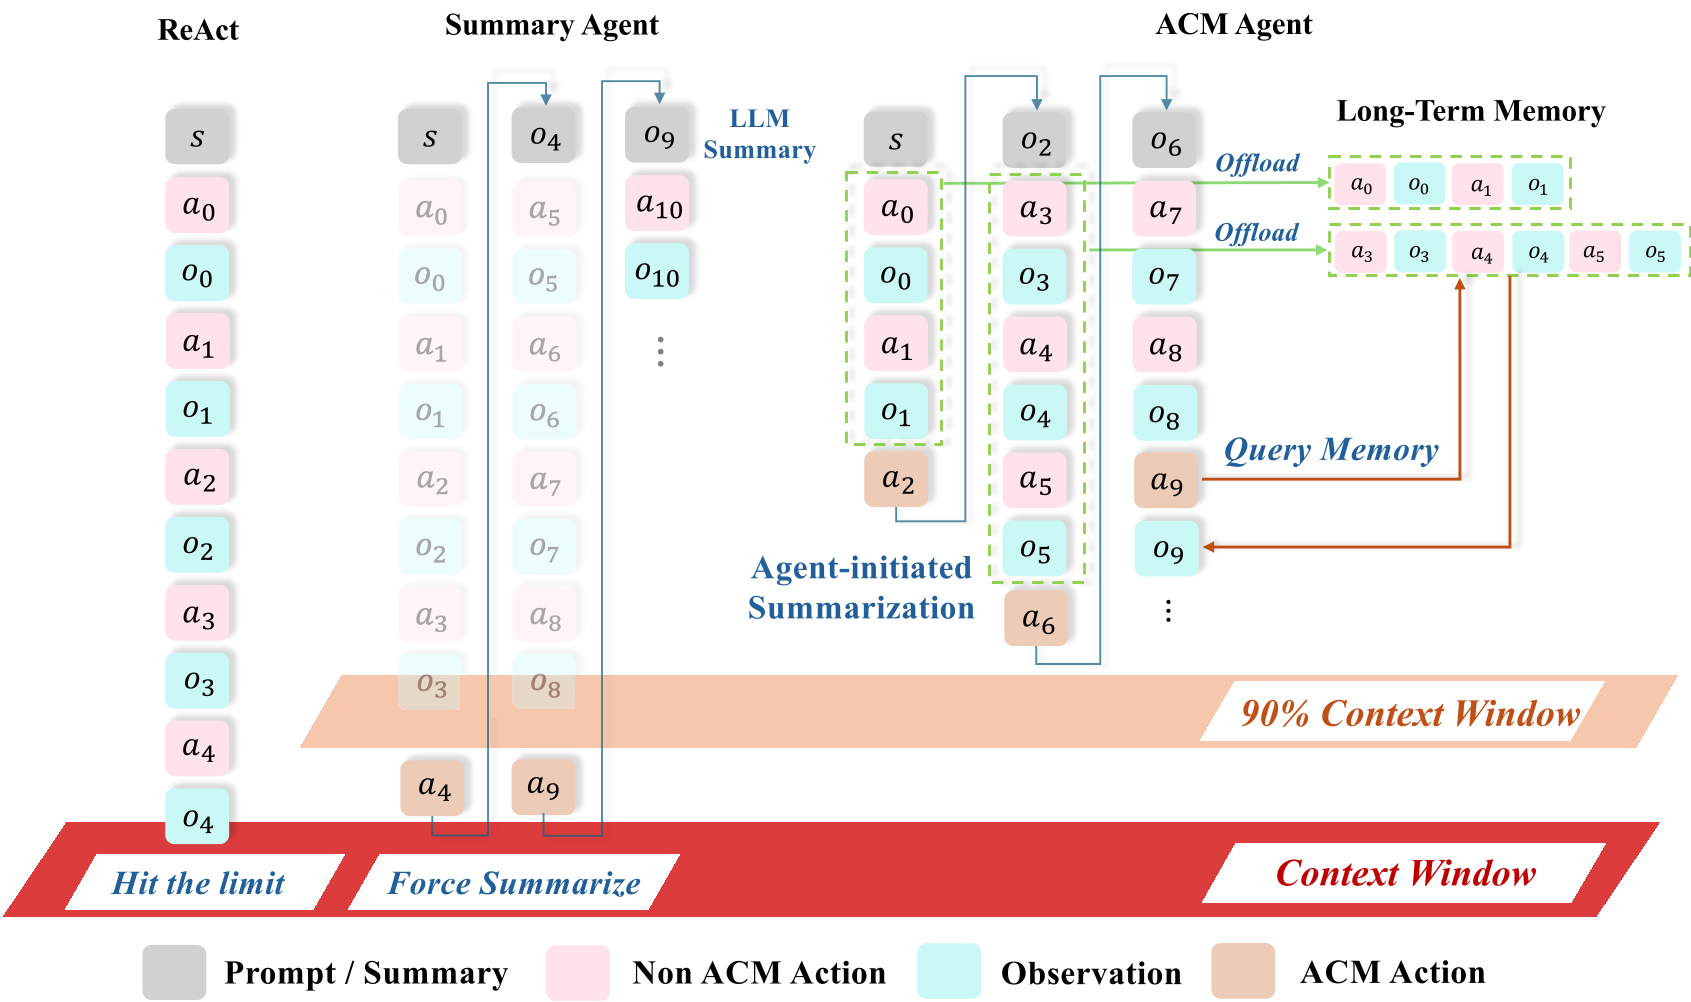
图 1:ReAct(无管理)、Summary Agent(外部触发,有损)与 ACM(自主触发,无损)的对比。ACM 智能体在推理过程中自发调用 manage_context(红色标记)和 query_memory(蓝色标记),保持上下文紧凑。
双约束后训练数据生成
即使前沿模型(如 GPT-5.5)也未必能自主决定何时压缩(见图 4)。因此,作者设计了 teacher-student 数据生成 pipeline,包含两个互补约束:
- Injection(注入):教师模型观察学生不带有 ACM 工具的失败轨迹,在陷入死循环或重复查询的位置,插入
manage_context或query_memory调用,并附上合理的推理。 - Refinement(替换):教师模型观察学生带有 ACM 工具但过度压缩的轨迹,将不恰当的上下文管理调用替换为更有效的动作(如继续搜索、检索文档或提交答案)。
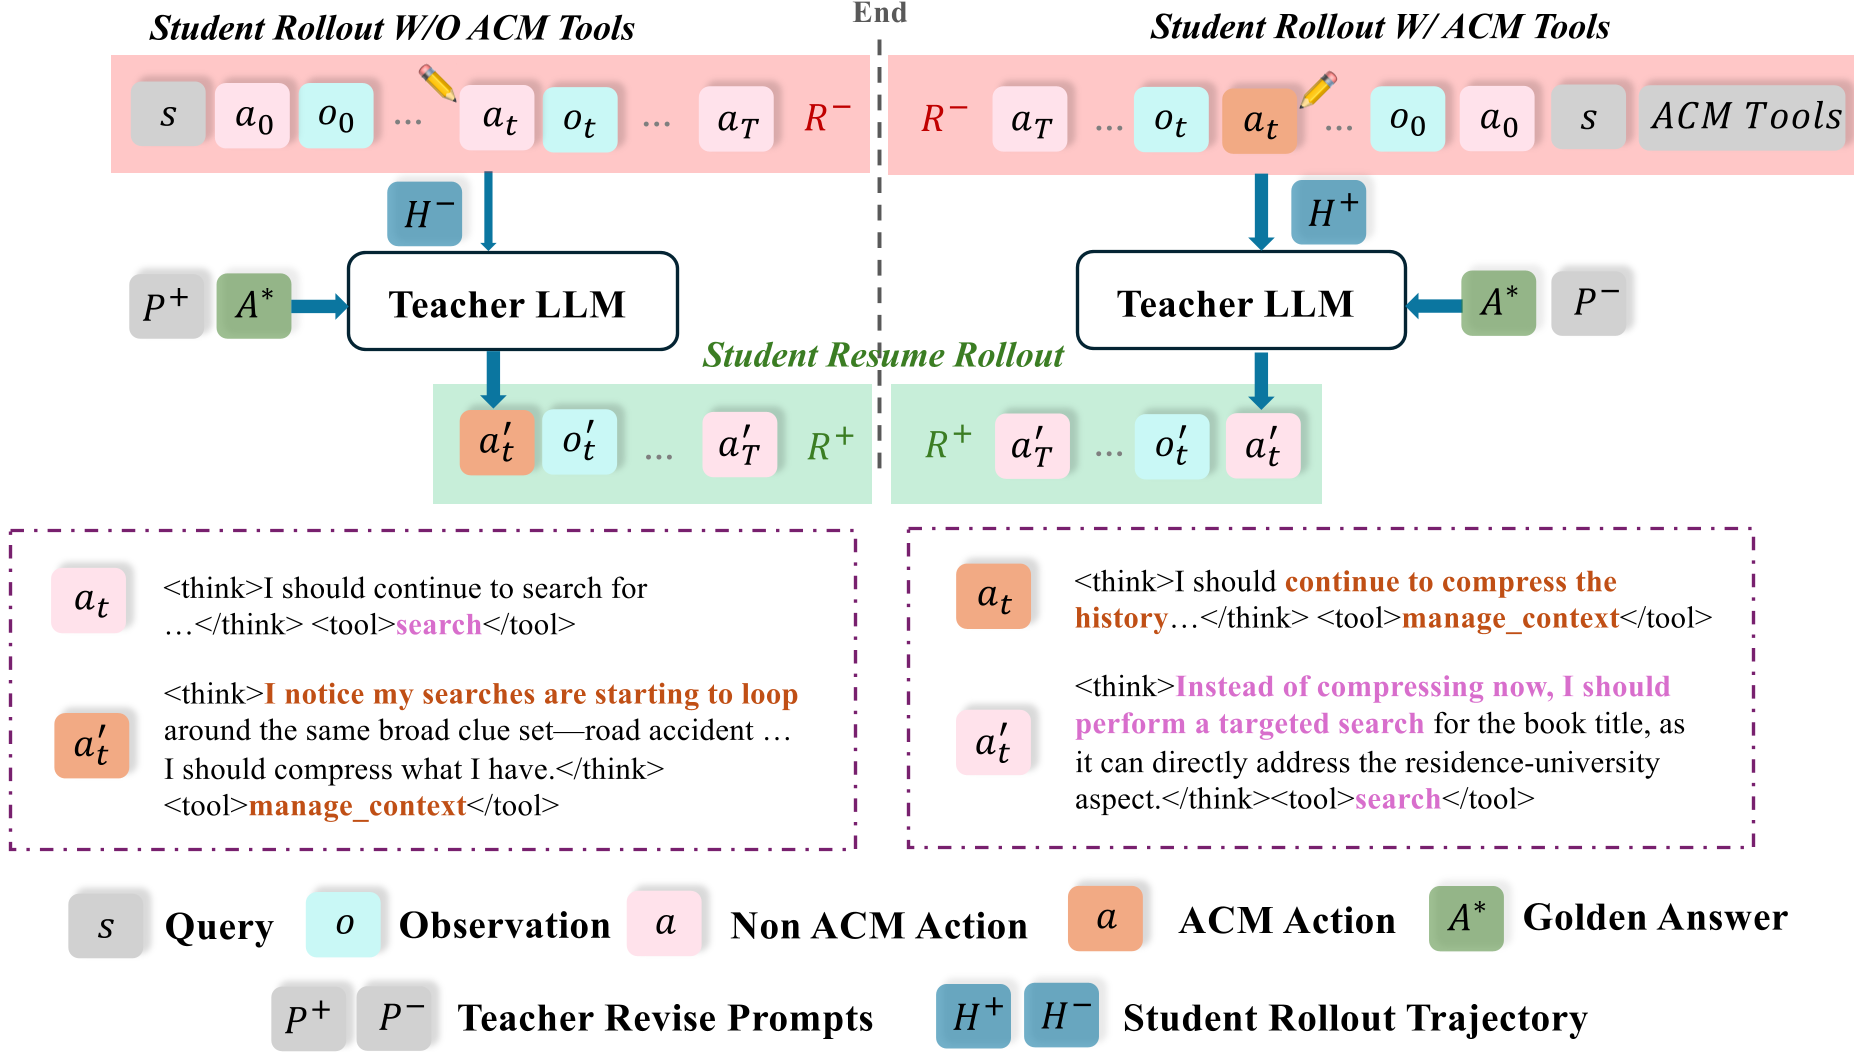
图 2:双约束 pipeline。学生模型在有/无 ACM 工具下分别 rollout,教师模型基于参考答案进行注入或替换,生成高质量演示数据。
训练目标
使用 on-policy 蒸馏损失,学生模型学习匹配教师模型在轨迹中所有 assistant token 位置上的 top-K 分布。通过 rejection sampling 保留有挑战性的失败案例,并过滤掉泄露答案的注释。
实验与结果
主要结果
ACM 在三个长程 Agent 基准上显著超越 ReAct 和 Summary Agent 基线:
| 方法 | BrowseComp-Plus (Pass@1) | DeepSearchQA (Pass@1) | SWE-Bench Verified (Pass@1) |
|---|---|---|---|
| ReAct (Qwen3.5-9B) | 0.570 | 0.367 | 0.489 |
| ReSum | 0.608 | 0.371 | 0.475 |
| ACON | 0.614 | 0.380 | 0.480 |
| ACE | 0.589 | 0.352 | 0.494 |
| ACM Base (无训练) | 0.635 | 0.405 | 0.508 |
| ACM Post-Trained | 0.727 | 0.425 | 0.530 |
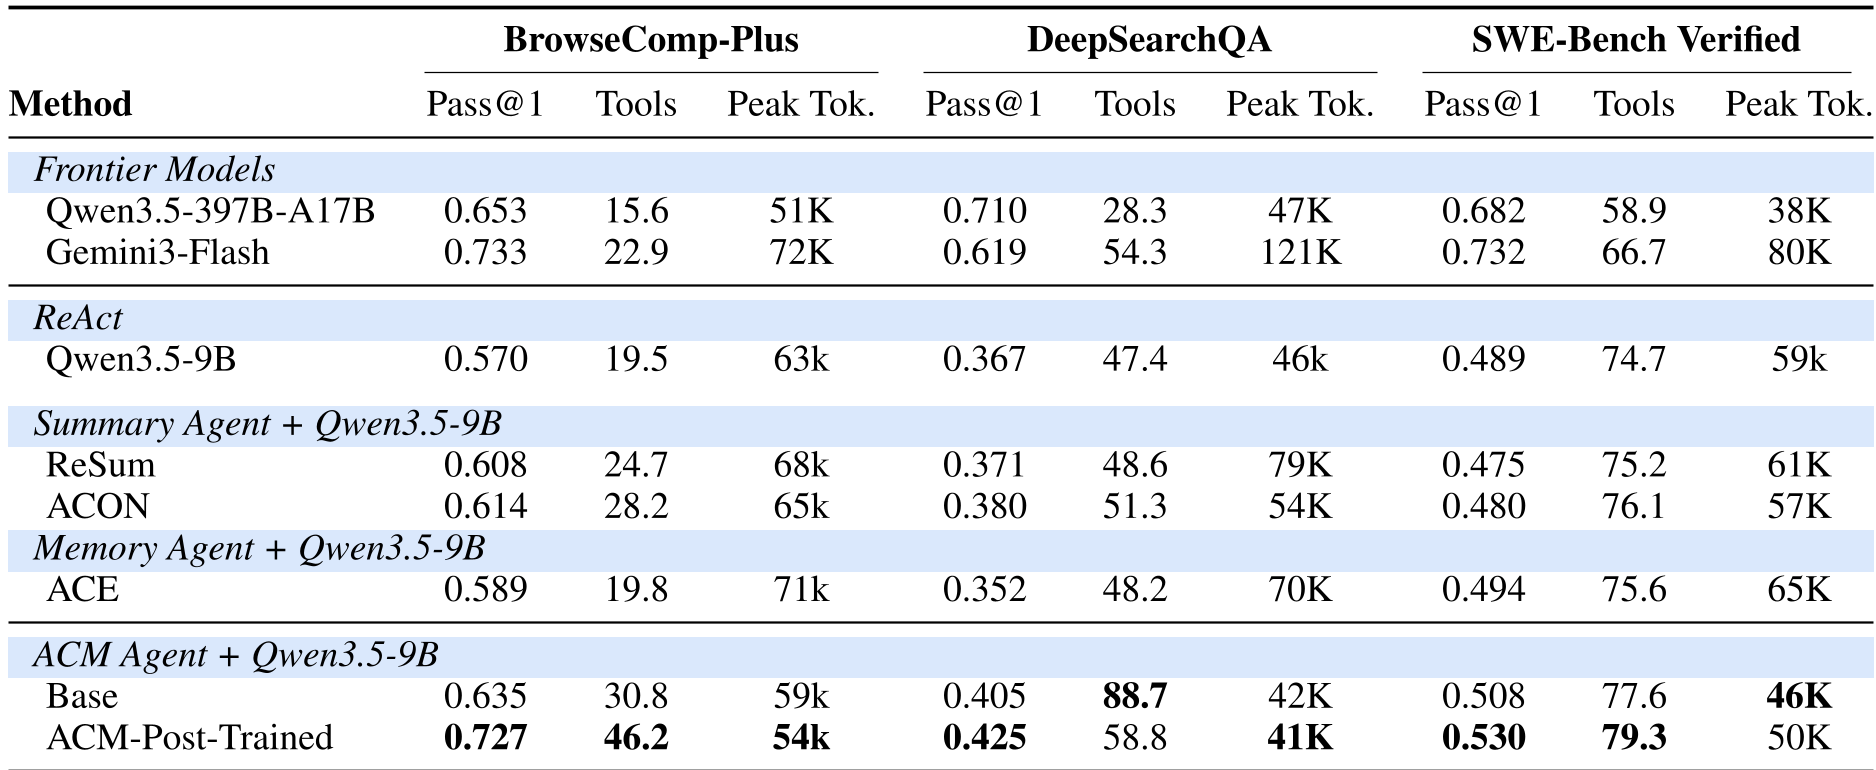
表 2:ACM Post-Trained 在三个基准上均取得最佳 Pass@1,同时峰值 token 降低约 20%。
行为分析
上下文增长动态:ACM 智能体表现出特征性的锯齿状压缩模式(图 3),压缩发生在上下文压力逼近之前,由智能体主动触发。这大幅延长了有效探索步数。
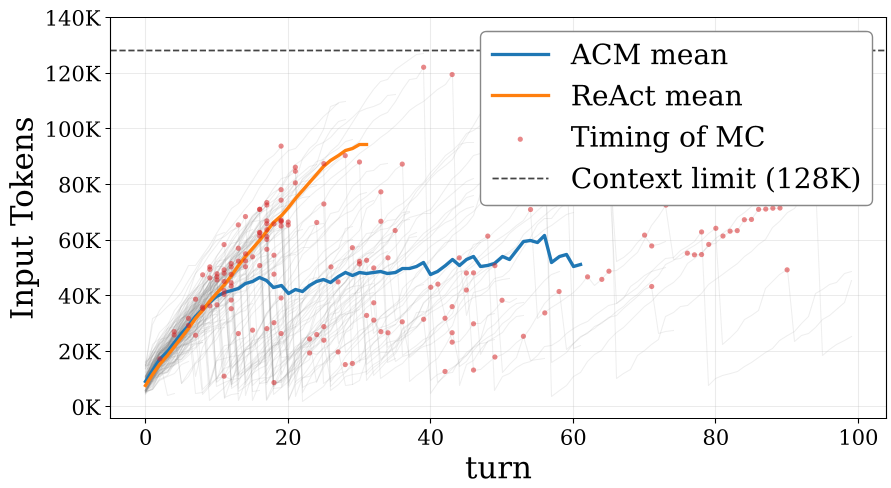
图 3:ACM(蓝色)与 ReAct(黄色)的上下文 token 增长曲线。ACM 智能体在压缩点(红点)后上下文急剧下降,使得总探索步数远超 ReAct。
工具使用分解:训练后的 ACM 智能体比 GPT-5.5 更频繁地使用上下文管理工具,且因此解锁了更多搜索和文档获取调用(图 4)。这表明:即使强模型也需要专门训练才能主动管理上下文。
消融实验
+ACM vs +GPT-5.5 Distill:仅使用 GPT-5.5 蒸馏不如 ACM 数据有效,但两者结合(+Both)在 SWE-Bench 上达到 0.564,证明通用问题求解能力与上下文管理技能互补。
Pass@K 分析:ACM 训练缩小了 Pass@1 与 Pass4 之间的差距(图 5),说明其主要收益不仅在于解决更多问题,还在于使解决方案更可靠、更一致。
深度洞察与总结
核心贡献
- 范式转变:将上下文管理从外部启发式规则转移到智能体自主决策,更符合人类记忆机制。
- 实用流程:开源了完整的双约束数据生成 pipeline,无需 heavy RL 即可训练出有效模型。
- 显著增益:在长程搜索和编码任务上达到接近 40 倍大模型的表现,且峰值 token 大幅降低。
局限性
- 需要基础能力:ACM 仅对本身具备长程推理能力的模型(如 9B 以上)有效。小模型(如 4B)在 few turns 内即放弃,无法体验上下文管理的好处。
- 基线复现误差:由于历史基线未在相同基准上评估,部分对比基线为作者自行复现,可能存在微小差异。
未来展望
- 将 ACM 集成到多模态 Agent(如具身智能、GUI 操作)中,处理更复杂的交互历史。
- 探索更轻量的记忆机制,减少 manage_context 的附加 LLM 调用开销。
- 将上下文管理嵌入模型预训练阶段,使模型原生具备“遗忘”与“回忆”能力。
论文信息:Li et al., "ACM: Agentic Context Management for Long Horizon Tasks", arXiv:2607.23809, 2026. 代码 & 数据