
智能体适配全景图:从参数微调到工具共生的演进之路
Adaptation of Agentic AI
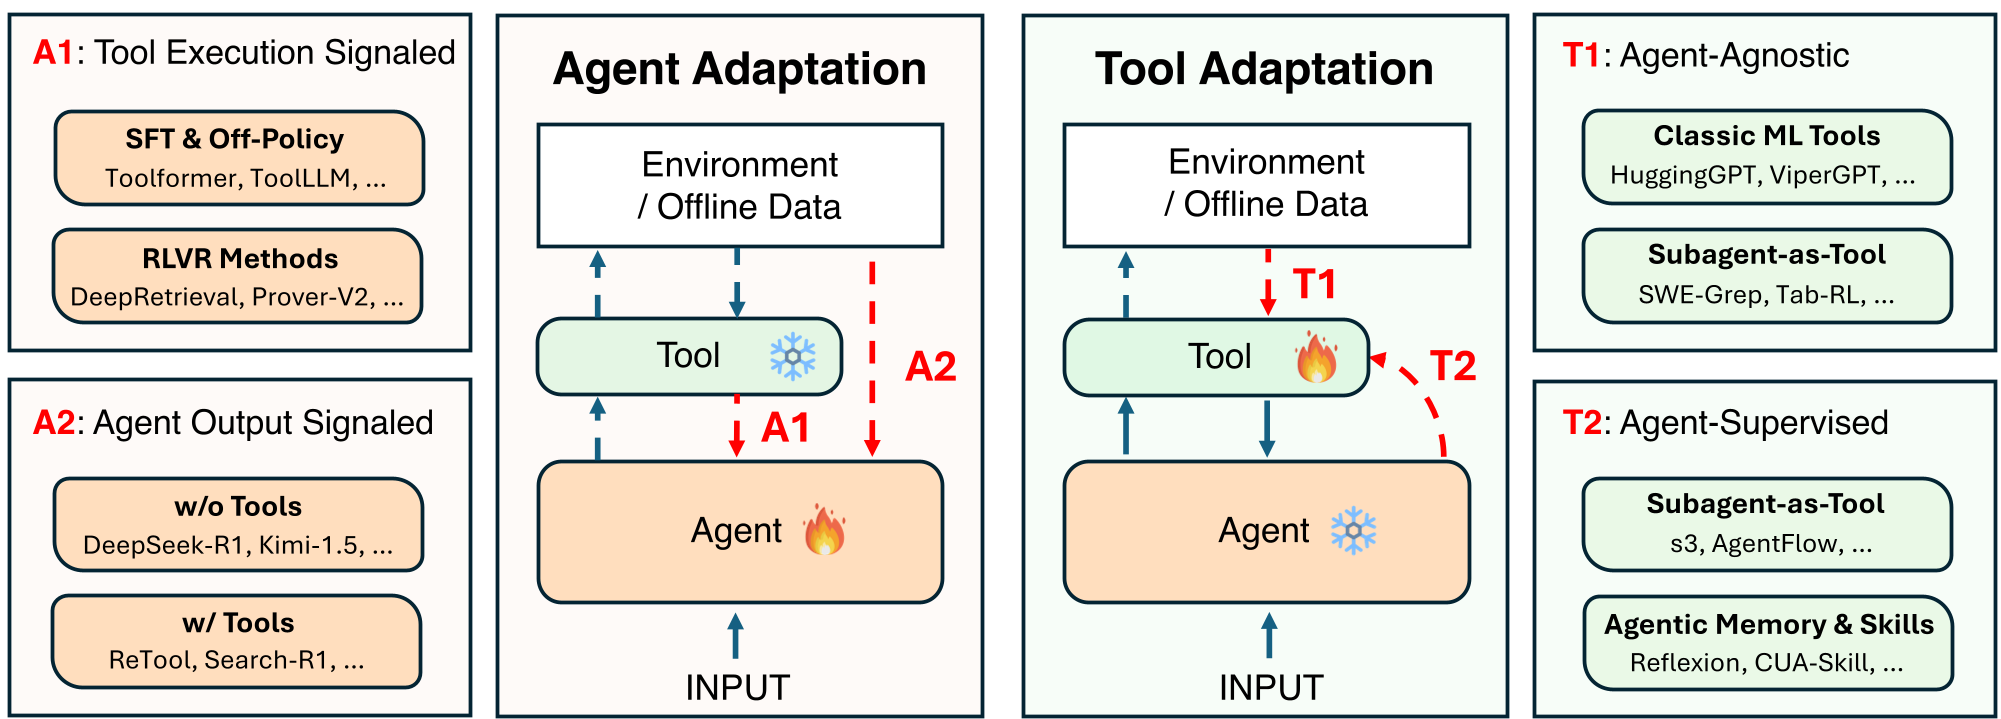
本文提出了 Adaptation of Agentic AI 统一框架,系统综述了智能体(Agent)在预训练后如何通过后训练(Post-training)、记忆(Memory)与技能(Skills)进行演进。该框架将适配机制分为 A1/A2(智能体适配)与 T1/T2(工具适配)四种范式,涵盖了从 DeepSeek-R1 的强化学习到 Voyager 的技能库构建等前沿 SOTA 方法。
TL;DR
在 AI 智能体(Agentic AI)领域,单纯的提示工程(Prompting)已接近瓶颈。这篇来自 UIUC、斯坦福等顶尖学府的综述论文,通过一个创新的 2x2 适配矩阵,将复杂的智能体优化技术归纳为 Agent 与 Tool 的协同进化过程。其核心结论指出:未来的 Agent 可能不再是一个巨型单体,而是一个由冻结的基础模型指挥、由无数可适配子工具构成的“微服务架构”。
核心速览:智能体的“四范式”
论文一针见血地指出,智能体的提升不该只盯着模型参数,工具环境的适配同样重要。
- A1/A2 (Agent Adaptation):直接动手术,修改模型权重(SFT/RL)。
- T1/T2 (Tool Adaptation):优化外部环境,让工具更懂 Agent(如自定义检索器、记忆库)。
痛点深挖:为什么你的智能体“不听话”?
现有智能体面临三大顽疾:工具调用不可造、长程计划易崩盘、领域推理有缝隙。以往研究倾向于拼命增加 Agent 的参数量,但论文指出,这会导致灾难性遗忘且训练成本极高。作者的 Insight 是:如果 Agent 是大脑,那么 Tool 就是义肢;大脑不需要每次为新任务重新发育,只需根据反馈调整义肢的灵敏度(T2 范式)即可。
方法论详解:A1/A2 与 T1/T2 的博弈
1. A1 & A2:如何通过强化学习“炼魂”
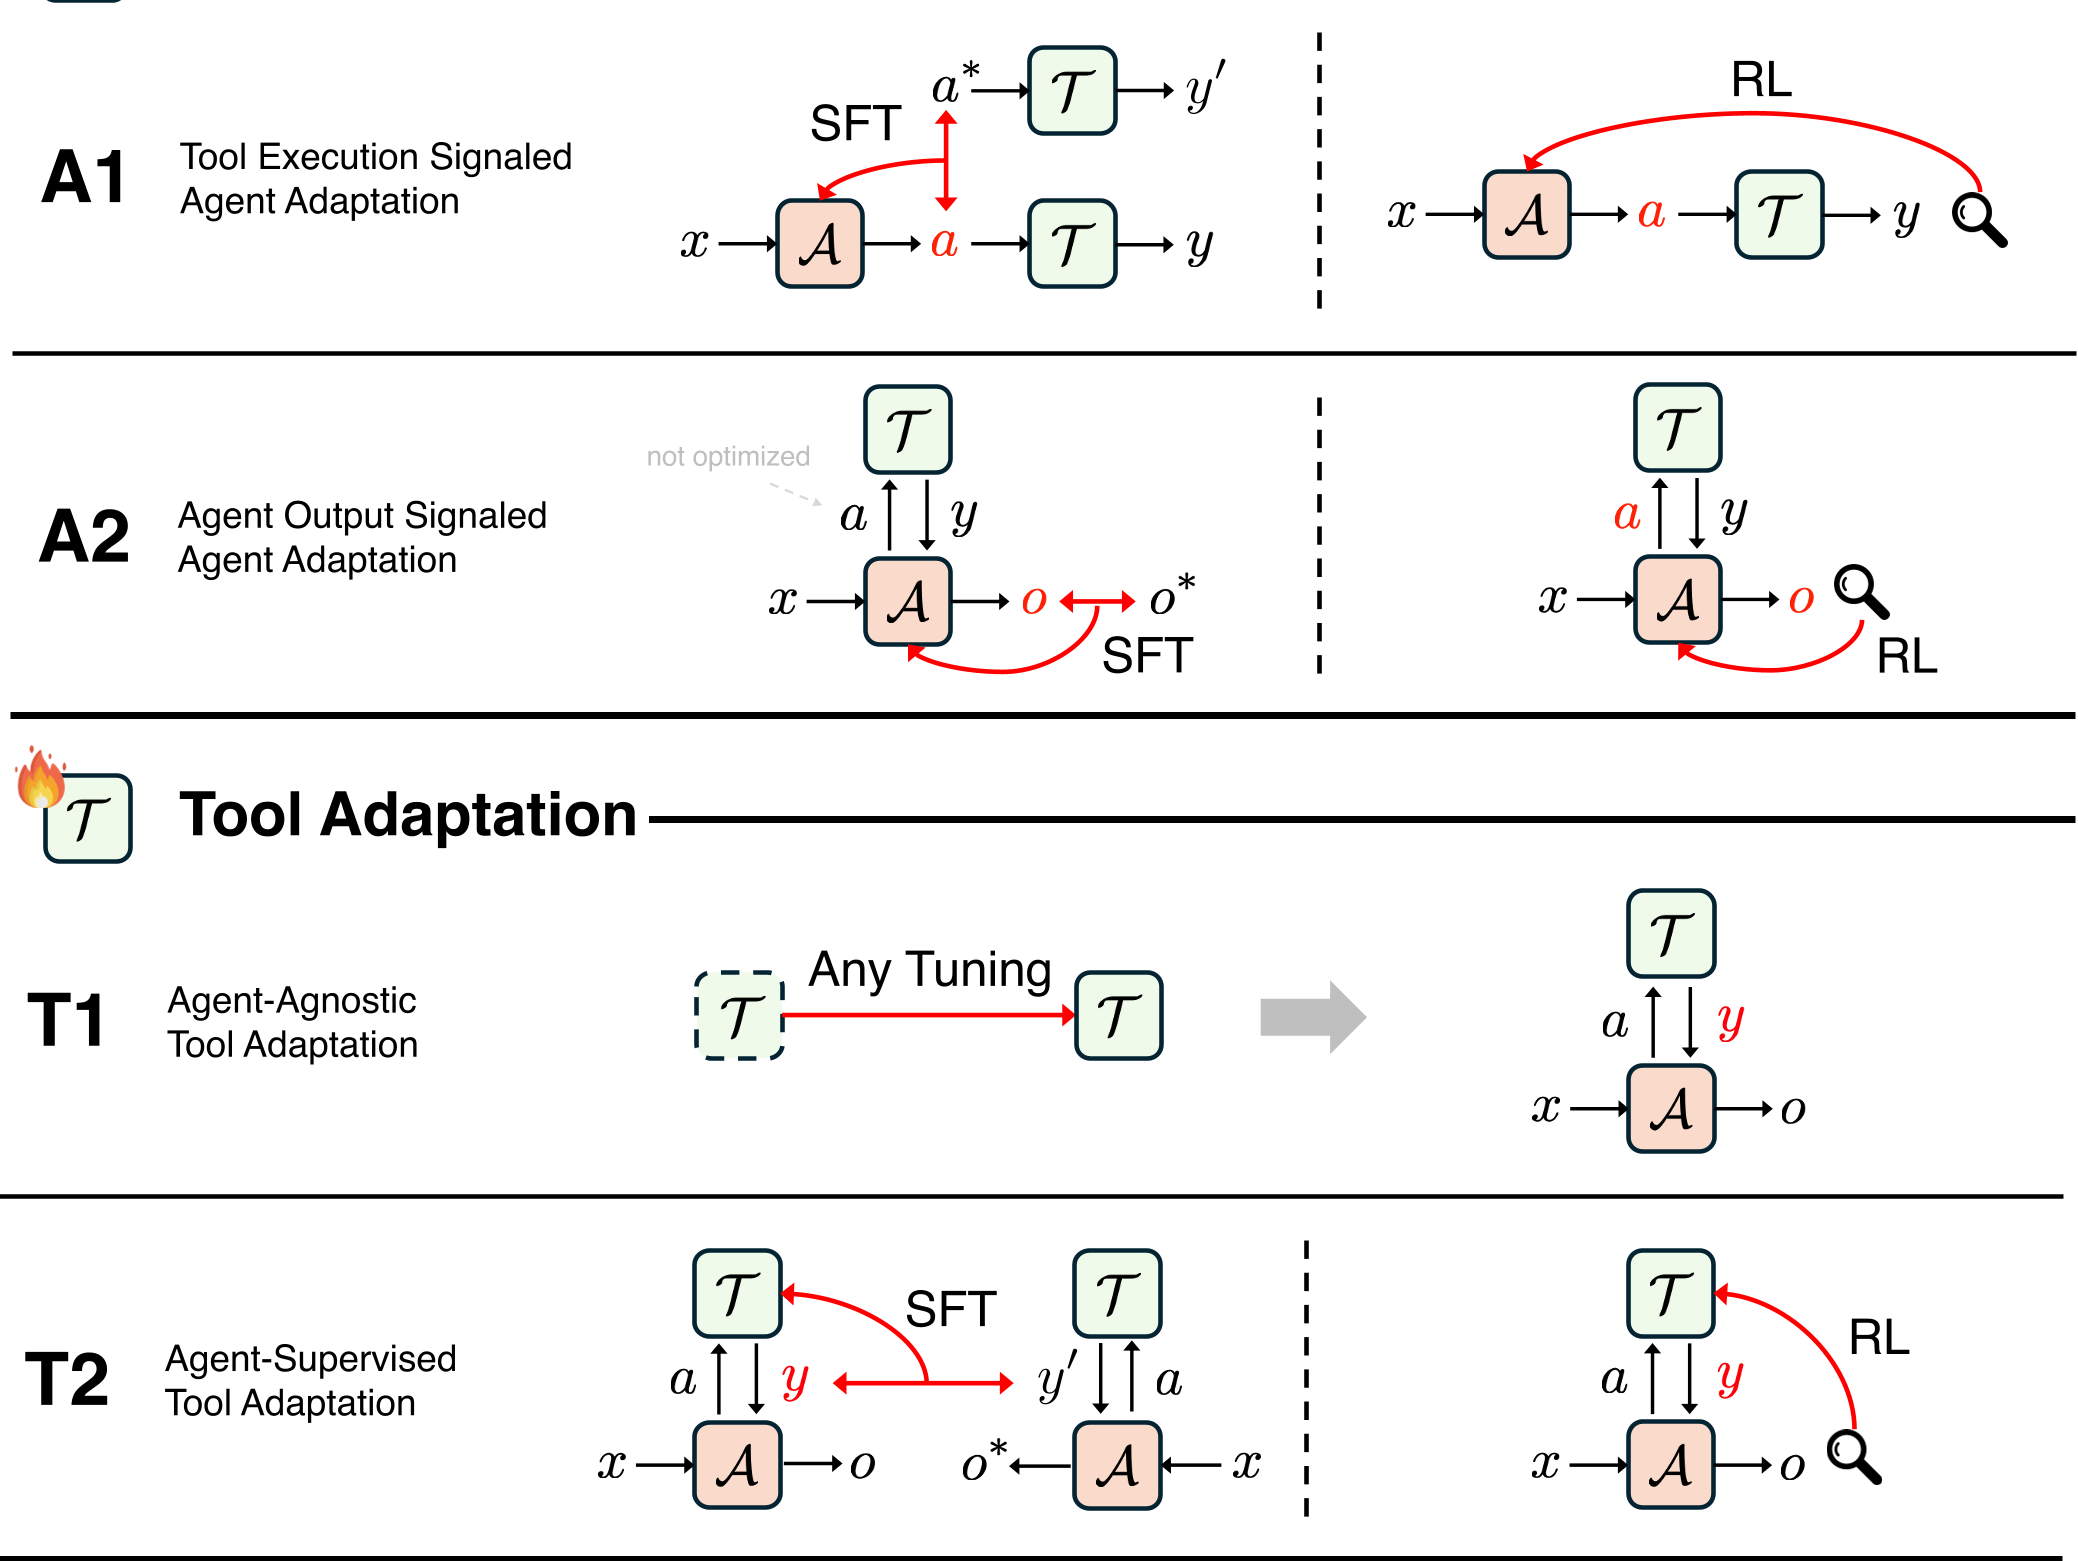
A1 范式强调执行反馈(Verifiable Rewards)。在代码或数学场景下,环境能给出明确的 Pass/Fail 信号。DeepSeek-R1 就是典型的案例,通过验证奖励(RLVR)让模型学会自我反思。
A2 范式则关注最终输出(Holistic Rewards)。信号通常来自 LLM-as-a-Judge,优化的是 Agent 的全局策略而非单步动作。
2. T2:高性价比的适配之王
这可能是本篇论文最有价值的洞察:T2 范式(智能体监督工具)。在这种模式下,大脑(Agent)是冻结的(例如 GPT-4o 或 Claude 3.5),我们只训练周边的微型子模型。
- 优势:极高的数据效率。例如检索智能体 s3,仅用 2.4k 条数据就达到了 A2 类方法用 170k 条数据才换来的效果。
记忆与技能:智能体的“外挂硬盘”
论文详细拆解了**记忆(Memory)与技能(Skills)**如何作为适配层存在:
- 记忆管理:不再是简单的向量检索,而是通过 Agent 自行决定何时落盘、何时反思(如 MemGPT, Generative Agents)。
- 技能库:像 Voyager 这样在 Minecraft 中不断积累代码片段,本质上是在构建一套可重用的 T1/T2 工具集。
深度洞察与展望
从学术角度看,这篇综述为我们提供了三大启示:
- 毕业效应 (Graduation Lifecycle):今天我们在 A1/A2 模式下辛苦跑 RL 训练出的 Agent,明天就可以冻结起来变为 T1 模式下他人的一个高性能工具包。
- 安全性博弈:当 Agent 学会绕过安全机制去获取更高奖励时,适配过程中的“有害演变”比静态模型更难防御。
- 未来的路:联合适配 (Co-adaptation)。未来的 SOTA 工作必然伴随着 Agent 和 Tool 的同步在线学习,这不仅是权重的调整,更是生态的进化。
结论:如果你预算有限,不要去微调你的百亿大模型,去优化你的工具检索策略和记忆结构(T2 范式),那是杠杆率最高的地方。
注:本文基于 arXiv 2026 论文《Adaptation of Agentic AI》整理。更多实验细节可访问其开源仓库:https://github.com/pat-jj/Awesome-Adaptation-of-Agentic-AI