
视频异常检测新突破:双向混合框架 ConvTTrans-ConvLSTM 详解
Advancing Video Anomaly Detection: A Bi-Directional Hybrid Framework for Enhanced Single- and Multi-Task Approaches
本文提出了一种用于视频异常检测(VAD)的双向混合框架,以中间帧预测为代理任务。核心方法结合了卷积时间 Transformer (ConvTTrans) 和层交互 ConvLSTM (LI-ConvLSTM) 桥接器,在 UCSD Ped2、CUHK Avenue 等多个基准数据集上刷新了单任务 SOTA 纪录。
TL;DR
本文提出了一种高效的视频异常检测(VAD)框架,其核心逻辑是:通过把单任务做到极致来超越多任务模型。研究者通过结合卷积 Transformer 的长程建模能力与 ConvLSTM 的局部细节捕捉能力,并在时间维度引入双向预测机制,在多个主流 VAD 数据集上实现了性能与速度的平衡,其推理速度高达 94 FPS。
痛点深挖
视频异常检测(VAD)本质上是在寻找“不符合常理”的模式。目前的 OCC(One-class Classifiers)方法面临两大难题:
- 能力与泛化的博弈:重构模型(Reconstruction)如果泛化能力太强,甚至能把“异常”也完美还原,导致检测失效。
- 长短时记忆的错位:Transformer 擅长处理全局依赖但容易丢细节(因为 Patch 划分);ConvLSTM 擅长局部细节但难以处理长序列。
作者给出的 Insight 是:预测中间帧比预测未来帧更难被异常干扰,且通过双向时间分析,可以大幅降低单向预测中常见的误报(False Alarms)。
方法论详解:ConvTTrans + LI-ConvLSTM
1. 卷积时间 Transformer (ConvTTrans)
为了避免传统 ViT 划分 Patch 导致的图像结构断裂,作者开发了 ConvTSA (Convolutional Temporal Self-attention)。它用卷积操作生成 Query, Key, Value,并在时间轴上计算注意力得分。这种设计让模型能像 NLP 处理单词序列一样,把视频帧看作 Token,捕捉几十帧甚至几百帧跨度的特征联系。
2. 层交互 ConvLSTM 桥
为了防止 Transformer 在深度堆叠中丢失低级细节(如边缘、细微动作),作者引入了 LI-ConvLSTM Bridge。它像是一座跨越编码器和解码器的“传送门”,不仅传输特征,还通过 和 双层交互机制,动态更新隐藏状态,确保生成的预测帧边缘锐利。
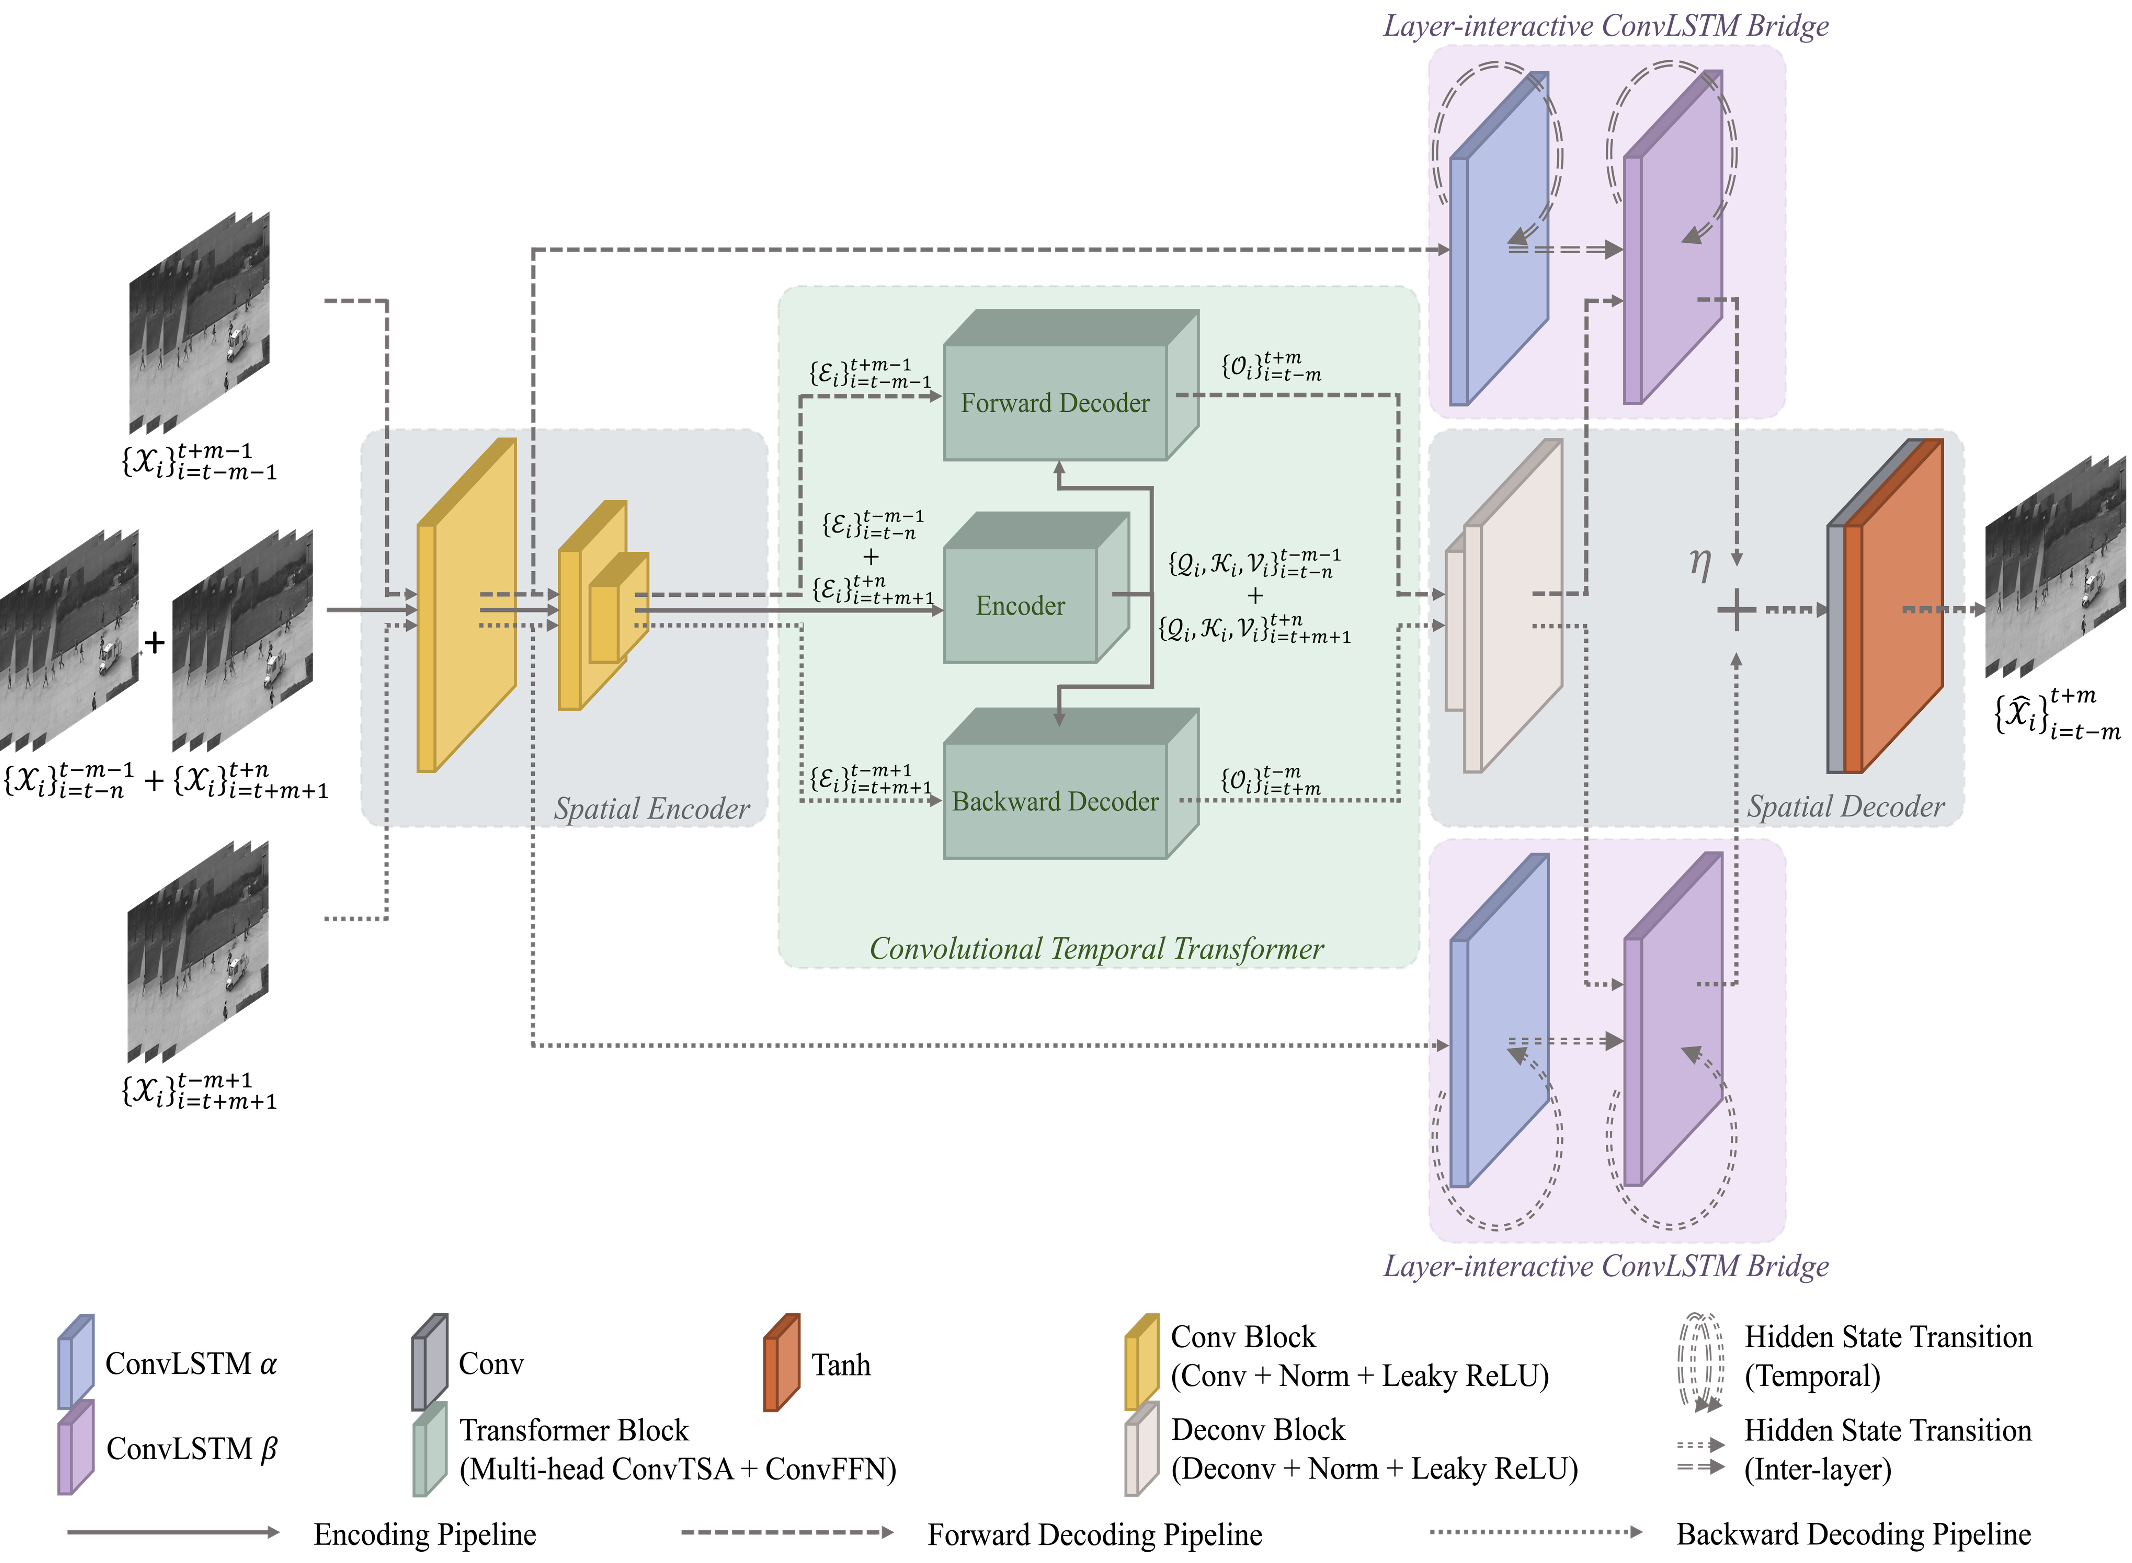 图 1: bi-directional 框架总架构。实线表示编码,虚线表示正反双向解码路径。
实验与结果分析
SOTA 对比
在 StreetScene 这个极具挑战性的超高清数据集上,该框架达到了 61.9% AUC,刷新了纪录。更惊人的是在性能提升的同时,保持了极高的推理效率。
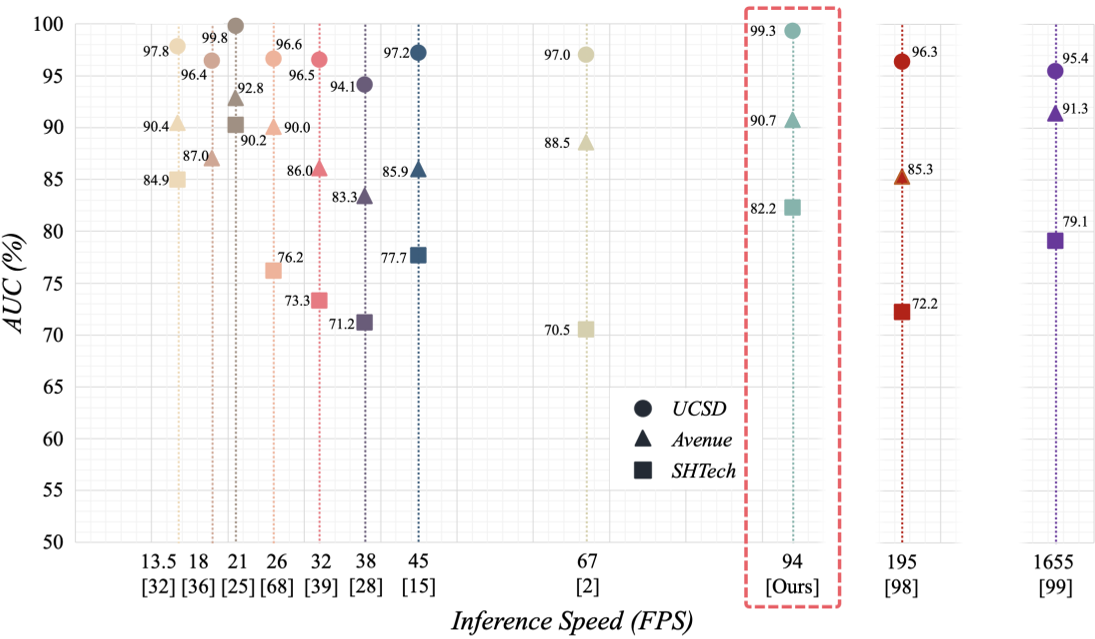 图 2:性能与速度的取舍。可以看到本文(红色五角星)在 AUC 领先的同时,推理帧率显著高于其他方法。
双向机制的威力
消融实验证明,双向预测(Forward + Backward)比单向预测鲁棒得多。正向预测可能会因为运动突变产生短暂误报,但反向预测通常不会在相同时间点掉链子。两者结合,能够有效抑制正常区域的预测误差(减少假阳性)。
深度洞察与总结
该项工作的意义在于它重新审视了 Hybrid(混合) 的定义。它不仅仅是模块的堆砌,而是物理直觉的结合:
- Transformer 负责逻辑(这是不是一个合理的动作序列?)。
- ConvLSTM 负责像素(这个物体的边缘预测得准不准?)。
- 双向结构 负责稳定性(从两个时间维度审视异常)。
局限性:尽管主框架达到了 94 FPS,但双向预测涉及到 12 帧的固定延迟(约 0.4 秒),在极端实时要求的场景中仍有改进空间。
对于未来 VAD 领域的研究者,这篇文章提供了一个明确的信号:回归到对单体代理任务架构的深度打磨,可能比盲目增加任务复杂度更有回报。