
没有中央编排器也能扩到 1024 个智能体:Agensh 把「智能体数量」变成新的 scaling 维度
Agensh: Scaling Organizational Intelligence to 1,024 Agents
本文提出 Agensh,一个没有中央编排器的可扩展自组织多智能体 harness,以共享工作区、消息接口和共享上下文支撑异步协作循环。在 ProgramBench 最难五任务上,智能体从 1 扩到 128 使平均最终测试通过率从 19.31% 升至 28.78%;在 pandoc 上扩到 1024 达到 55.06%。
TL;DR
Agensh 解决的不是某个局部 prompt 技巧,而是多智能体系统的组织层可扩展性:它取消中央 orchestrator,让大量 worker 并发执行「收集上下文、认领子任务、行动、验证、合并」的异步循环,并依靠共享工作区、消息接口和共享上下文把个人进展转成组织贡献。论文在 ProgramBench 最难五任务上固定使用 GPT-5.6-sol (high)、Copilot 和 6 小时预算,将智能体数量从 1 扩到 128,使平均最终测试通过率从 19.31% 升到 28.78%,相对提升约 49%;在 pandoc 上进一步扩到 1024 个智能体,最终通过率从 33.89% 升到 55.06%。更重要的判断是:在底层模型与 harness 不变时,agent 数量本身可以成为新的 scaling 维度,而组织协作模式会随规模涌现出标准化工作流和角色分工。
背景定位
这篇论文属于方法改进与系统工程混合型贡献。它没有训练更强的底层大模型,也没有提出一个全新代码生成算法,而是重写了多智能体系统的协作结构。论文把 Codex sub-agent、Claude Code sub-agent、Copilot fleet、Kimi Agent Swarm 等已有框架概括为 orchestrator-worker 范式,并指出这类范式的关键限制来自中央编排者的管理与整合能力。因此,Agensh 的定位不是单点算法优化,而是在固定模型与固定 harness 的条件下,验证「组织智能」能否通过扩展并发智能体数量来获得收益。判断这一贡献价值的核心依据在实验部分:同一模型、同一时间预算、同一基准下,只改变组织规模,就能看到质量与延迟上的变化。
问题与动机
单智能体系统的边界非常直接:一个 context window、一个 action stream、一个 memory stream。对复杂软件重建这类长周期任务而言,这种串行执行不仅受上下文容量限制,也会把完成时间拉长。已有 harness 用多智能体来缓解这个问题,但多数仍采用中央编排:主智能体负责规划、分解任务、分配 worker,并在最后整合结果。这个结构在中小规模上可行,却把一个组织的协调压力集中到 orchestrator。当 worker 数量增加时,编排者不仅要发现任务,还要追踪每个 worker 的进展、避免重复劳动、合并贡献,并决定哪些中间结果值得全局传播。论文指出,这种能力本身成为系统可扩展性的瓶颈;同时,某些框架还需要训练专门 orchestrator 才能有效分解任务,这进一步限制了通用性。
Agensh 的直觉不是简单增加更多 agent,而是重新定义协调责任:任务发现和分配交给 worker,整合交给共享工作区,沟通交给消息接口,可复用结论交给共享上下文。换句话说,它把「组织如何运转」从模型推理中抽出来,变成一个可运行的协作协议。这个直觉有实验证据支撑,但论文没有给出中央编排器容量瓶颈的形式化模型;它对瓶颈的论证主要来自结构分析、已有框架描述以及 scaling 实验。
核心机制:用自组织循环与共享基础设施取代中央编排器
出发点:中央编排器如何把组织规模锁死
传统多智能体 harness 的问题在于,worker 并不是彼此协作,而是共同依赖一个中心。如图 2 所示,过去工作中多个 agent workers 的合作受中央 orchestrator 容量限制,因为任务分配、上下文汇聚、结果整合都要经过它;Agensh 则让 workers 直接共享状态、广播进展。这个差别很关键:中央编排器既是调度器,也是知识库的写入瓶颈和一致性裁决者。一旦 worker 数量增加,编排器必须持续判断任务优先级、追踪认领状态、识别重复劳动、协调冲突,并决定何时合并。即使底层模型很强,它的 context window 和推理吞吐仍然是单点资源。Agensh 的核心不同在于,让每个 worker 自己决定下一步做什么,而不是等待编排器分配。
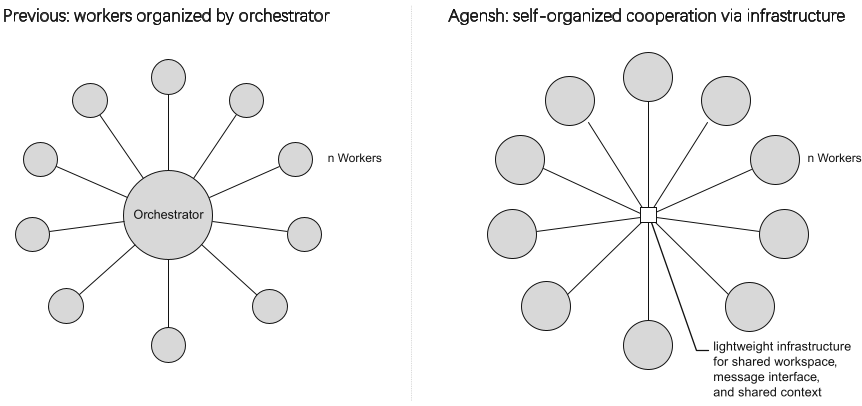
这里有一个容易被忽略的点:去中心化并不意味着没有结构。Agensh 仍然需要严格的组织协议,只是把控制点从中央 planner 移到共享状态与局部判断。中央编排器消失后,系统必须依靠更底层的协调机制来保证贡献可合并、发现可复用、冲突可发现。这正是后文三件套的意义。
核心机制:异步协作循环把个人进展变成组织贡献
Agensh 的 worker 不是一次性执行一个被分配的子任务,而是反复运行一个完整组织循环。Figure 3 显示,每个 worker 并发执行 gather、claim、act、verify、merge 五步:读取共享目标、当前状态、peer 进展和消息,然后提出并认领一个子任务,通过工具在本地行动,期间发布可复用发现,最后验证并把进展合并进共享工作区,再回到下一轮 gather。这个循环的抽象可以用式子表示:
其中 代表单个 worker 的一次协作迭代。 不是普通 prompt 读取,而是把共享目标、peer 进展、消息和积累发现重新注入决策上下文; 让 worker 自己宣布负责范围; 在本地环境中用工具解决该子任务; 要求结果经过检查; 把已验证贡献并入组织共享状态。这个式子的作用是把「多智能体」从简单并行拆任务推进到持续的组织循环:个人进展必须经过认领、验证和合并,才成为组织可复用进展。若去掉 ,每个 worker 只会留下局部分支,组织无法积累完整系统;若去掉 ,多个 worker 容易重复编辑同一区域,冲突需要靠中央调度避免;若把 改成中央分配,则又回到 orchestrator 瓶颈;若要求所有 worker 同步进入下一轮,则异步性消失,延迟收益会显著下降。
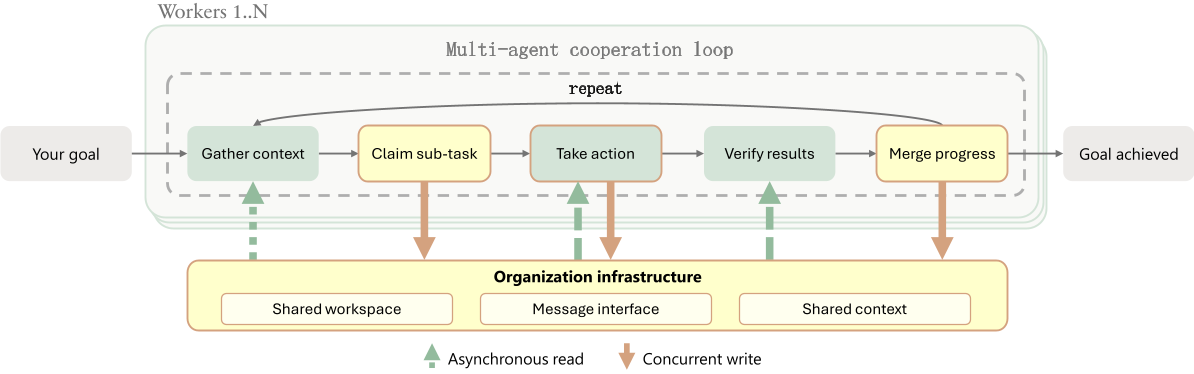
异步性是 Agensh 区别于「并行 worker 返回父节点汇总」的重要设计。论文指出,worker 不需要等待其他 peers 完成一轮迭代,每个 worker 在完成自己的 merge 后继续 gather 最新共享状态。这样做的收益是高吞吐:更多 agent 可以在同一时间预算内同时探索不同子模块。风险也来自这里:如果没有共享状态和合并协议,异步会放大重复劳动和语义冲突。因此 Agensh 不是简单把多个 agent 扔到同一任务,而是把组织状态外化为可访问、可检索、可合并的基础设施。
设计理由:为什么是 Git 工作区、消息接口和共享上下文
Agensh 的组织基础设施有三类:shared workspace、message interface、shared context。Figure 4 说明三者分别承载组织的工作物、沟通事件与可复用发现。这个选择不是任意组合,而是针对软件工程任务的约束:代码贡献需要版本控制与合并机制,任务冲突需要及时通信,发现与失败经验需要跨 worker 复用。论文实现中使用 Gitea 管理共享工作区,使用 Mattermost 提供消息接口,并采用 DeLM 式 shared context 保存结构化条目。Shared context 中的条目包括 OBSERVED、FACT、FAIL、CLAIM 和 PATCH_SUMMARY,这些类型分别对应观察到的参考行为、已确认事实、被证伪的路径、正在进行的工作范围,以及完成改动后的摘要。
为什么不是把所有东西都塞进一个中央任务队列?因为中央队列仍然依赖一个控制器来排序和分配。Agensh 把任务分配下沉到 worker 的 claim 行为,把协调责任交给 Git 分支、issue、pull request 和消息通道。为什么不是只用共享文件系统?因为文件系统只能告诉别人「代码现在是什么样」,不能高效表达「谁在做什么」「某个假设已被证伪」「哪块行为刚刚被确认」。共享上下文补足这一点:它让 FAIL 这类负结果成为高价值信息,阻止其他 worker 继续浪费预算。为什么不是只用聊天?因为消息适合紧急协调和冲突处理,不适合长期保留可复用事实;append-only shared context 配合 board grep 让历史发现可检索,支持长任务周期。
这种接口设计还有一个工程判断:Agensh 是 layered on top of a single-agent harness,而不是替换底层 agentic loop。每个 worker 的本地推理、工具调用和对话状态仍由底层 harness 管理;Agensh 负责组织级身份、事件路由、共享工作区访问、消息、上下文、恢复和 liveness。协作循环通过 prompt 中的 workflow instructions 实现,而不是硬编码进 runtime。这个设计的优点是 plug-and-play:论文称可以通过轻量适配器连接到 Claude Code、Copilot 等不同底层 harness。缺点是协作协议依赖 prompt 稳定性,而论文没有提供针对 prompt 漂移、冲突合并失败或消息延迟的定量消融。
实验与证据
任务强度:最难五任务要求从二进制逆向重建大型仓库
实验使用 ProgramBench。任务要求 agent 组织在 6 小时预算、禁止 Internet access 的条件下,从预编译 reference program 出发重建完整 codebase,并通过 hidden tests。论文选择 ProgramBench 中最难的五个系统:FFmpeg、gromacs、pandoc、PHP-src 和 ctags。Table 1 显示这些参考仓库规模巨大,从 pandoc 的 104,336 行代码到 PHP-src 的 2,812,757 行代码,文件数从 2,767 到 26,266 不等,代码大小从 4.86 MB 到 119.76 MB。这个设置非常适合检验长周期组织协作:agent 只能运行 binary 观察行为,不能读取 binary bytes,不能联网抓取原始源码,必须自己定义需求、分解工作、合并提交。
Table 1 报告了五任务参考仓库规模:
| 参考软件 | 提交 | 文件数 | 代码行数 | 代码大小 MB |
|---|---|---|---|---|
| FFmpeg | 360a402 | 10,090 | 1,549,005 | 75.51 |
| gromacs | 665ea4c | 8,982 | 815,539 | 47.30 |
| pandoc | 5caad90 | 2,767 | 104,336 | 4.86 |
| PHP-src | c891263 | 26,266 | 2,812,757 | 119.76 |
| ctags | 243595e | 7,313 | 246,228 | 9.15 |
这张表说明 scaling 实验的难度边界。它不是小型单元测试生成,也不是局部 bug fix,而是接近真实软件工程中的 reverse rebuild:组织必须在一个封闭环境里同时完成行为发现、架构设计、代码实现、测试验证和集成合并。五任务覆盖多媒体处理、分子模拟、文档转换、语言解释和代码索引,也降低了单个领域偶然性带来的偏差。
主结果:智能体数量带来质量提升,并且改善达到性能的时间
Figure 5 给出了五任务平均最终测试通过率随 agent 数量变化的结果。论文使用同一个 GPT-5.6-sol (high) 模型、同一个 Copilot 底层 harness、同一 6 小时预算,仅改变组织规模。1、8、32、128 agents 对应的平均通过率分别为 19.31%、20.68%、26.52%、28.78%。
| 智能体数量 | 1 | 8 | 32 | 128 |
|---|---|---|---|---|
| 五任务平均最终测试通过率 | 19.31% | 20.68% | 26.52% | 28.78% |
这组数字的关键不在绝对性能是否足够高,而在同一模型同一 harness 下,组织规模本身带来了性能增益。主要差异可以写成:
其中 表示 1 个智能体在五最难任务上的平均最终通过率, 表示 128 个智能体的平均最终通过率, 是两者之间的 percentage-point 差距。这个式子在论文论证链中的作用是把「更多 agent」从定性叙事变成可量化的 scaling gain:组织规模从 1 到 128 带来 9.47 个百分点提升,相对提升约 49%。若只看百分比点,提升似乎不大;但考虑到 baseline 本身只有 19.31%,且任务禁止联网、需要重建大型仓库,相对改善说明组织协作确实扩展了同一模型能完成的工作边界。需要区分的是,49% 是相对增益,不是绝对通过率达到 49%;后者仍远未解决五任务。
Latency 方面的证据同样重要。论文 Figure 6 显示,在 6 小时运行前 2 小时里,更大组织通常更早达到相近通过率。以 pandoc 为例,128 agents 在 30 分钟 checkpoint 超过 30% test-pass rate,32 agents 在 60 分钟超过该阈值,8 agents 在 90 分钟才超过,单 agent 在前 2 小时始终低于该阈值。这说明 agent 数量不只是提升终点质量,也缩短到达某个性能水平的等待时间。对具有硬 deadline 的工程任务,这一结论比单纯提高 final score 更具实践意义。
pandoc 扩展:从 128 到 1024 仍有增益,但边际收益趋缓
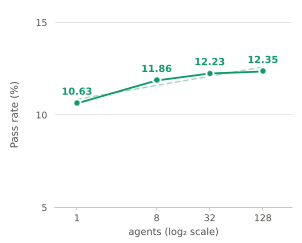
论文进一步把 pandoc 上的组织规模推到 1024 agents。Figure 1 显示,在同样 6 小时预算、无 Internet access 条件下,pandoc 最终测试通过率从 1 个智能体的 33.89% 提升到 128 个智能体的 50.94%,再提升到 1024 个智能体的 55.06%。
| 设置 | 1 个智能体 | 128 个智能体 | 1024 个智能体 |
|---|---|---|---|
| pandoc 最终测试通过率 | 33.89% | 50.94% | 55.06% |
这组数字可以形式化为:
其中 表示 pandoc 任务的最终测试通过率。这个式子承担两个论证功能:第一,它证明 Agensh 的 scaling 不限于 128 个智能体,能继续扩展到 thousand-agent organization;第二,它也暴露边际收益递减:从 128 到 1024 只额外带来 4.12 个百分点。相比 1 到 128 的巨大改善,1024 阶段增益明显变小。这与五任务平均结果的形状一致:32 到 128 的增量已经从 8 到 32 的较大跃升回落到 2.26 个百分点。论文没有给出计算成本归一化指标,因此无法判断这些增益是否值得千倍 agent 规模,但实验至少说明千级组织可以持续贡献可测量进展。
轨迹证据:协作形态随规模从 peer coordination 到 role specialization
除了 pass rate,论文从 recorded trajectories 中提取了不同规模下的组织行为。8 agents 阶段出现 peer coordination:worker 之间可以约定接口并独立实现组件,也可以通过消息处理重叠 claim。32 agents 阶段出现 multi-worker integration:多个 peers 参与审批、反例发现、撤销 approval、再次 review 和合并。128 agents 阶段出现 specialization 和 workflow standardization:worker 会根据 prior experience 选择 reviewer,并重复使用 review relationship;在 pandoc 中出现标准化集成协议,例如 author 更新和测试 branch,发送 commit hash 给 peer validation 和 merge,后续其他 worker 复用该协议。1024 agents 阶段出现 organization-scale role specialization:多个 workers 承担 integrator 角色,author 可以联系多个 candidate integrator,选择第一个有效 responder,再 cancel 其他请求;同一技术领域 specialist 还能在另一个 worker 失败后接手,增强组织鲁棒性。
这些观察的价值在于解释 scaling 为何可能有效:更多 agents 不只是增加算力,而是增加组织内部可形成的关系、角色和工作流。不过它们是定性轨迹分析,不是严格消融实验。论文没有比较「有 shared context 但无 message interface」或「有 Git 但无 claim protocol」等配置,因此无法定量分离每个基础设施组件对 pass rate 的因果贡献。
证据质量:固定模型下有效,但范围与成本证据仍有限
这篇实验设计的强项是控制变量:五任务主结果中,底层模型、harness、prompt protocol、evaluation configuration 和 6 小时预算保持固定,主要变化是 agent 数量。因此 19.31% 到 28.78% 的提升更可能归因于组织扩展,而不是模型切换。Table 1 中的任务规模和 Figure 5、Figure 6 中的结果共同说明这是真实长周期任务,而非玩具基准。pandoc 的 1024 agents 结果也显示该 harness 能支持超过千级 worker,并分布在 16 个节点上,每节点 64 agents。
局限性同样明确。第一,1024 agents 的完整 scaling 只在 pandoc 上报告,五任务平均最高扩展到 128 agents,因此「1024 对组织智能普遍有效」还不能由论文直接支撑。第二,论文没有提供与中央编排器系统在同一任务、同一模型、同一预算下的定量对照;它论证了 orchestrator-worker 的结构限制,但没有展示 Agensh 相比某个具体 orchestrator baseline 提升多少。第三,没有报告每个 agent 的 token、API 调用、GPU 或基础设施成本,因此无法判断 pass rate gain 是否被千倍 agent cost 抵消。第四,单 agent baseline 为维持 6 小时运行加入了 stop hook 和 idle detector,这种处理是合理的工程修复,但也意味着 baseline 并非纯粹默认运行;不过多 agent 也有 idle detector,至少部分保持了公平。
深度洞察与总结
Agensh 的核心贡献不是证明「更多 agent 更好」,而是给出一套让组织规模可操作化的系统机制:worker 自己 claim,共享工作区承载代码贡献,消息接口处理紧急冲突,shared context 保存 typed findings。中央编排器被拆解后,组织的可扩展性从 planner 的推理容量转移到基础设施的并发访问和合并能力。论文中的 scaling 数字说明这种拆解有效:在 GPT-5.6-sol (high) 固定条件下,128 agents 使五任务平均最终通过率提升 9.47 个百分点;pandoc 上 1024 agents 比单 agent 提升 21.17 个百分点。同时,轨迹显示协作模式随规模涌现,说明 agent 数量不仅是算力倍增器,也可能改变组织本身的结构。
这项工作对后续研究最有价值的启示是:多智能体 scaling 不能只报告最终 pass rate,还必须报告协调机制、合并成本、冲突处理和计算开销。未来方向不应停在「更多领域扩展」,而应聚焦几个可证伪问题:在什么任务结构下 128 到 1024 的增益会提前饱和;如果加入中央 review agent 是否会减少合并冲突却牺牲延迟收益;shared context 的 FAIL 和 CLAIM 条目能否用定量指标预测后续 pass rate;Git merge conflict 能否被 semantic-aware integration policy 替代。Agensh 给出的是一条工程路径:当模型能力固定时,组织智能仍可能通过并发自组织协作获得真实增益。