
Agent-World:让智能体在数万个真实环境中自我进化
Agent-World: Scaling Real-World Environment Synthesis for Evolving General Agent Intelligence
本文推出了 Agent-World,一个用于提升通用智能体能力的自我演化训练竞技场。该框架通过大规模自动合成真实世界的交互环境和可验证任务,并配合多环境强化学习,实现了智能体策略与环境的协同演化。
TL;DR
传统的智能体(Agent)训练往往在死板的静态数据集上进行,导致其在面对复杂的真实世界工具链时频繁“翻车”。来自中国人民大学和字节跳动的研究团队发布了 Agent-World,它不仅是一个包含 2000 多个真实环境和近 2 万个工具的训练营,更是一套能让 AI 智能体根据自身弱点“缺啥补啥”、自主合成任务并进化的闭环系统。在 23 项硬核跑分中,该方法的 14B 模型甚至在部分交互任务上超越了 DeepSeek-V3 和 GPT 系列。
痛点深挖:为什么 Agent 总是不够“聪明”?
目前的智能体研究面临两个核心瓶颈:
- 环境虚假(Hallucination in Simulation):很多训练环境是靠 LLM 模拟出来的,缺乏真实的数据库底层。一旦涉及长程(Long-horizon)操作(例如:查库存 -> 下单 -> 改日历),模拟环境往往无法准确维持状态的一致性。
- 能力的“天花板”效应:现有的模型通常是单轮静态训练,缺乏一个像人类那样“通过错题集自我提升”的机制。
核心机制:Agentic Environment-Task Discovery
Agent-World 的第一步是环境大爆炸。研究者不再手动写死环境,而是通过一个“深度研究 Agent”去互联网挖掘主题,通过数据库复杂化(Complexification)技术,生成了包含 JSON, CSV, SQL 等多种格式的真实数据库,并利用代码 Agent 为这些数据库量身定制可执行的工具接口。
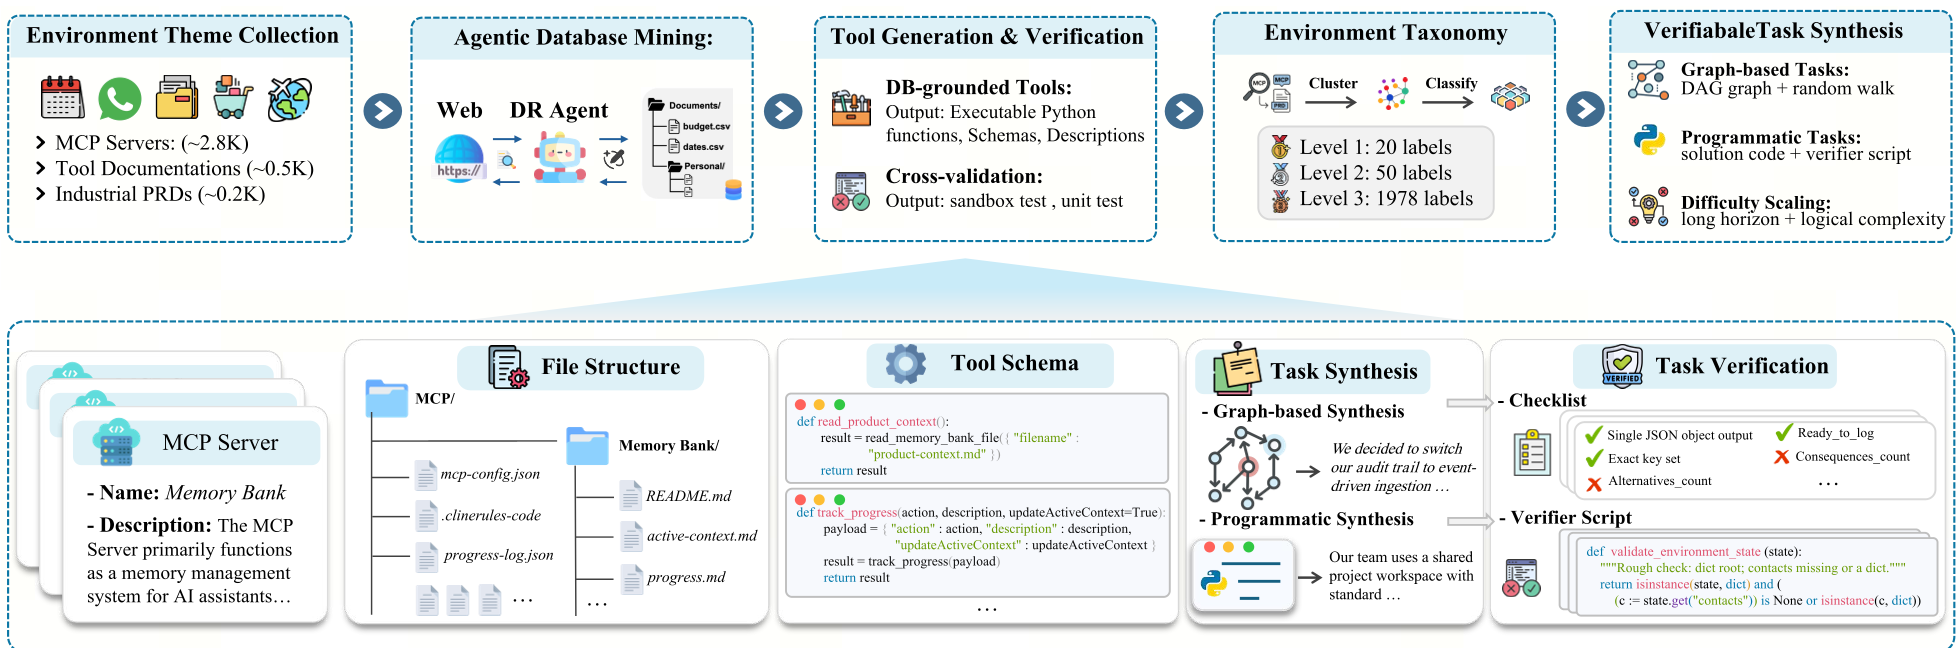 图 1:环境与任务发现流程。从真实主题出发,通过深度研究挖掘数据,最终生成可验证的挑战性任务。
为了保证任务的难度,Agent-World 引入了两种合成策略:
- 基于图的任务合成:利用工具间的依赖关系(强依赖/弱依赖)构建图,通过随机游走生成逻辑严密的工具调用链。
- 基于编程的任务合成:生成需要循环、条件分支和跨表聚合的复杂 Python 脚本作为 Ground-truth 答案。
演化引擎:Continuous Self-Evolving Agent Training
这是本文最具洞察力的部分。作者没有停留在“如何产生数据”,而是思考“如何让训练更高效”:
- 多环境 RL:基于 GRPO (Group Relative Policy Optimization) 算法,智能体在数千个动态沙盒中进行 Rollout。
- 可执行奖励控制:拒绝模糊的 LLM 评分,系统直接运行 Python 脚本来校验数据库状态是否被正确修改。
- 自我诊断竞技场:系统自动评估当前模型的弱点(例如在处理特定类型的 SQL 注入或 API 调用时出错),随即命令“环境合成器”专门生成针对这些弱点的垂直训练数据。
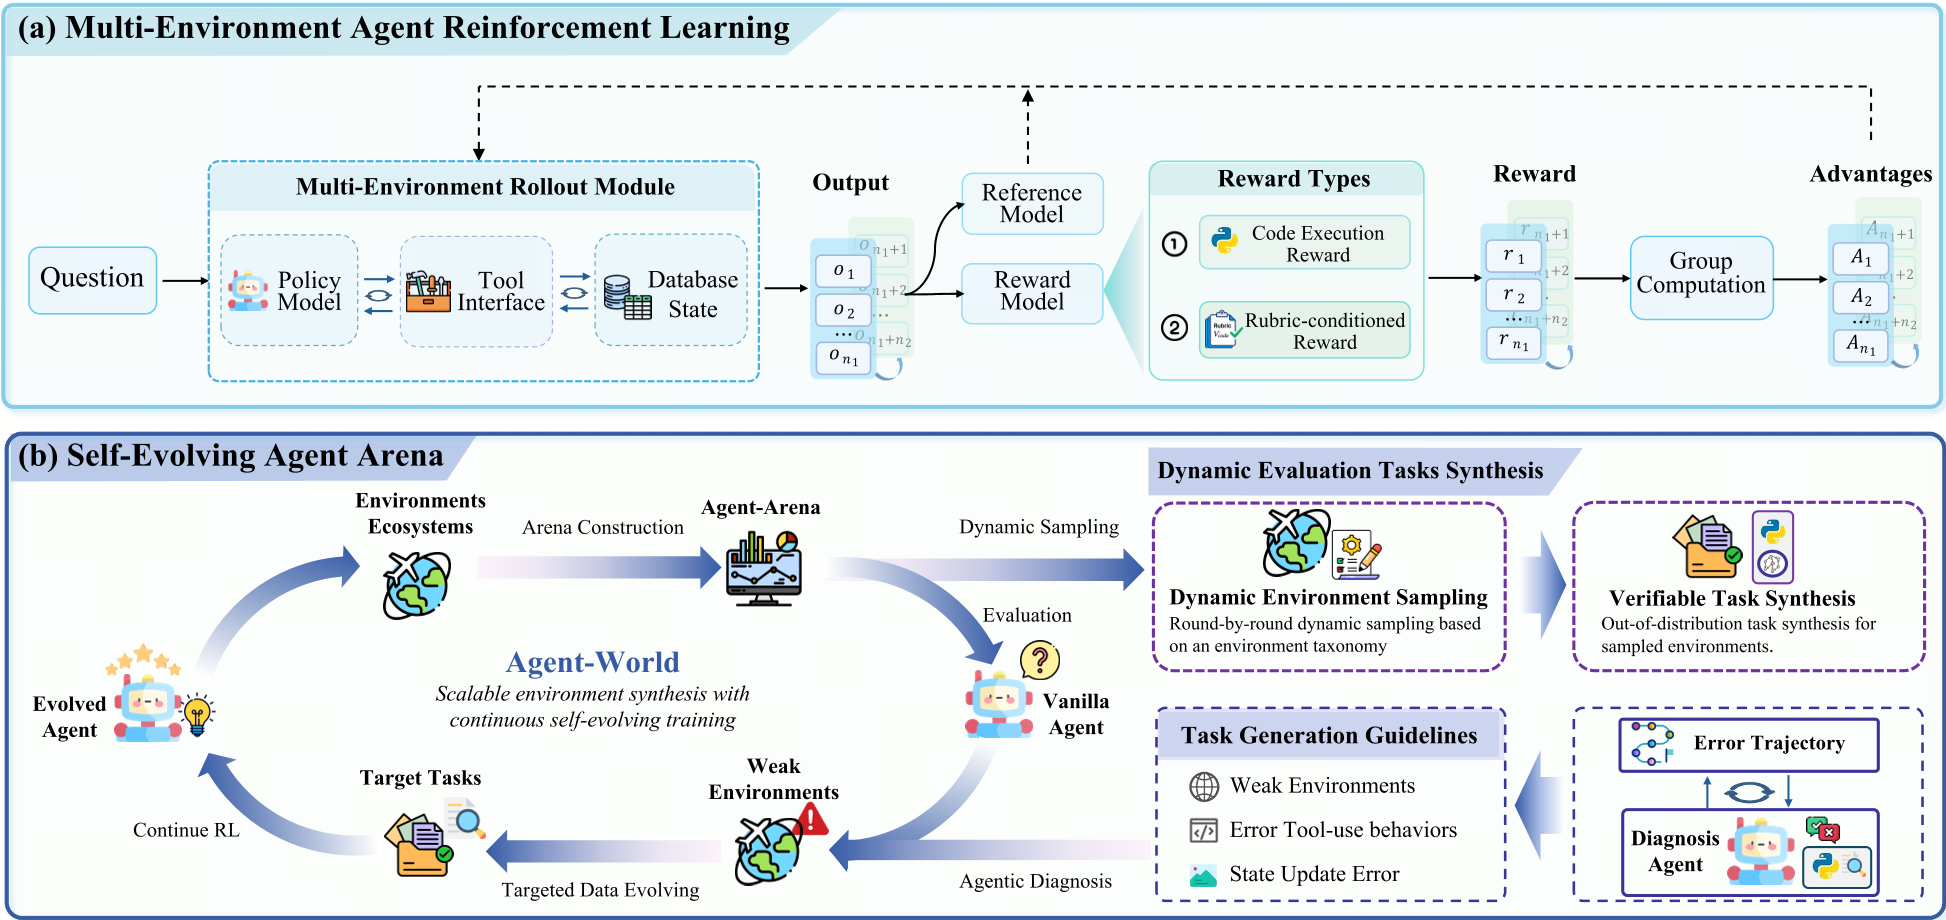 图 2:Agent-World 自演化框架。通过不断诊断失败轨迹,驱动环境和策略的协同演化。
实验战绩:跨规模的稳步提升
在大规模实验中,Agent-World 展示了极强的扩展性:
- 性能超越:Agent-World-14B 在 BFCL V4(工具调用基准)上达到了 55.8%,直接超越了参数量大得多的 DeepSeek-V3.2-685B。
- Scale 规律:随着动态环境数量从 10 增加到 2000,模型在下游任务(如 MCP-Mark)上的表现呈现出近乎线性的增长。
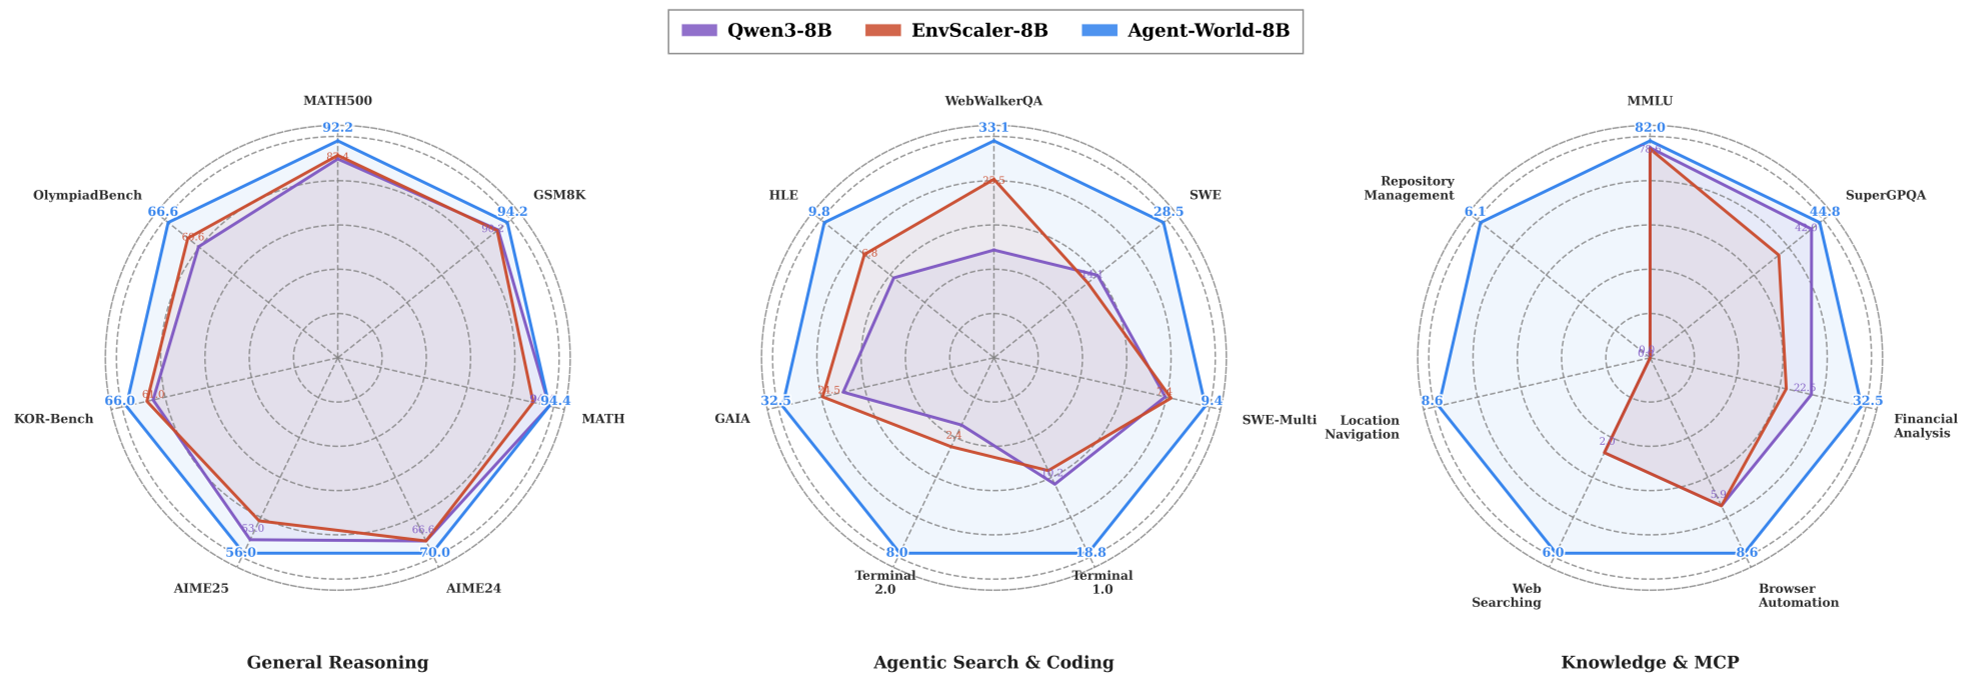 图 3:跨领域泛化能力对比。可以看到 Agent-World 在通用推理、搜索编程和 MCP 环境下均展现出领先基线的鲁棒性。
深度洞察与总结
Takeaway:未来的智能体竞争,核心竞争力不再仅仅是模型参数的大小,而是其背后的“世界模型”——即环境中交互数据的规模与真实性。Agent-World 揭示了一个趋势:通过 MCP (Model Context Protocol) 等统一协议将 AI 连接到真实的工具生态,再通过“强化学习+自我诊断”的闭环,可以让小尺寸模型在专业工具操作上具备挑战巨头的实力。
局限性:尽管环境规模达到了数千,但依然主要集中在文本和结构化数据。未来如果能引入视觉 GUI(如屏幕操作)或实时异步环境,其通用性将进一步增强。