
Agent A/B:让 AI 代替人类“跑”实验,重塑 A/B 测试的未来
AgentA/B: Automated and Scalable Web A/BTesting with Interactive LLM Agents
本文提出了 Agent A/B,一个利用大语言模型 (LLM) Agent 模拟真实网页 A/B 测试的端到端系统。通过在 Amazon 真实环境部署 1,000 个具有结构化人格 (Persona) 的 Agent,成功复现了人类实验的预测趋势,证明了其作为 UX 评估工具的有效性。
TL;DR
在传统的 UI/UX 设计流程中,A/B 测试是验证设计灵效的“金标准”,但其对流量的渴望和漫长的测试周期常令开发者望而却步。本文介绍的 Agent A/B 系统,利用具有多样化身(Persona)的 LLM Agent 在真实网页上进行大规模交互,旨在真实用户进入前就“预知”设计优劣。在亚马逊的案例中,它仅以极低成本便复现了 200 万人类用户的行为模式。
核心痛点:昂贵的“真实感”
即便是像亚马逊、微软这样的科技巨头,A/B 测试也并非免费的午餐。论文通过对 6 位资深工业界专家的访谈,揭示了当前实验的三大局限:
- 流量荒:并非所有新功能都能分到足够的真实用户流量。
- 反馈慢:从构思到拿到数据,动辄数月的周期让敏捷开发名存实亡。
- 高风险:一个糟糕的设计直接上线 A/B 测试,可能会严重损害用户体验。
Agent A/B:如何模拟一个“活着的”用户?
Agent A/B 的精髓在于它不仅仅是复现点击,而是模拟决策过程。
1. 结构化人格生成 (Persona Generation)
系统并非生成统一的机器人,而是根据人口统计学(年龄、性别、收入)生成具备特定购物意图的 Agent(如:“寻找 40 美元以下且评价优良的智能音箱”)。这种多样性确保了实验结果具有统计学意义。
2. 闭环交互架构
不同于处理静态 HTML,Agent A/B 能够直接操作实时、动态的网页。
- 环境解析 (Parsing):利用 JavaScript 将混乱的 DOM 树提炼为结构化的 JSON(如产品标题、价格、滤镜列表),降低 LLM 的幻觉风险。
- 双环决策 (Fast/Slow Loop):采用 UXAgent 架构,模仿人类的“条件反射(快速循环)”与“逻辑反思(慢速循环)”。
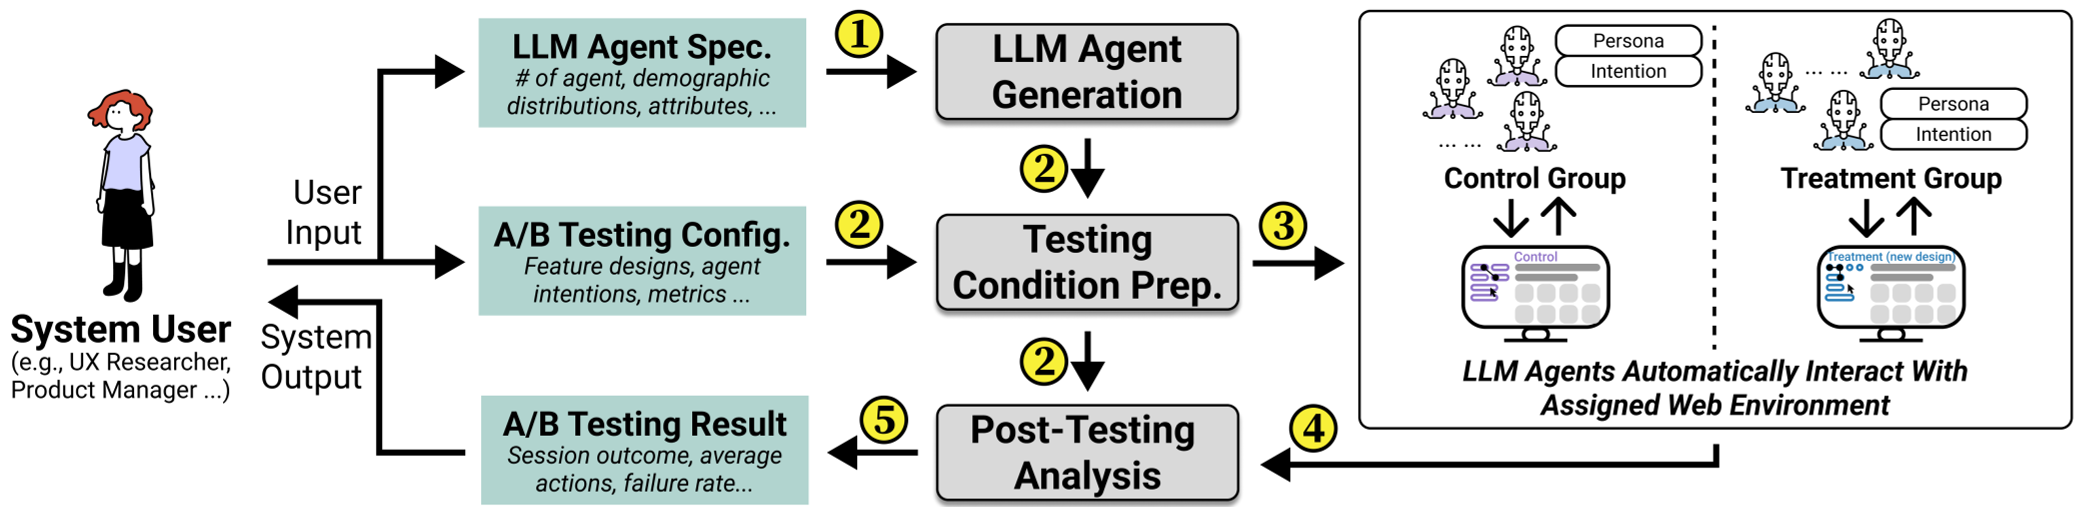 图 1:Agent A/B 的端到端流程:从 Persona 生成到自动化结果分析
实战演练:亚马逊滤镜优化实验
研究者在 Amazon.com 上针对“侧边栏滤镜面板”进行了实测。实验分为两组:
- 对照组:显示所有冗长的滤镜选项。
- 实验组:利用算法减掉关联度低的滤镜,只保留与搜索词最相关的选项。
关键发现 (Alignment)
虽然 Agent 的行为比人类更“目标导向”(点击更少、更有效率),但最终的购买率趋势却惊人地吻合:
- 方向一致性:Agent 系统检测到简化滤镜显著提高了购买转化率(Accuracy +),这与 200 万人类用户的真实反馈一致。
- 子组差异:Agent 成功模拟出年长用户更喜欢简单界面,而部分年轻用户反馈负面的细微差别。
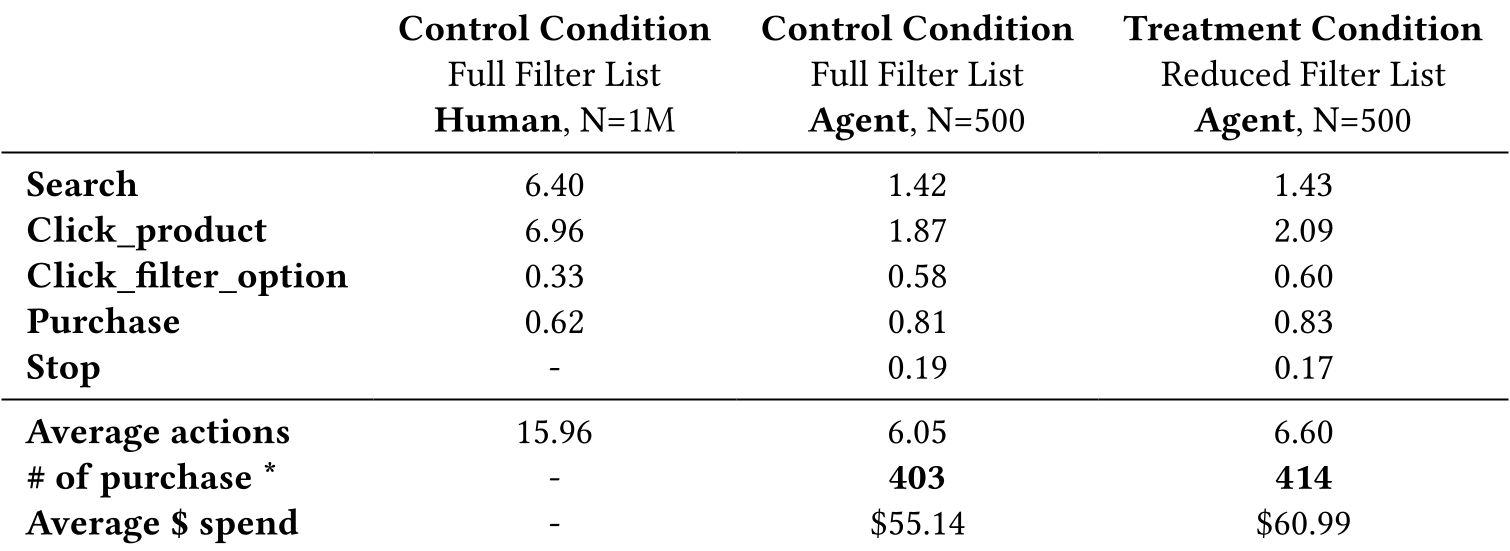 表 1:人类用户与 LLM Agent 在不同指标上的横向对比
深度洞察:AI 会取代人类测试吗?
作者非常清醒地指出:Agent A/B 是补充而非置换。
- 经济性:招聘 1000 名真实用户进行 UX 研究需约 10 万美元,而部署 1000 个 Agent 仅需约 2900 美元(不到 3% 的成本)。
- 安全性:对于涉及隐私或易感人群(如老年人)的交互,先用 Agent 进行测试可以大幅降低伦理风险和设计负面冲击。
局限与展望
目前 Agent A/B 仍面临挑战。例如,Agent 的行为往往过度理性,难以完全捕捉人类在无聊或分心时的“随意探索(Exploration)”模式。此外,Token 成本虽然相对人类较低,但对于超大规模的长时间模拟仍是一笔开支。
总结 (Takeaway)
Agent A/B 证明了:在大语言模型时代,UI/UX 评估正在从“观察法”转向“模拟法”。这种“上线前的模拟飞行”将极大地加速互联网产品的迭代频率,让更有价值的设计更早地与人类见面。