
AgentGuard:深度融合代码语义,终结软件包混淆攻击
AgentGuard: A Multi-Agent Framework for Robust Package Confusion Detection via Hybrid Search and Metadata-Content Fusion
本文提出了 AgentGuard,一个用于检测软件包混淆攻击(Package Confusion)的多智能体框架。其核心结合了混合搜索策略与元数据-内容融合分类模型,通过识别潜在攻击目标并进行深度内容验证,显著提升了供应链安全的防御能力。
1. 核心速览 (Executive Summary)
TL;DR:针对日益严峻的软件供应链威胁,AgentGuard 提出了一种全新的多智能体协作框架。它不仅能通过“混合搜索”识别潜在的攻击目标,还首次通过**代码内容(Package Content)和不可篡改的时间信号(Temporal Signals)**进行深度交叉验证。实验证明,该方法将混淆检测的精确度提升了最高 49%,并显著降低了业界头疼的误报问题。
背景定位:这是该领域首个将 LLM 驱动的智能体推理与深度学习分类器相结合的系统。它从传统的“名称比对”升华为“功能与身份一致性”的深度审计,是当前软件包混淆检测领域的 SOTA(State-of-the-art)成果。
2. 痛点深挖 (Problem & Motivation)
软件包混淆攻击(如 Typosquatting)之所以难以防范,主要有三大痛点:
- 搜索盲区:只看文字相似度会漏掉语义攻击(如
bz2file仿冒bzip);只看语义又会漏掉字符拼写错误。 - “看起来很像”的合法包:开源生态中存在大量功能相似、名字也相似的合法分支,仅靠元数据(Metadata)很难区分谁是“李鬼”。
- 元数据伪造:攻击者可以轻易克隆目标包的描述、仓库 URL 甚至版本号,让基于规则的防御系统形同虚设。
3. 方法论详解 (Methodology)
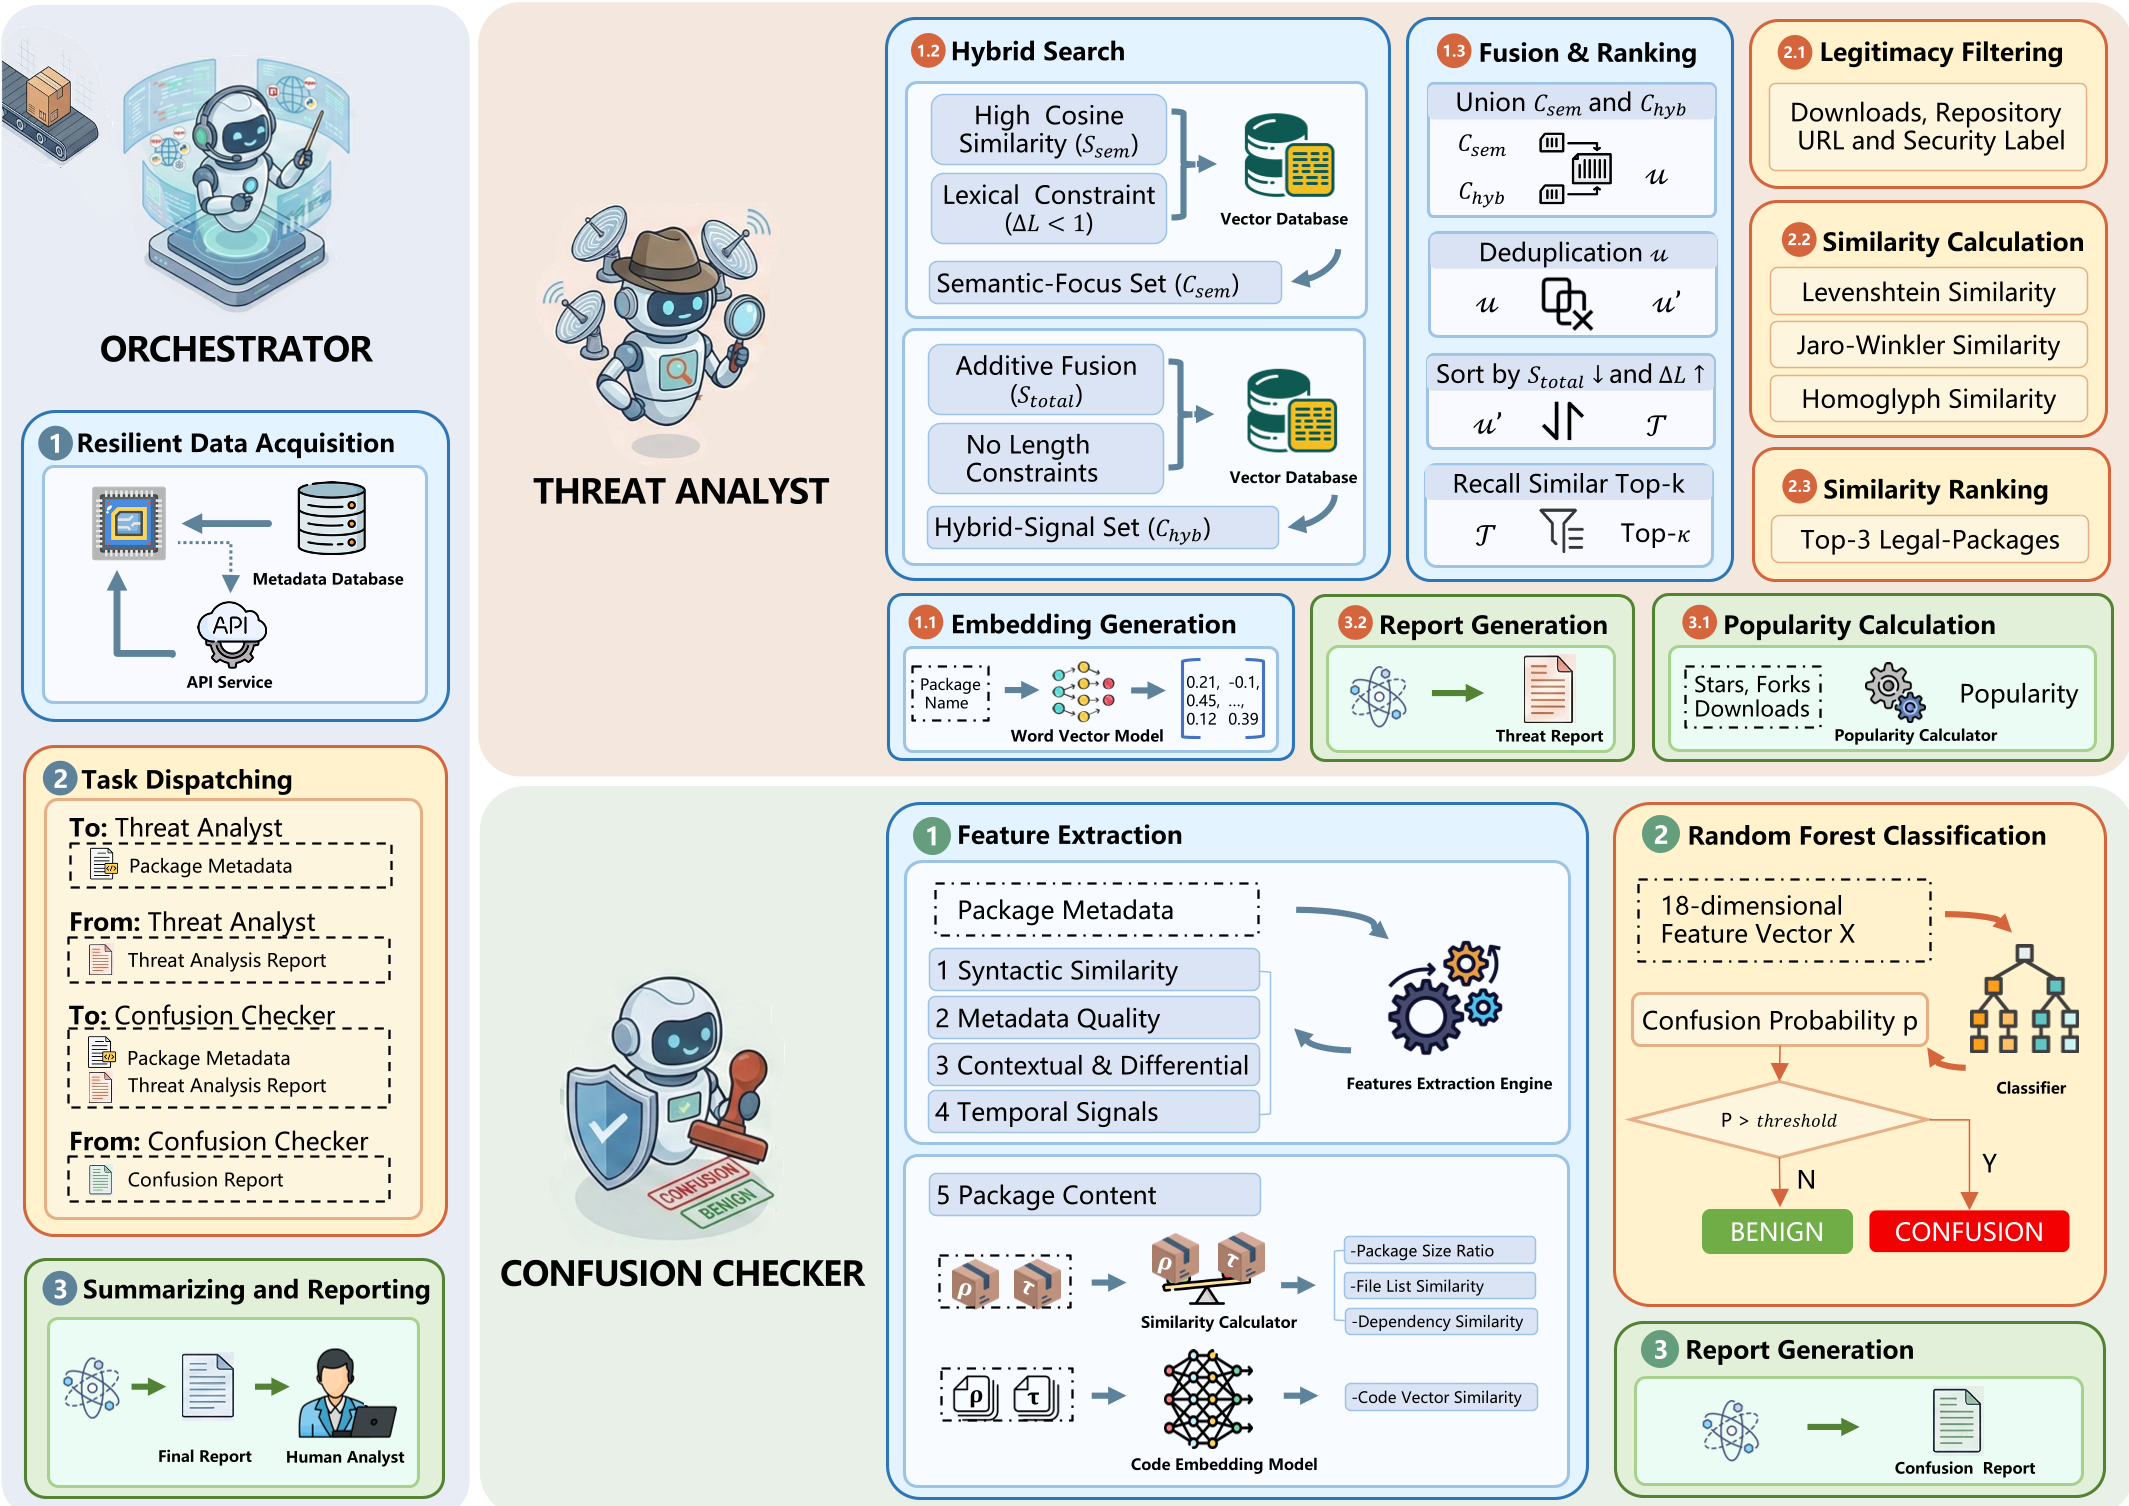
AgentGuard 通过三个专门的智能体协同工作,形成了一套完整的防御链路:
A. 威胁分析智能体:混合搜索 (Hybrid Search)
为了实现“一个都不漏”,AgentGuard 不再押宝单一算法,而是采用双通道召回:
- 语义通道:利用微调后的
FastText向量捕获功能意义上的相似性。 - 词法通道:利用
Trigram相似度精确捕获拼写变体。 这种混合策略确保了 TDR@1(首位发现率)达到了 66%-84%,远超单一手段。
B. 混淆自检智能体:内容-元数据融合
这是 AgentGuard 最核心的创新。它提取了五大类共 18 维特征,其中最关键的是:
- 不可篡改特征 (TS):软件包的创建历史、发布频率等,这些特征具有“单调性”,攻击者无法在短时间内刷出几年的历史。
- 内容特征 (PC):利用
CodeBERT将代码转化为语义向量,并比较文件列表、依赖图的相似度。直觉告诉我们:一个伪装成复杂工具库的恶意包,其代码布局和逻辑必然与原版存在巨大偏差。
4. 实验与结果 (Experiments & Results)
性能碾压
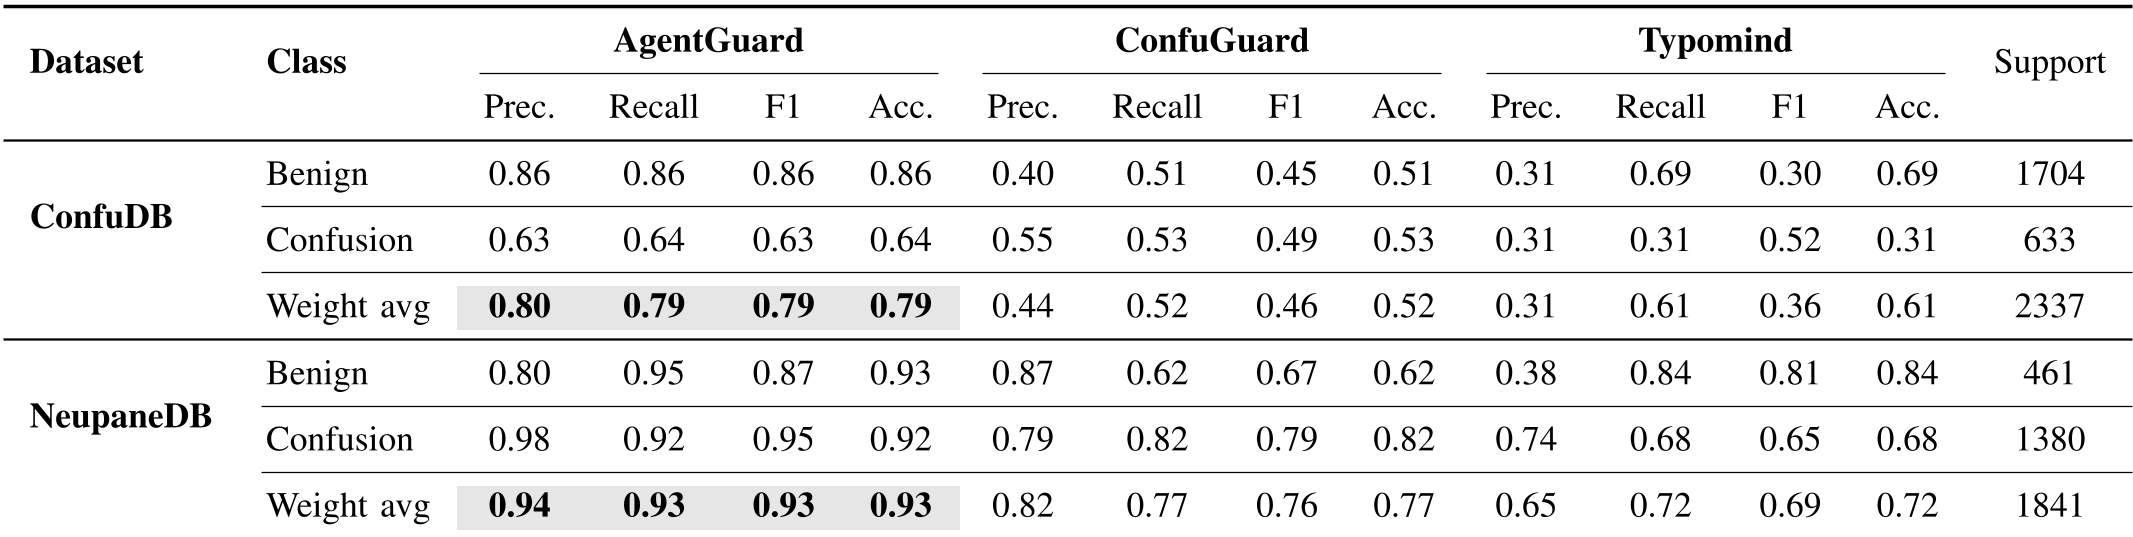
在实战数据集 ConfuDB 上,AgentGuard 的 F1 分数达到了 0.79,相比之前的 SOTA 模型 ConfuGuard(0.46)和 Typomind(0.36)实现了质的飞跃。
对抗鲁棒性 (Adversarial Robustness)
论文进行了一场有意思的测试:如果攻击者伪造了所有能伪造的元数据,现有的检测系统会怎样?
结果显示,传统的 SS+MQ(基于相似度和元数据)模型召回率直接从 0.91 暴跌至 0.11;而 AgentGuard 凭借代码内容特征的支撑,依然保持了高度的稳定性。
5. 深度洞察:为什么有效?
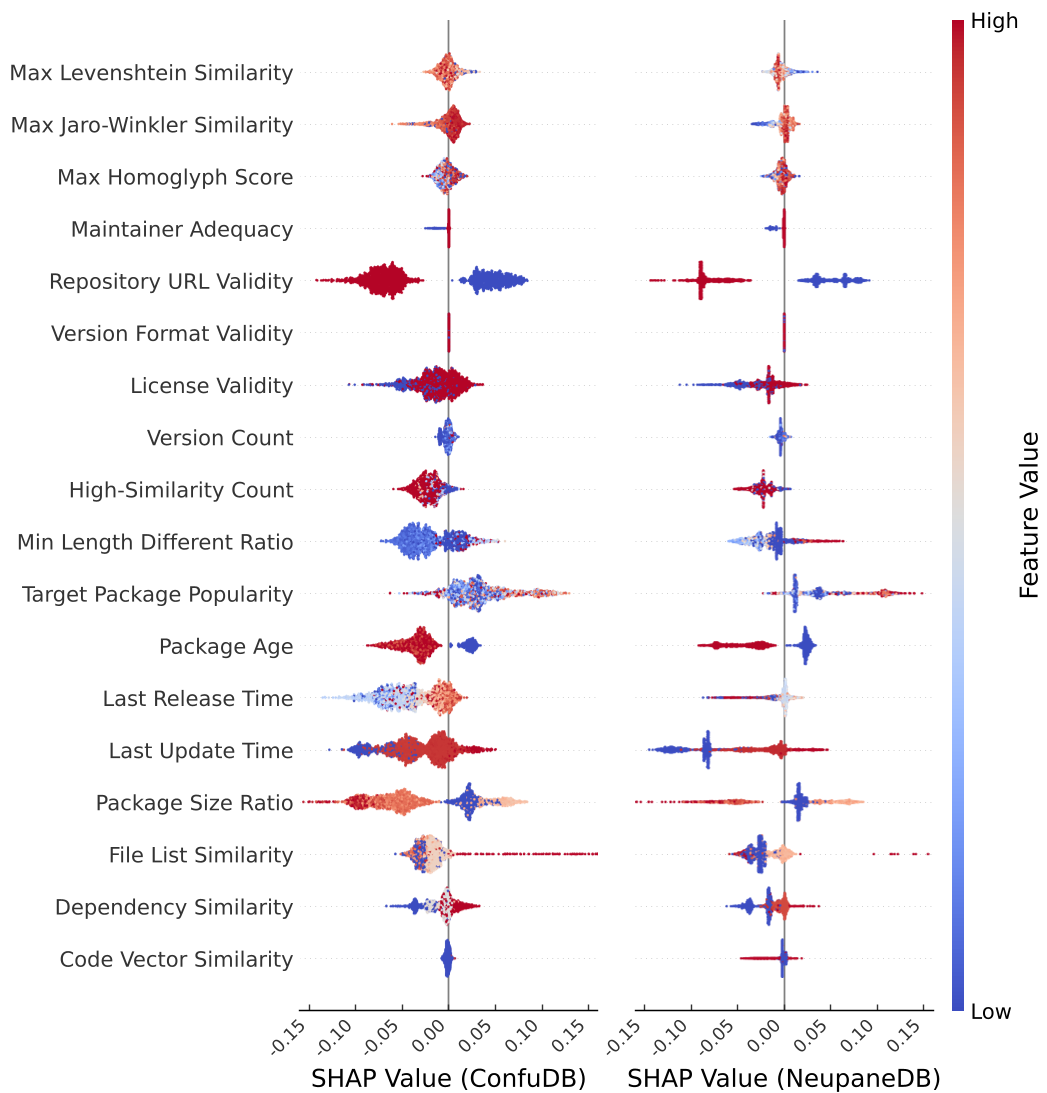
通过 SHAP 分析,我们可以窥见模型背后的“物理直觉”:
- 风险指标:如果一个新包的依赖项与某个流行包高度重合,但代码大小比例(Package Size Ratio)却极度不匹配,模型会立即将其标记为“高度可疑”。
- 信任层级:尽管元数据可以伪造,但“时间”是无法作弊的。软件包的“年龄”和“更新频率”在决策逻辑中占据了极高的权重。
6. 总结与展望 (Conclusion)
AgentGuard 的成功预示着软件供应链安全正在进入“主动扫描+深度溯源”的新阶段。它跳出了单纯的文字游戏,转而从行为语义和历史信用两个维度去量化风险。
局限性:目前该框架对“代码投毒”(即在合法代码库中插入极小量混淆载荷)的检测仍有待加强。未来,集成更细粒度的静态分析或作者声誉系统(Author Reputation)将是进一步完善该框架的关键方向。