
Agentic ESOpt:以推理级显存突破长程 LLM Agent 微调瓶颈
Agentic ESOpt: Fine-Tuning Long-Horizon LLM Agents with Minimal GPU Requirements
本文提出了 Agentic ESOpt,一种面向长程(Long-Horizon)大语言模型智能体的全参数进化策略(Evolution Strategies, ES)微调框架。该方法通过无反向传播的前向扰动机制,在仅需推理级 GPU 显存的前提下实现全参数优化,并在长程数独、ReAct 工具调用、WebArena-Lite 网页导航及测试期启发式算法设计等任务中显著超越强化学习(RL)基线。
核心速览 (Executive Summary)
- TL;DR:针对多轮长程(Long-Horizon)LLM Agent 在强化学习(RL)微调中面临的“显存墙”与“长程信用分配失效”难题,新加坡国立大学与牛津大学等机构提出了 Agentic ESOpt。该框架基于进化策略(Evolution Strategies, ES),仅需推理级 GPU 显存即可实现全参数微调,并在数学推导与实验上证明了 ES 相比 RL 在长交互步数下具备更优的方差可扩展性,同时支持参数与提示词/技能空间的协同演化(Co-Evolution)。
- 背景定位:本工作重构了社区对 ES 与 RL 的固有认知——在单轮生成任务中 ES 常被视作低显存但性能稍逊的“平替”,而本文证明在长程交互与稀疏奖励的智能体场景下,ES 是在优化几何与信用分配机制上全面超越传统 Agentic RL 的更优解。
痛点与动机 (Problem & Motivation)
大语言模型智能体(如 Web 导航、多步代码执行、复杂工具链规划)正在从单轮 CoT 推理演进为长程多轮交互系统。然而,主导单轮后训练的强化学习(PPO / GRPO)在长程场景下遭遇了严峻的结构性阻碍:
- 显存墙(Model Scalability Bottleneck):多轮交互产生了极长的上下文与分支。反向传播需保留大量中间激活值、优化器状态及参考模型,使得全参数微调 27B 以上的大模型在常规硬件集群(如 4×H100)上几乎无法进行。
- 长程信用分配失效(Long-Horizon Credit Assignment Failure):在稀疏奖励场景下,策略梯度估计器需要将轨迹末端的单一标量奖励分摊至 个交互轮次的每个动作上。假设各轮次动作得分弱相关,策略梯度(Policy Gradient)估计器的方差随交互轮数 近似呈线性增长:
abla_ heta \log \pi_ heta(a_t \mid s_t)\right] \propto H$$ 这导致随着任务轮数增加,RL 的优化梯度方差剧增,学习极易陷入停滞或策略崩塌。
核心研究洞察(Insight):进化策略(ES)直接在全参数空间采样扰动 ,并通过轨迹级整体回报进行加权更新: 由于参数得分项 完全不随交互轮数 进行累加,ES 天然规避了动作层面的步数方差爆炸,对长程智能体任务展现出更强的内在扩展性。
方法论详解 (Methodology)
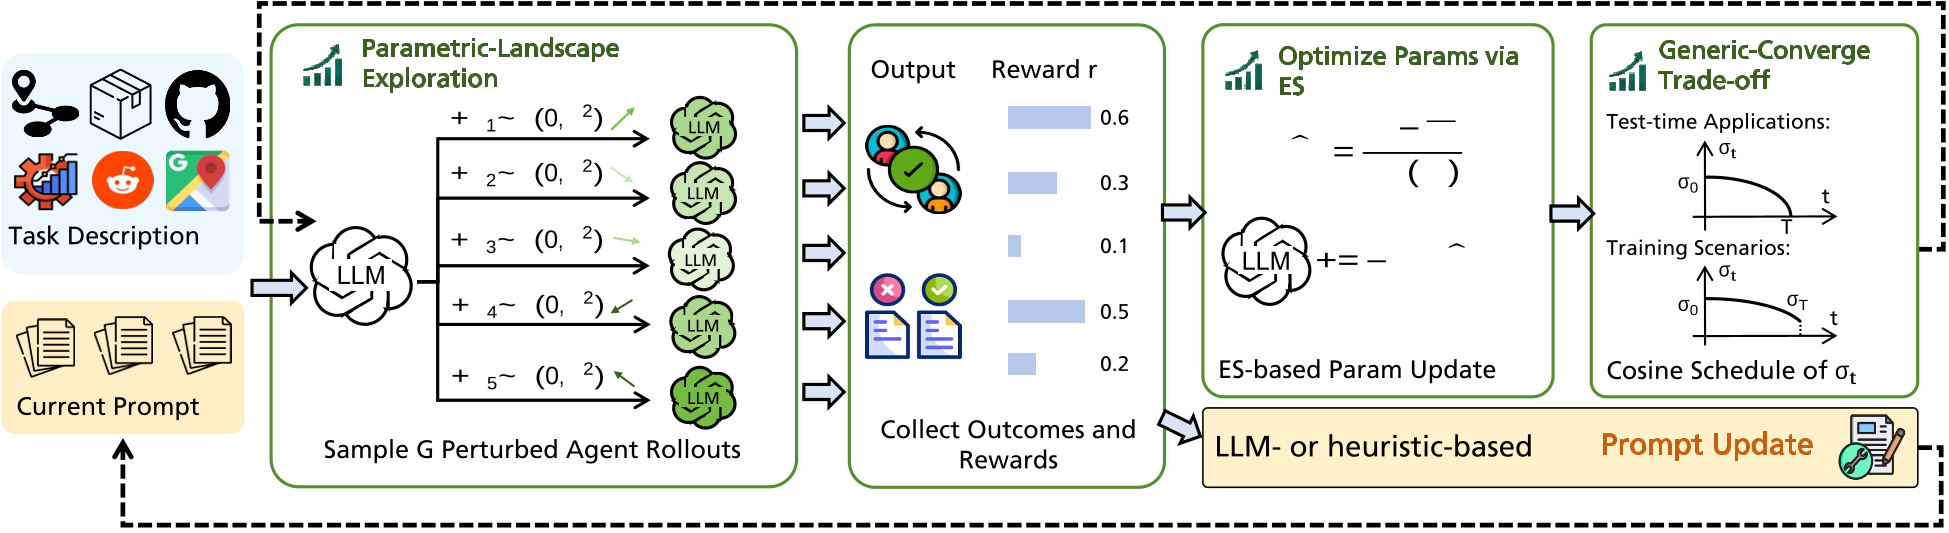 图 1:Agentic ESOpt 架构概览及其与外部提示/技能协同演化(Co-Evolution)流程
1. 极低显存的前向全参数优化
Agentic ESOpt 仅需前向传播(Forward-Only)。算法在当前参数 附近采样 个高斯扰动向量 ,通过**固定随机种子(Seed)结合原地加减(In-place addition/subtraction)**的方式动态构建扰动模型,完全不占用额外的梯度与激活显存。
评估获得轨迹回报 后,进行群体内 Z-score 标准化以降低方差,并按如下公式执行在线更新:
2. 扰动半径 的余弦衰减机制 (Cosine Decay Schedule)
根据高斯平滑目标函数的泰勒展开(Lemma 1):
abla_ heta^2 J( heta ; c)\right) + \mathcal{O}(\sigma^4)$$ 非零的 $\sigma$ 等价于引入了迹正则化(Penalizing sharp local optima, favoring flat regions)。为了平衡训练初期的全局探索与后期的精准收敛,Agentic ESOpt 设计了余弦衰减策略: $$\sigma_t = \sigma_T + (\sigma_0 - \sigma_T) \frac{1 + \cos(\pi t / T)}{2}$$ * **训练期微调(Train-time Fine-tuning)**:保留非零的终末半径 $\sigma_T > 0$,以维持对泛化有益的平滑正则化。 * **测试期计算(Test-time Compute)**:衰减至 $\sigma_T = 0$,消除目标函数偏差,专注于当前具体任务的最优解搜索。 ### 3. 参数-提示词/技能空间协同演化 (Parameter-Context Co-Evolution) 由于 ES 采用纯黑盒标量反馈接口,收集到的交互轨迹可无缝复用于外部技能沉淀(如 Trace2Skill)与算法生成(如 EoH),形成参数空间 $\mathcal{U}_{\mathrm{ES}}$ 与上下文空间 $\mathcal{U}_c$ 的交替演化闭环。 --- ## 实验与结果 (Experiments & Results) ### 1. 受控长程数独(Sudoku):长程扩展性的理论印证 在动作步数严格受控的数独环境中(最小成功步数 $H^* \in \{5, 10, 15\}$),对比实验清晰呈现了 RL 与 ES 的交叉趋势: 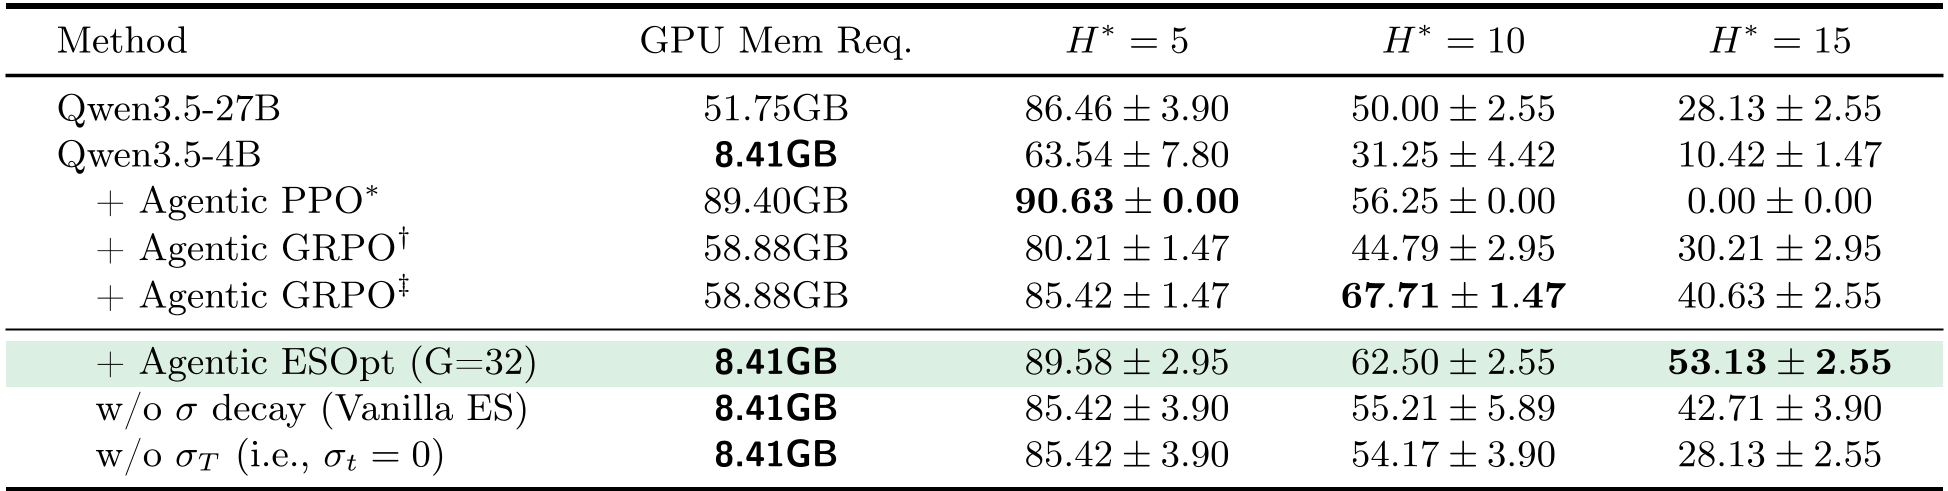 *表 1:不同最小成功步数 $H^*$ 下数独成功率与 GPU 显存需求对比* * **短步数 vs. 长步数**:在 $H^*=5$ 时,Agentic GRPO 与 Agentic ESOpt 性能相当;但当步数提升至 $H^*=15$ 时,PPO 彻底崩溃(0.0%),GRPO 停滞在 40.63%,而 **Agentic ESOpt 达到 53.13%(领先 12.50%)**。 * **显存与计算开销**:在 Qwen3.5-4B 上,Agentic ESOpt 显存仅需 **8.41GB**(仅为 GRPO 58.88GB 的 14.3%,PPO 89.40GB 的 9.4%)。尽管 ES 采样群体 $G=32$ 大于 GRPO 的 8 条轨迹,但省去了参考模型前向与反向传播,两者的实际训练 FLOPs 与 Wall-clock 耗时基本持平。 ### 2. ReAct 工具调用与 27B 网页智能体(WebArena-Lite) 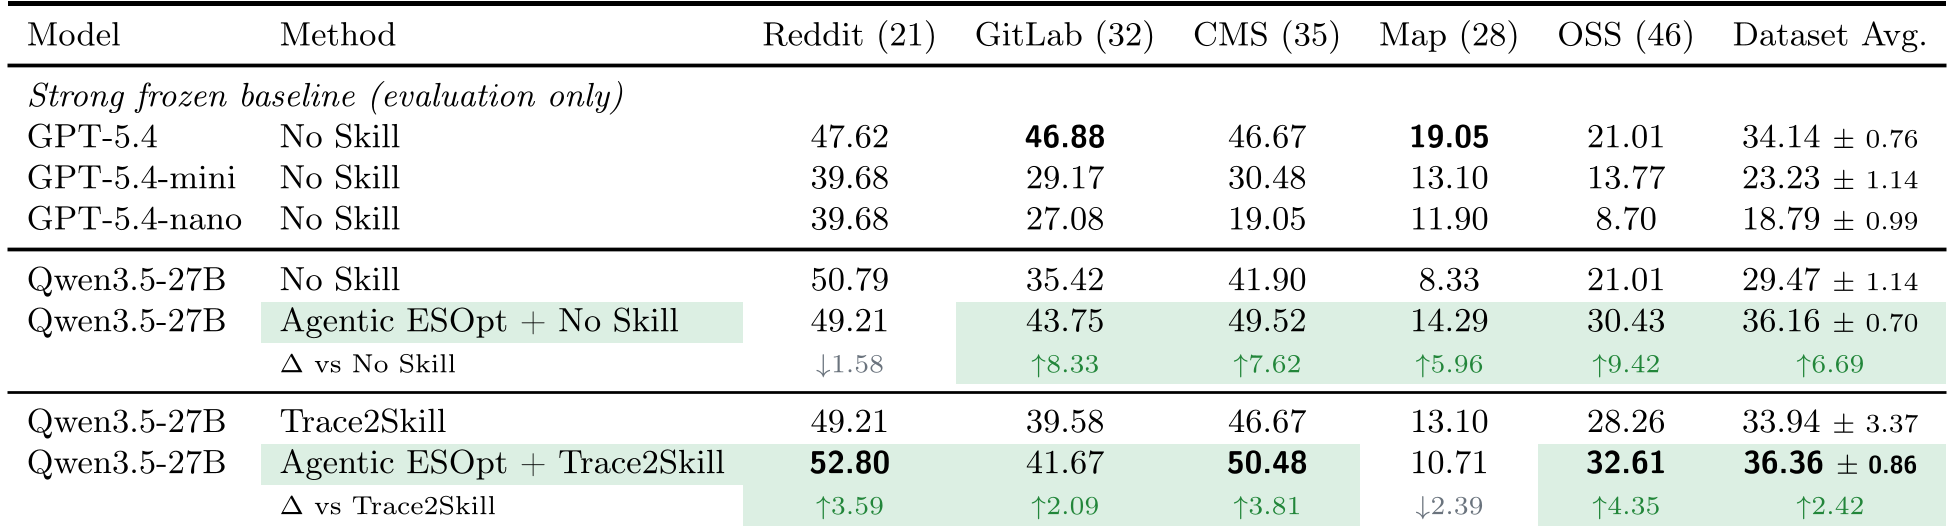 *表 2:WebArena-Lite 真实网页环境下的任务成功率 (%)* * **ReAct 数学与文档问答**:在 DAPO、AIME 2026 和 DocVQA 上,Agentic ESOpt 在 Qwen3.5-4B 上的 Mean@4 指标较 Base 提升 13.7%,比 Agentic GRPO 提升 8.3%,且在 Pass@32 上保持了更广的解空间覆盖率。 * **超大模型全参数微调(27B Scale)**:在 4×H100 集群上,RL 无法运行 Qwen3.5-27B 全参数微调,而 Agentic ESOpt 成功将 WebArena-Lite 成功率由 29.47% 提升至 **36.16% (+6.69%)**;与 Trace2Skill 结合进一步提升至 **36.36%**,超越了 GPT-5.4 闭源模型的评测基准。 ### 3. 测试期计算(Automatic Heuristic Design, AHD) 在无需改动外部启发式搜索框架的前提下,将 Agentic ESOpt 嵌入 EoH(Evolution of Heuristics)及随机采样流程中,在 TSP、KP、CVRP、BPP 等 12 个 NP-hard 组合优化测试集上,**在 36 个评测配置中取得了 28 项提升**,实现了代码演化与模型参数的即时在线协同强化。 --- ## 深度洞察与总结 (Critical Analysis & Conclusion) ### 核心价值 (Takeaway) Agentic ESOpt 打破了“进化策略仅是小模型玩具或单轮低效替代品”的技术偏见。它从**方差几何**的角度揭示了:当交互链条拉长、奖励极度稀疏时,以完整策略扰动为归因单位的 ES,相比累加多步动作分数的 Policy Gradient,在长程智能体建模中具有不可替代的数学与工程优势。 ``` ┌─────────────────────────┐ │ 长程智能体优化核心范式 │ └────────────┬────────────┘ │ ┌───────────────────────┴───────────────────────┐ ▼ ▼ 【Agentic RL (PPO/GRPO)】 【Agentic ESOpt (Ours)】 · 显存壁垒: 需缓存激活与计算图 · 显存极致: 仅需推理显存 (Forward-Only) · 信用分配: 沿 H 步累加,方差 ∝ H · 信用分配: 轨迹级参数扰动,方差解耦于 H · 适用场景: 单轮推理 / 密集步级反馈 · 适用场景: 长程多轮交互 / 稀疏终端奖励 ``` ### 局限性 (Limitations) 1. **环境交互开销**:ES 依赖更多的前向采样轨迹来换取无反向传播计算。如果模拟器或真实环境交互代价极其昂贵(例如高延迟的真实物理机器人仿真),Rollout 开销将成为主要瓶颈。 2. **超参数敏感度**:扰动半径 $\sigma_0$、学习率 $\alpha$ 以及群体大小 $G$ 的选取受模型基础能力影响较大。 ### 未来展望 (Future Work) 论文初步揭示了 **Population Scaling Law** 的存在:模型参数规模与基础能力越强(如 9B vs 4B),有效更新方向在参数空间中的局部密度越高,所需的扰动群体规模 $G$ 反而越小。未来,将 Agentic ESOpt 拓展至更大规模的千亿前沿模型、结合量化低比特扰动优化(Quantized ES),将是通向自主自我演进智能体(Self-Evolving Agents)极具潜力的技术路径。