
Agentic RAG 真的值吗?一项关于增强型与智能体 RAG 的深度对比研究
Is Agentic RAG worth it? An experimental comparison of RAG approaches
本文对“增强型 RAG”(Enhanced RAG)与“智能体 RAG”(Agentic RAG)进行了多维度的实证对比研究。通过在四个标准数据集(FIQA, NQ, FEVER, CQADupStack)上的实验,评估了两者在意图处理、查询改写、文档精炼及成本效益方面的表现。
核心速览
TL;DR:随着大模型的自反思能力增强,RAG 领域正在从“固定流水线”转向“智能体路由”。本文通过严谨的实验告诉我们:Agentic RAG 在灵活性和查询理解上大获全胜,但在成本控制和文档排序效率上却输给了传统的 Enhanced RAG。 简单来说,Agentic 更聪明,但更慢也更贵(成本高出 3.6 倍)。
背景定位:这是一篇极具工程指导意义的基准测试论文。它没有提出玄幻的新算法,而是站在生产者的视角,首次量化了 Enhanced 和 Agentic 两种范式的真实转化率与性价比。
痛点深挖
传统的 Naïve RAG 存在检索噪声、无法处理无关查询、Query 与文档不匹配等硬伤。
- Enhanced RAG 试图通过增加“固定组件”(如语义路由、Hyde 改写器、Reranker)来修补这些环节。
- Agentic RAG 则直接把指挥权交给 LLM,让它动态决定:是否需要检索?查询需不需要重写?检索结果不够好要不要再来一次?
开发者面临的终极问题是:这种“自由度”换来的性能提升,能否对得起那翻了几倍的 Token 账单?
方法论详解:架构的博弈
作者将两种范式拆解为同等功能的对比组:
- 意图路由:Enhanced 使用基于向量相似度的
semantic-router;Agentic 依靠模型 System Prompt 自主判断。 - 查询改写:Enhanced 固定执行 Hyde 策略;Agentic 动态决定改写方式(或不改写)。
- 文档精炼:Enhanced 使用专门的 ELECTRA 重排序模型;Agentic 通过多轮循环检索(Iterative Retrieval)来优化上下文。
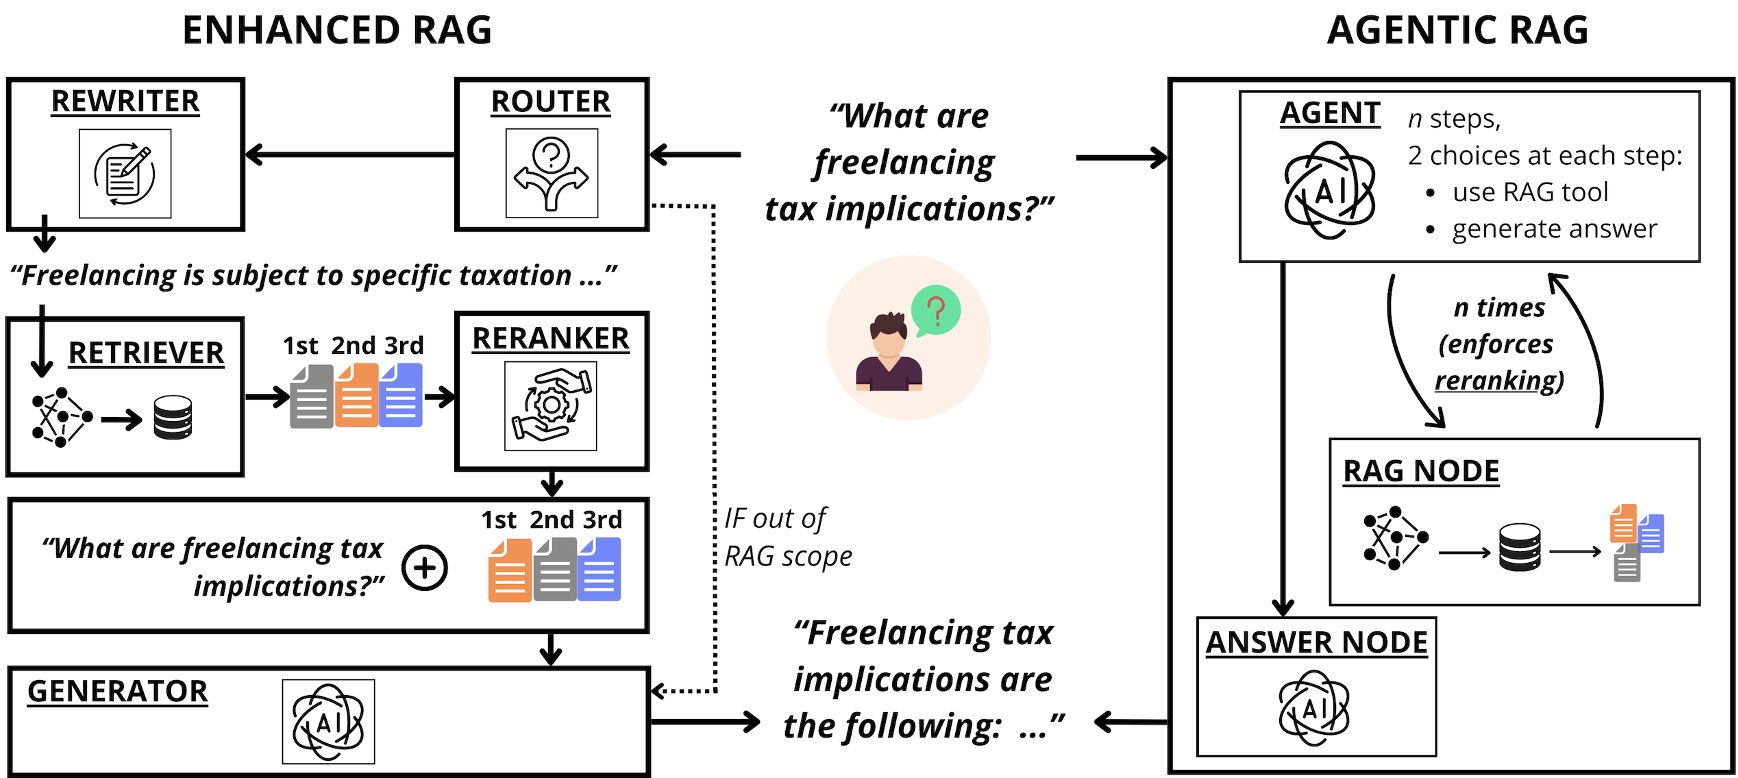 左图为 Enhanced RAG 的固定流水线,右图为 Agentic RAG 的自主编排循环。
实验与结果:残酷的现实
1. 检索质量:Agentic 略胜一筹
在查询改写维度,Agentic 表现出极强的适应性。在 FEVER 和 NQ 数据集上,Agentic 的 NDCG@10 显著高于固定 Hyde 策略。这证明了 由模型根据当前意图动态生成的改写方案,比死板的插件更有效。
2. 文档精炼:传统 Reranker 依然是“神”
令人意外的是,Agentic 的“多轮检索”并没有带来预想中的大幅提升。实验显示,Agent 在重新检索时,53% 的文档与第一轮重复。相比之下,Enhanced RAG 中加入一个轻量级的跨编码器(Cross-Encoder)进行 Rerank,能以极低的成本获得明显的增益。
3. 成本分析:沉重的代价
成本是 Agentic RAG 的阿喀琉斯之踵。
- Token 消耗:Agentic 消耗的输入 Token 是 Enhanced 的 3.3 倍。
- 延迟:由于存在多轮推理和思考(Thinking mode),其端到端延迟平均高出 50%。
 不同模型规模下两种范式的 Token 与时间消耗对比表。
深度洞察与总结
核心贡献(Takeaways):
- 不要盲目 Agent 化:对于领域高度明确、长尾流量不明显的业务,Enhanced RAG 的性价比无敌。
- 混合搭配(Hybrid)是未来:最佳实践应该是——利用 Agent 的思维去路由和改写,但最后还是要接一个传统的 Reranker。
- 模型规模的影响:无论是哪种范式,随着底层模型从 0.6B 扩展到 32B,性能提升曲线几乎是平行的,Agent 架构并不能弥补模型本身能力的断层。
局限性:
本研究主要关注单工具 RAG Agent。对于涉及外部 API 调用、多步骤规划(Planning)的多工具 Agent,其性能边界还有待进一步探索。
结论:Agentic RAG 确实“值”,但值在它的自适应能力,而不是全盘的流程控制。聪明的开发者应该通过“精密设计的流水线 + 关键节点的智能决策”来平衡性能与支票簿。