
代理式世界模型:从“像素预测”到“自主进化”的范式转移
Agentic World Modeling: Foundations, Capabilities, Laws, and Beyond
本文提出了 Agentic World Modeling (智能体世界建模) 的路线图,涵盖从物理到科学等四大领域,并定义了 L1-L2-L3 三级能力体系。该工作通过对 400 余篇文献的综述,确立了衡量“世界模型”真实效能的 testable(可测试)边界。
1. 核心速览 (Executive Summary)
TL;DR:如果你对“世界模型”的理解还停留在 Sora 生成的精美视频,那么这篇论文将刷新你的认知。本文将碎片化的研究整合为一套**L1(预测器)→ L2(模拟器)→ L3(进化器)**的能力阶梯,并指出真正的世界模型不应只是“长得像世界”,而必须“运行逻辑像世界”。
背景定位:这是首篇系统性拆解 AI Agent 预测基质的重磅综述。它打破了计算机视觉(CV)、强化学习(RL)和 AI for Science 的学科壁垒,在当前大算力堆砌性能的背景下,为实现“物理世界 AGI”指明了从单纯预测到闭环进化的演进路径。
2. 痛点深挖:为什么你的世界模型只是个“影子”?
目前的生成式 AI 面临一个尴尬的现状:它能生成几秒钟极度真实的物体坠落视频,但在关键的决策时刻,由于模型不理解物理约束(如能量守恒),它生成的未来可能会让物体穿透桌面或凭空消失。
作者犀利地指出,现有工作过度依赖视觉真实感(Perceptual Realism),而忽略了决策可用性(Decision-Usability)。一个对 Agent 有用的模型,必须在“如果我稍微改变动作(干预敏感性)”时给出稳定且合理的反馈,而非仅仅是统计意义上的像素延续。
3. 能力分级:L1 到 L3 的跃迁 (Methodology)
作者提出的三个级别是理解本文的核心直觉:
- L1 Predictor(预测器):单纯提取数据中的相关性。就像 Hume 所说的“恒常连结”,看到 A 接着 B,于是预测下一个也是 B。大部分自回归模型都处于这个阶段。
- L2 Simulator(模拟器):引入了“可能世界”语义。它能在多个时间步内保持一致,且满足特定的Regime 约束(如物理重力、代码语法、社交博弈)。
- L3 Evolver(进化器):这是本文最前瞻的贡献。当模型预测失败时(Anomaly),L3 系统能像科学家一样设计实验、收集证据,并修正自己的参数或结构。
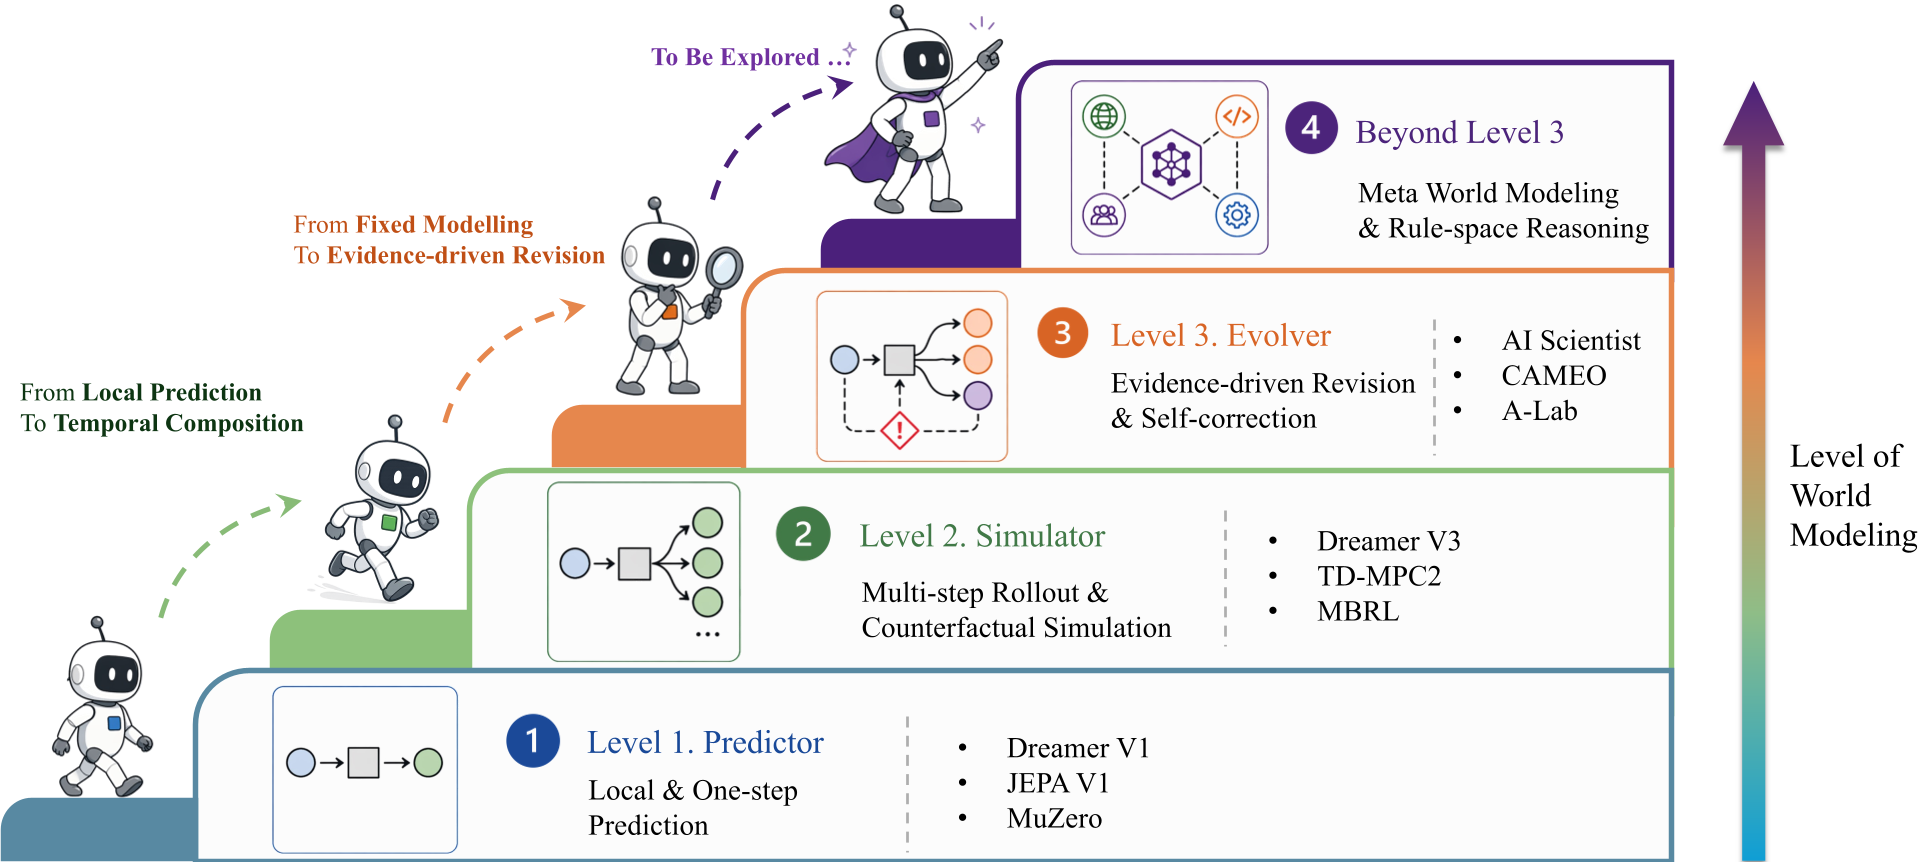 图 1:从局部预测到证据驱动修正:世界模型的层次化架构图
4. 四大战场:不同领域的“铁律” (Foundations)
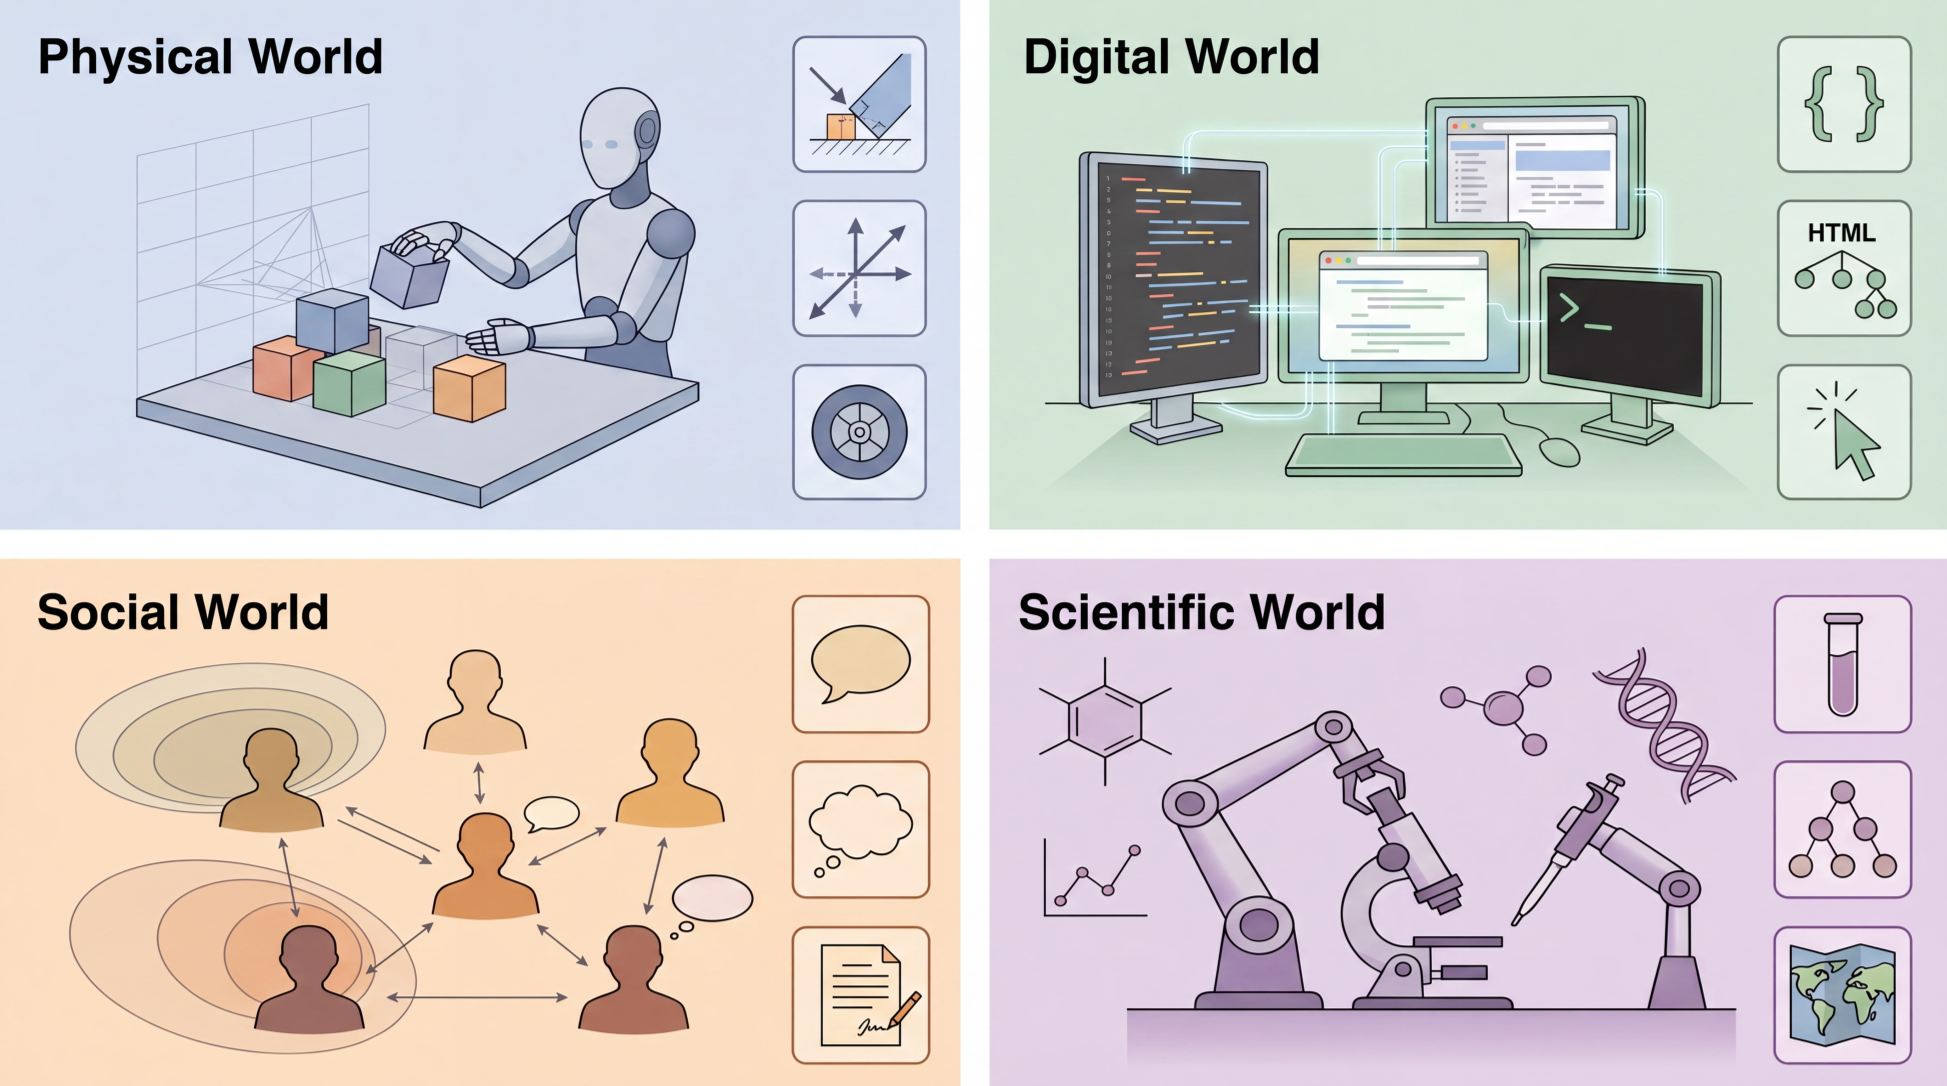
不同于以往按照模态(图像/文本)分类,本文按照支配规律 (Governing-law) 划分:
- 物理世界:受几何学、运动学约束(如机械臂抓取)。
- 数字世界:受 API 契约、程序语义约束(如 Web 代理)。
- 社交世界:受信念、规范、意图(ToM)约束。
- 科学世界:受潜在因果机制约束(如蛋白质折叠、天气预测)。
5. 实验与结果:现状令人担忧
调研显示,虽然我们在 L1 预测上突飞猛进,但 L2 的模拟连贯性极其脆弱。在物理一致性测试中,即便是顶尖的扩散模型也会在长程预测中产生“语义飘移”。
而在 L3 领域,除了 AI for Science(如 CAMEO、A-Lab 等具备闭环实验能力的实验室机器人)初具雏形外,物理智能和社交智能的 L3 进化能力几乎为零。
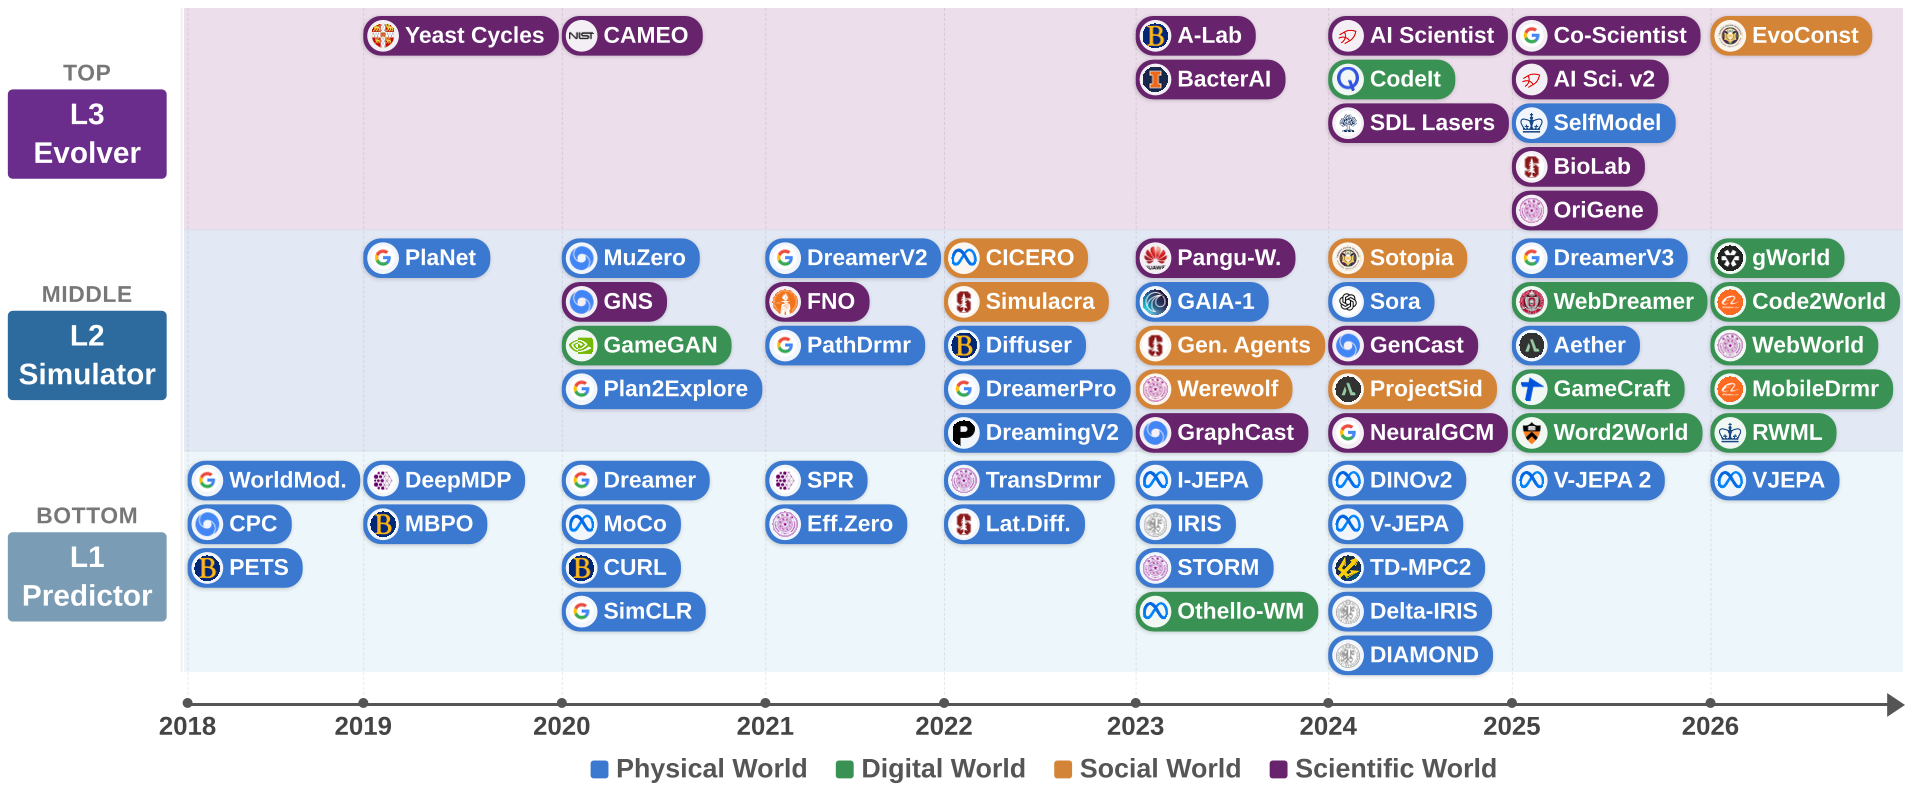 图 2:2018-2026 年代表性世界模型系统的时间轴与能力分布
6. 深度洞察与总结 (Critical Analysis)
核心启示:
- 符号化回归:作者认为,L1 和 L2 可能由神经网络主导,但 L3 的模型修正(即规则的发现与改写)可能需要引入符号化表示 (Symbolic Representation)。神经网络擅长“保护带”(调整权重),但符号表达更擅长改变“硬核”(调整公理)。
- MREP 倡议:为了解决“刷榜”乱象,论文提出了最小可复现评估包 (MREP),要求不仅看成功率,更要看对干预的响应。
局限性: 目前的 L3 闭环在复杂场景下极难闭合,特别是证据归因(Credit Assignment)非常困难——当你抓取失败时,是感知错了、动力学预测错了,还是电机老化了?
总结 (Takeaway): 这篇文章将“世界模型”从营销词汇拉回了严谨的学术坐标系。对于开发者而言,下一步不应是追求更精美的 Demo,而是赋予 Agent 质疑其所学“规律”并主动通过实验更新知识的能力。