
ERA:AI 科学家在算法演化中战胜人类专家
An AI system to help scientists write expert-level empirical software
本文推出了 Empirical Research Assistance (ERA),这是一个基于大语言模型(LLM)与树搜索(TS)的自主 AI 科学研究系统。该系统通过在代码空间中进行启发式突变和整合外部研究灵感,在单细胞测序数据分析、COVID-19 预测等多项任务中超越了人类专家级水平。
TL;DR
Google DeepMind 联合多所顶尖研究机构发布了 Empirical Research Assistance (ERA),这是一个能够自主编写专业级科研代码的 AI 系统。ERA 通过大语言模型(LLM)与树搜索(Tree Search)的深度融合,不仅学会了如何针对科学指标“刷分”,还展现出了从科研文献中汲取灵感乃至在单细胞分析和流行病预测领域发现“人类未知算法”的能力。
背景:被困在代码里的科学家
现代科学发现往往受限制于软件开发的效率。无论是气候建模、分子动力学还是基因组学,科学家们需要不断编写和优化复杂的经验软件来拟合数据。然而,传统方法往往是“凭直觉手动调整”,这在海量的算法可能性空间中无异于大海捞针。现有的 AutoML 虽然能调参,却无法像人类一样阅读论文并将其中的数学直觉转化为代码。
核心架构:LLM 的“逻辑进化”
ERA 的核心是一个基于 PUCT (Predictor + Upper Confidence bound applied to Trees) 架构的搜索系统。
1. 代码突变与树搜索
与传统的“单次生成(One-shot)”不同,ERA 会在代码空间构建一棵搜索树。每一代生成的代码都会在沙盒中运行并获得一个“质量评分”。
- Exploitation (利用):倾向于在当前评分最高的算法基础上进行微调。
- Exploration (探索):当现有路径进入瓶颈时,系统会回溯并尝试全新的分支。
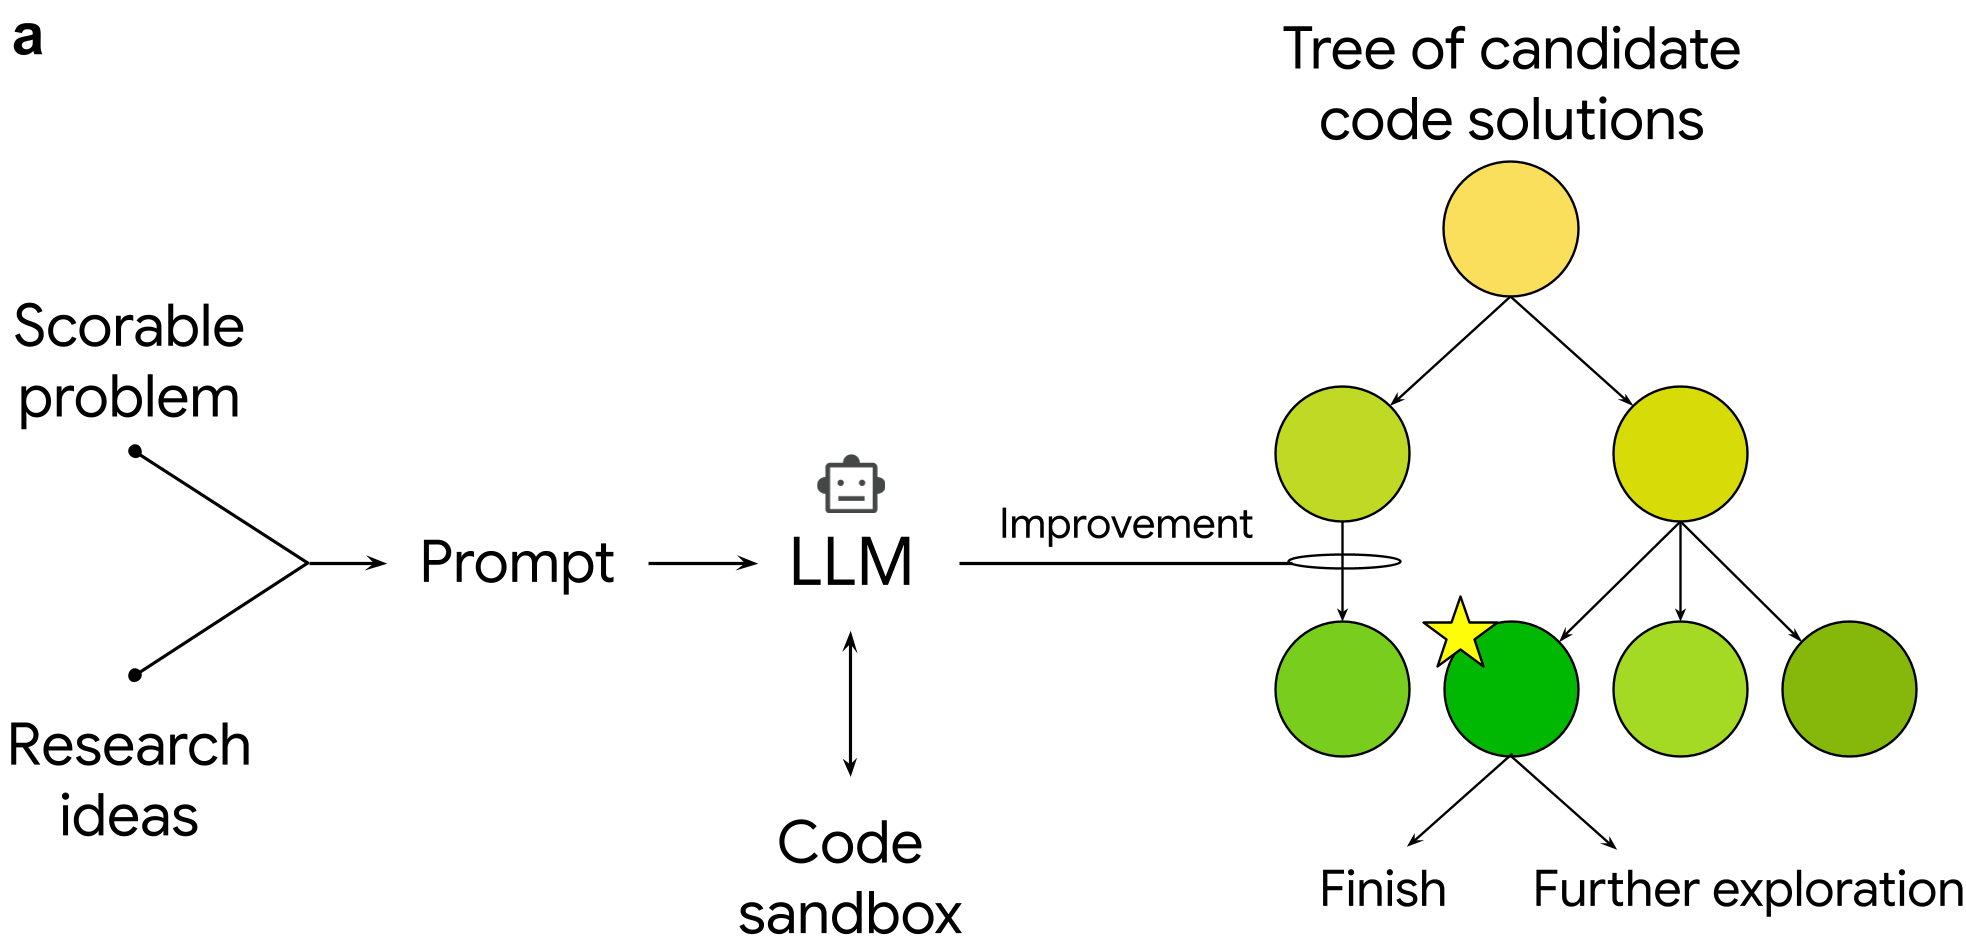
2. 研究思路注入 (Inside the Prompt)
这是 ERA 真正超越普通写代码 AI 的地方。研究人员将已发表论文的 PDF 摘要输入给 LLM。ERA 会像真正的科研人员一样理解例如“Batch Balanced K-Nearest Neighbors”的核心逻辑,并迭代出比原作者更优的实现方式。
实验结果:让 CDC 的专家汗颜
ERA 在多个“专家级”领域表现出了惊人的战斗力:
- 单细胞测序 (Genomics):在 OpenProblems 榜单上,ERA 自动发现的 BBKNN (TS) 方法不仅复现了经典算法,还通过将 ComBat 校正与 PCA 融合,实现了比原算法高出 14% 的性能。
- 流行病学预测:ERA 生成的 14 个模型在预测 COVID-19 住院人数时,WIS 分数(加权间隔得分)显著优于包含 CDC 官方团队在内的所有人类专家模型。
- 时间序列预测:在 GIFT-Eval 基准测试中,ERA 从零开始构建了一个通用预测库,在大规模多样化数据集上的表现优于主流深度学习基线。
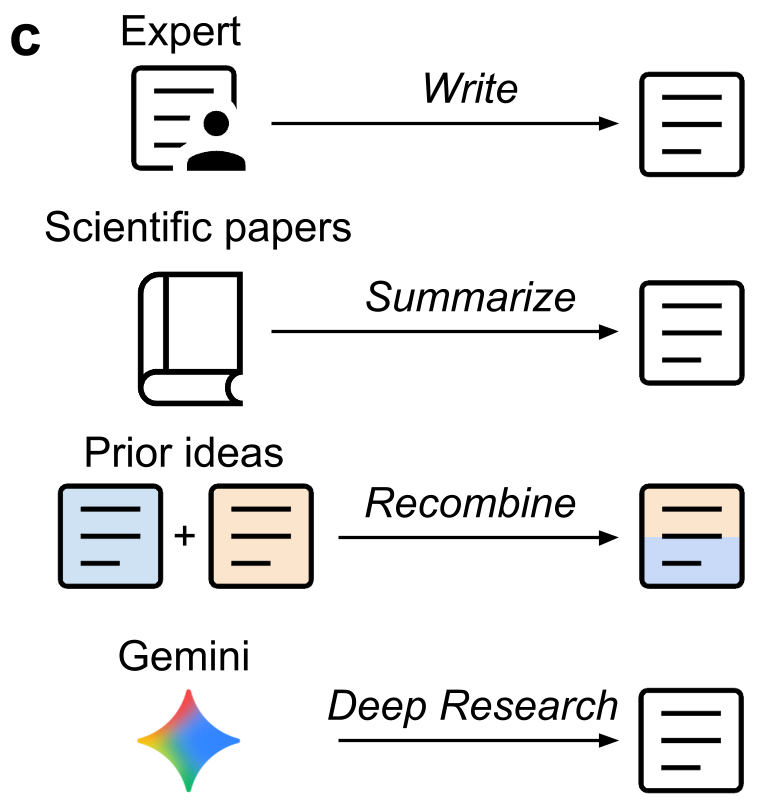
算法的社交性:思想的杂交 (Recombination)
ERA 的另一个重要发现是:算法也会“杂交优势”。当系统被指示将两个不同团队的成功模型(比如一个关注长期趋势的统计模型模型与一个捕捉短期波动的机器学习模型)融合时,生成的“混血”模型在 44% 的情境下优于其两个父类模型。这模仿了人类科学进步中“博采众长”的创新过程。
深度洞察:为什么 ERA 能赢?
- Semantic-aware Mutation:传统的遗传算法是盲目的,而 ERA 的突变是“语义级”的。LLM 理解代码逻辑,从而能进行有意义的结构化更改(如修改损失函数、引入新的特征层)。
- 打破局部最优:树搜索通过 Backtracking 机制,让系统在遇到死胡同时能够果断放弃,去探索之前被忽略的高潜力路径。
- 零疲劳探索:在单细胞数据分析实验中,ERA 能够持续运行数百个节点,尝试数千次代码组合,这种规模化的试错成本是人类科学家无法负担的。
总结与展望
ERA 证明了在那些可以通过“机器打分”来衡量好坏的科学任务中,人类专家的直觉已经不再是上限。虽然它目前还无法完全独立提出基础物理理论,但在经验软件设计方面,它已经成为了一个极其强大的 AI Co-scientist。
未来,随着 Gemini 3.1 Pro 等更强底层模型的介入,我们可能会看到这套系统在药物设计、材料科学等更复杂的领域实现更大规模的科研提速。
局限性提示:虽然 ERA 能够优化预测模型,但它对“因果机制”和“底层物理定律”的理解仍依赖于用户提供的初始提示词和评分标准。真正的自我意识科学发现仍有一段路要走。