
ERA:当 LLM 遇见树搜索,AI 正在重写科学发现的底层逻辑
An AI system to help scientists write expert-level empirical software
本文推出了 Empirical Research Assistance (ERA) 系统,这是一种利用大语言模型(LLM)驱动树搜索(Tree Search)来自动构建和优化专家级科学软件的 AI 系统。ERA 在生物信息学、流行病学和时间序列预测等多个 SOTA 榜单上超越了人类专家,例如在 scRNA-seq 批次效应整合任务中发现了 40 种超越现有顶级水平的新方法。
TL;DR
科学家们每天都在花费大量时间编写代码来验证假设。Google 团队最新发布的 Empirical Research Assistance (ERA) 系统彻底打破了这一瓶颈。ERA 不是简单的代码助手,它是一个能自我迭代的“专家级科学家”。通过结合 大语言模型 (LLM) 的语义理解能力和 树搜索 (Tree Search) 的全局寻优能力,ERA 能够从科研文档中提取灵感,自动编写、测试并优化科学软件,在生物信息学和流行病学等多个领域刷新了 SOTA 记录。
痛点深挖:为何科学软件的开发效率止步不前?
在科学研究中,软件的开发往往是“经验性”的。无论是处理单细胞测序数据,还是预测传染病趋势,设计算法时通常面临以下困难:
- 搜索空间巨大:预处理、特征工程、模型架构的组合成千上万,人类专家只能根据直觉测试极小一部分。
- 代码突变的局限性:传统的自动化框架(如 AutoML)或遗传编程(GP)搜索方式生硬,缺乏对算法背后物理直觉的理解。
- 开发周期冗长:从阅读一篇新论文到将其中的 Idea 转化为高效代码测试并落地,往往需要数周甚至数月。
核心架构:ERA 的“认知”与“搜索”双引擎
ERA 的核心直觉在于:将编写科学软件看作一个在代码空间中搜索以最大化“质量评分”的问题。
1. 语义感知的代码突变
与随机修改代码不同,ERA 利用 LLM 作为“突变算子”。它不仅理解 Python 语法,更理解“批次效应(Batch Effect)”或“自回归(AR)”等专业领域概念。
2. 基于 UCB 的树搜索 (Tree Search)
为了防止搜索陷入死胡同,ERA 采用了类似 AlphaZero 的树搜索策略(PUCT 算法)。它会平衡对高分路径的利用 (Exploitation) 和 对未知领域的探索 (Exploration)。当某个优化方向遭遇瓶颈时,系统会自动回溯(Backtrack)并从历史节点开启新的分支。
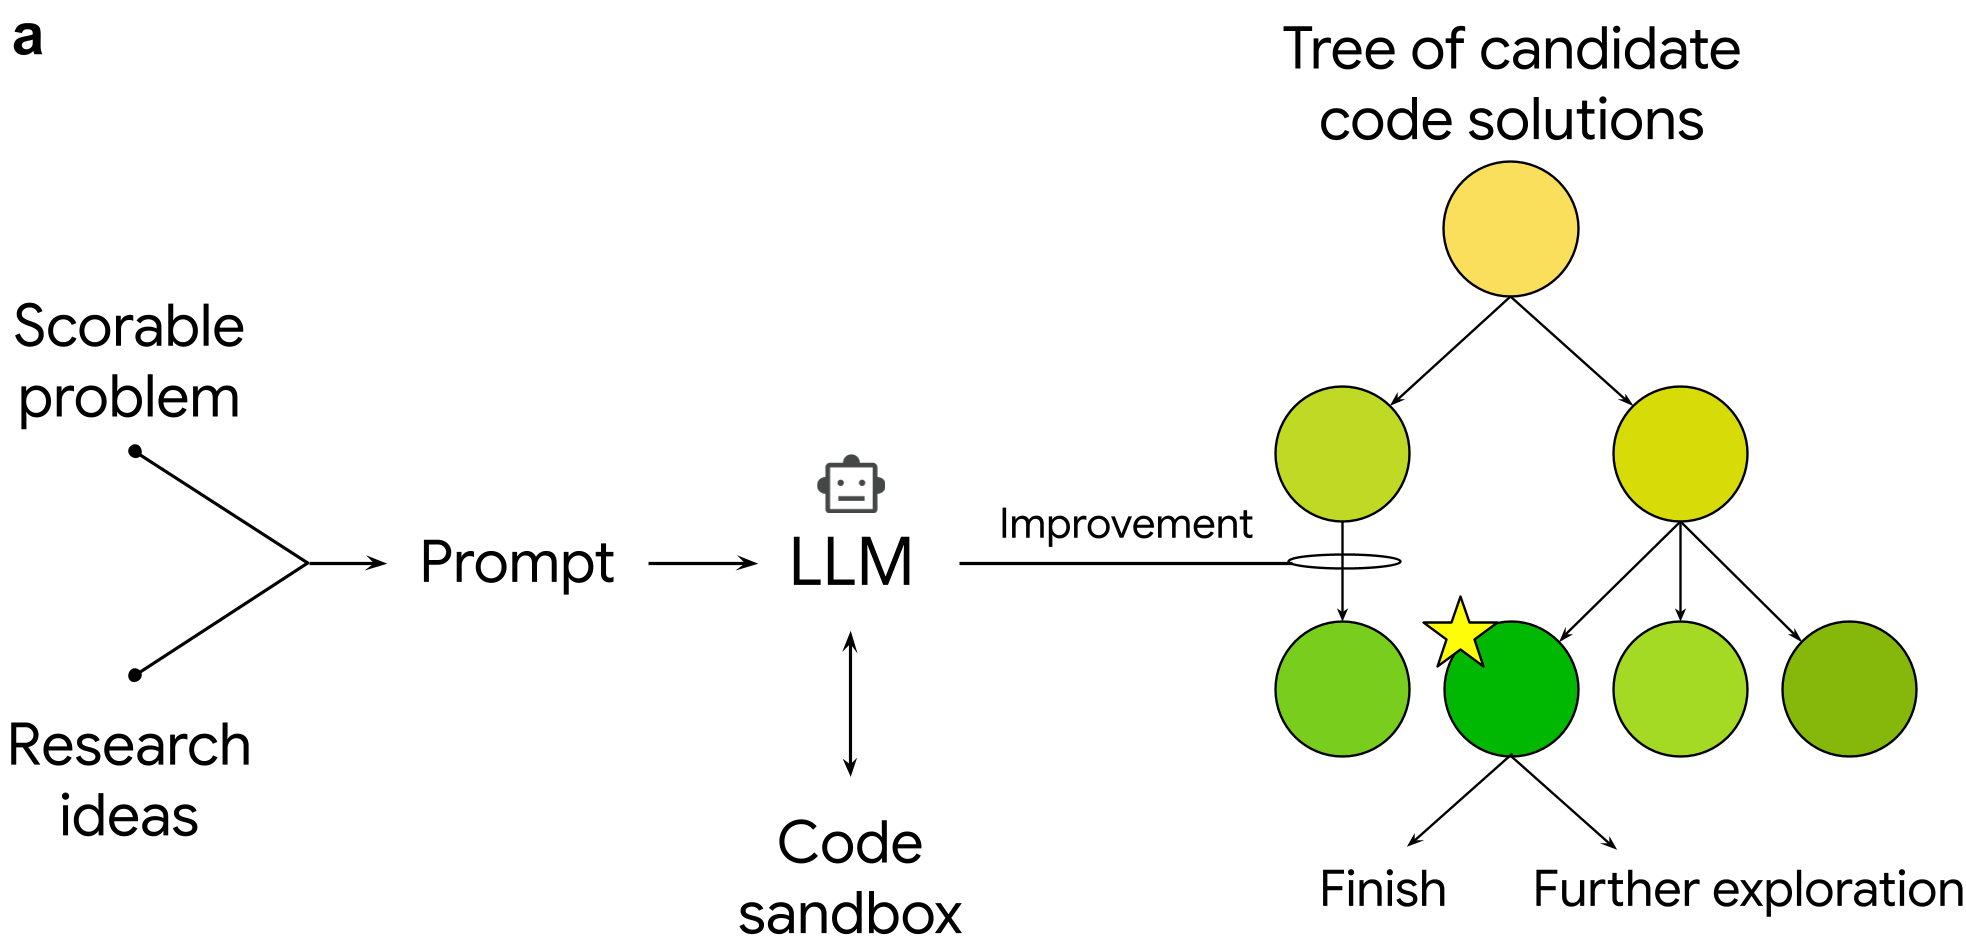 图 1:ERA 的核心流程——从任务定义、创意注入到基于树搜索的代码迭代。
3. 先验知识注入与“创意杂交” (Recombination)
这是 ERA 最具学术魅力的部分。它能自动阅读 PDF 文档(如顶会论文),将文字描述转化为代码逻辑。此外,ERA 还可以模仿人类科学家的“整合思路”,比如将方法 A 的特征工程与方法 B 的损失函数结合,产生更优的“杂交算法”。
实验与结果:全方位的专家级碾压
ERA 在多个高壁垒的科学维度证明了自己的实力:
- 单细胞基因组学:在 OpenProblems 榜单上,ERA 改进了经典的 BBKNN 算法。它自动发现了将 ComBat 校正与 PCA 嵌入结合的最佳路径,最终生成的 40 个新方法均超越了此前人类开发的最佳模型。
- 防疫预测:在 CDC 的 COVID-19 住院预测任务中,ERA 构建的模型在 WIS(加权间隔评分)指标上击败了所有个人模型及官方集成模型。
- 时间序列预测:在 GIFT-Eval 榜单上,ERA 自动构建了一个包含“趋势衰减因子”和“多国节假日特征”的复杂预测库,性能位列全球第一。
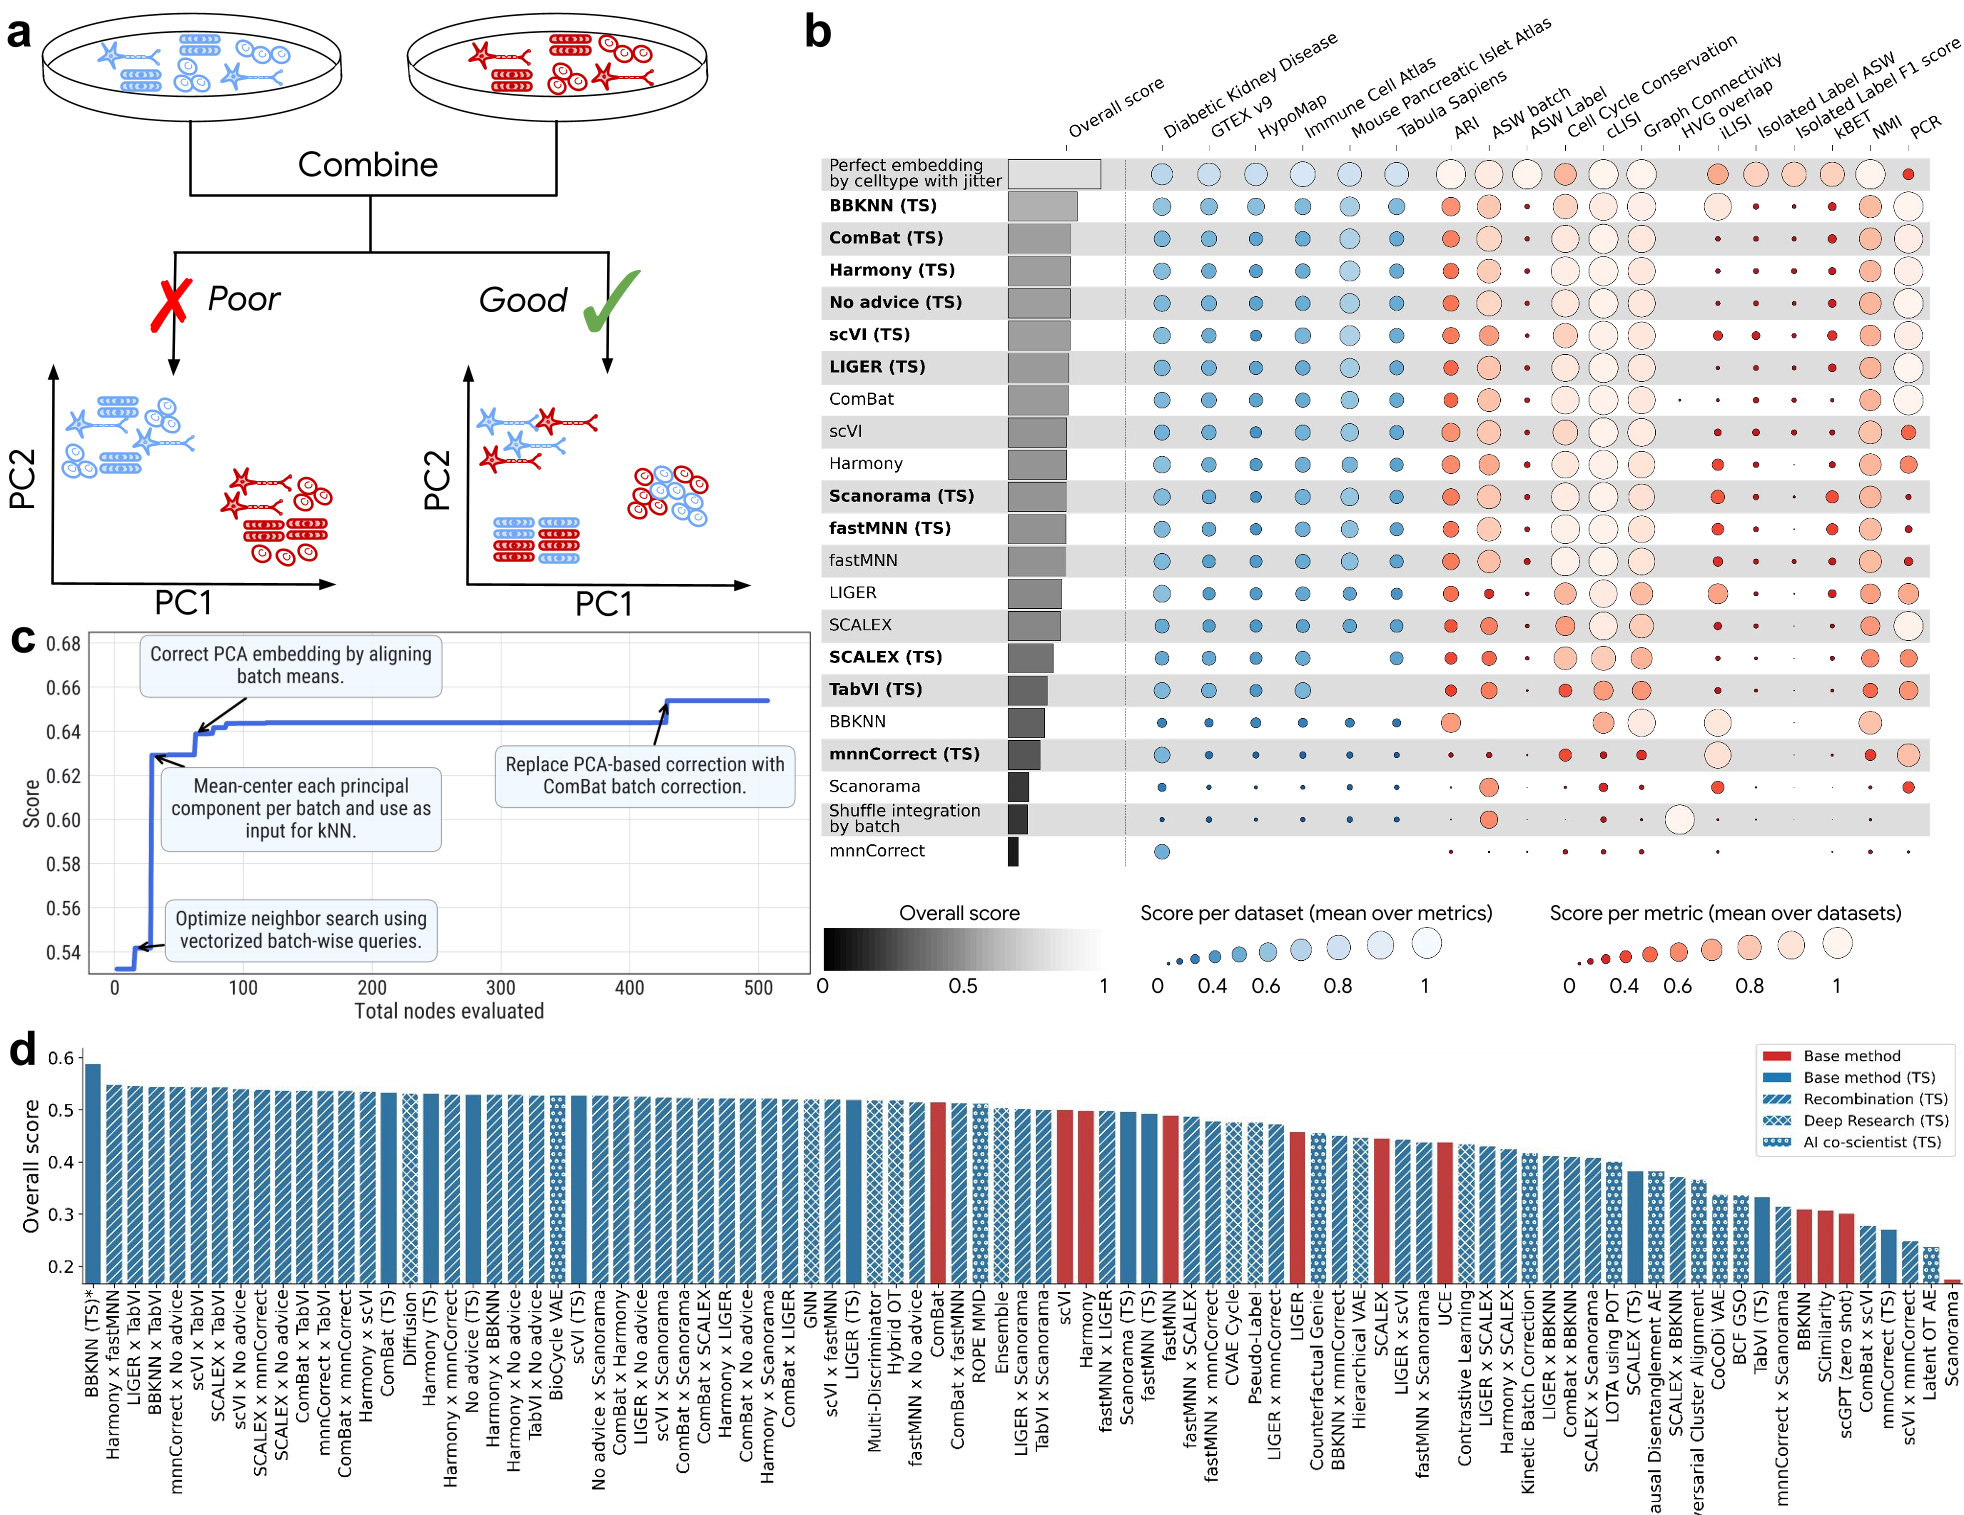 图 2:ERA 在 scRNA-seq 任务中通过“创意杂交”超越基准方法的表现分析。
深度洞察:从“预测”迈向“发现”
ERA 的成功不仅在于算力。其背后揭示了一个深刻趋势:科学软件的编写权正从单纯的手工劳动移交给大规模搜索。
- 局限性分析:尽管 ERA 在经验性任务(Empirical Tasks)上表现卓越,但对于需要深层因果推理或构建全新理论框架的“从 0 到 1”的科学发现,仍需人类科学家定义最初的评价指标(Scoring Function)。
- 未来展望:随着基础模型(Foundation Models)的长文本理解力提升,ERA 这种“阅读-搜索-实现”的闭环将变得更加高效。它不仅是科学家的辅助工具,更像是科学发现过程的“加速器”。
通过将科研 Idea 转化、测试的周期从数月压缩至数小时,ERA 预示着一个智能驱动的实验发现时代已经到来。