
ERA:深度搜索+LLM 开启专家级科学软件的自动化发现时代
An AI system to help scientists write expert-level empirical software
本文推出了 Empirical Research Assistance (ERA),这是一个结合了大语言模型(LLM)与树搜索(Tree Search, TS)的 AI 系统,旨在自动开发专家级科学软件。系统在生物信息学(单细胞集成)、流行病学(COVID-19 预测)及时间序列预测等 6 个领域达到了 SOTA 水平。
TL;DR
由 Google DeepMind 和 Google Research 团队推出的 Empirical Research Assistance (ERA) 系统,标志着 AI 在科学发现流程中的角色发生了质变。ERA 不仅仅是一个写代码的助手,它通过**树搜索(Tree Search)**大规模地在代码空间中进行定向演进,通过“阅读”顶会论文、自动提取 idea 并将其重组成新型算法。它在单细胞测序、疫情预测和遥感分析等多个严苛的科学赛道上,直接击败了人类专家积累多年的 SOTA 方案。
痛点深挖:科学软件开发的“手工作坊”瓶颈
在计算密集型科学领域,软件性能往往决定了研究的上限(如 DFT 计算、AlphaFold 等)。然而,当前的科学软件开发面临三个核心痛点:
- 低效的手动迭代:研究者需要花费数周甚至数月来编写、测试和调整实验代码。
- 局部最优陷阱:设计选择(如数据预处理、模型架构)多凭直觉,无法穷举所有潜在的组合路径。
- 领域门槛极高:编写高性能的流行病学模型或生物信息学工具需要跨学科的深厚造诣,普通开发者难以涉足。
核心机制:当 Tree Search 遇上代码重写
ERA 的本质是一个闭环优化系统。它将科学任务转化为一种“可打分任务”(Scorable Task),其工作流程如下:
1. 迭代式代码变异(Code Mutation)
与传统的遗传算法(GP)随机改变代码片断不同,ERA 利用 LLM 对现有代码进行语义感知的重写。这意味着 AI 能够理解代码的物理逻辑,从而进行有意义的修改。
2. PUCT 指导下的深度探索
ERA 使用了受 AlphaZero 启发的 PUCT 算法在代码空间中导航。
- Exploitation(开发):利用当前表现最好的代码路径。
- Exploration(探索):尝试全新的、具有潜力的变体。 这种结构允许系统在遇到优化瓶颈时进行“回溯”(Backtracking),重新开启新的分支。
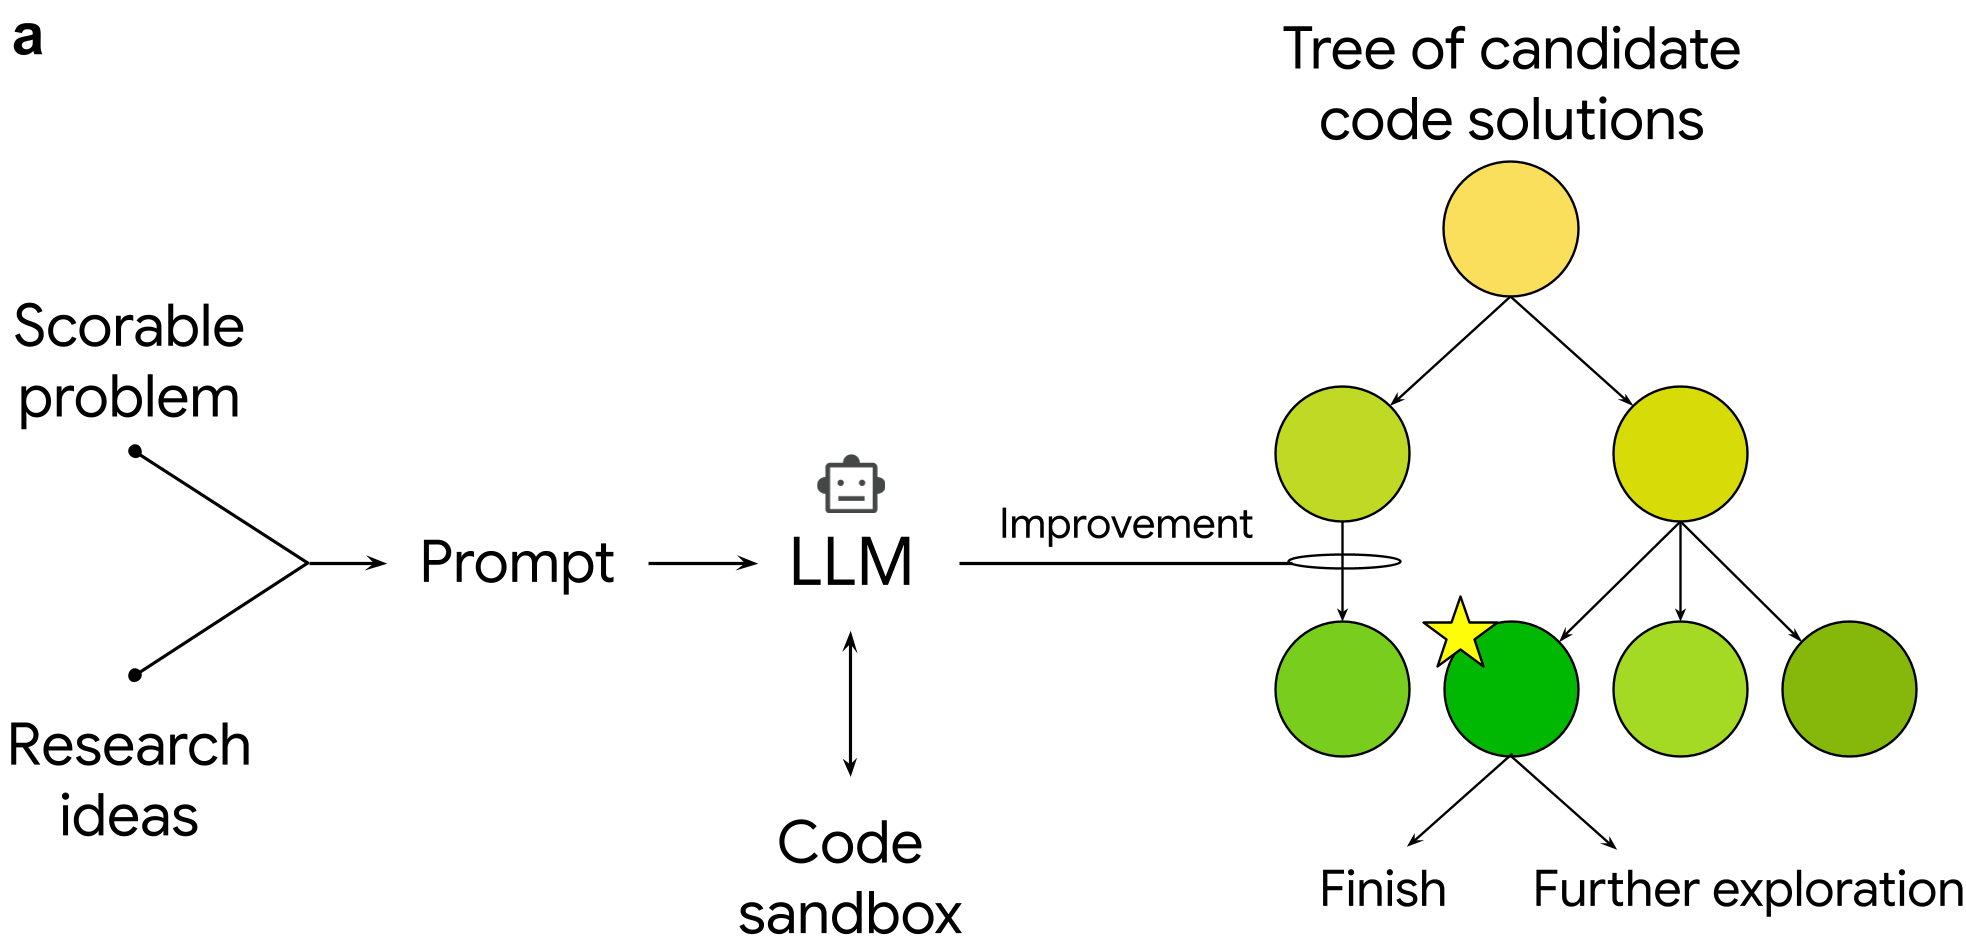 图 1:ERA 流程图,展示了从任务描述、研究思想注入到沙盒评估、树搜索循环的全过程。
3. 研究思想的注入与组合(Recombination)
ERA 最具突破性的能力是其“集成研究思想”的方式。研究者将 SOTA 论文的 PDF、教科书中的公式或搜索结果喂给 LLM,ERA 能将这些高层次的 idea 翻译成具体实现。更进一步,ERA 还能进行思想杂交(如将 ComBat 的线性校正与 BBKNN 的图构建相结合),从而发现全新的混合算法。
实验战绩:全线击败人类模型
场景一:单细胞 RNA 测序集成
单细胞数据的批次效应(Batch Integration)是生物信息学的难点。ERA 仅通过简单的引导,就发现了 40 种全新的集成方法,在 OpenProblems 排行榜上全面超越了人类专家提交的已有方案。
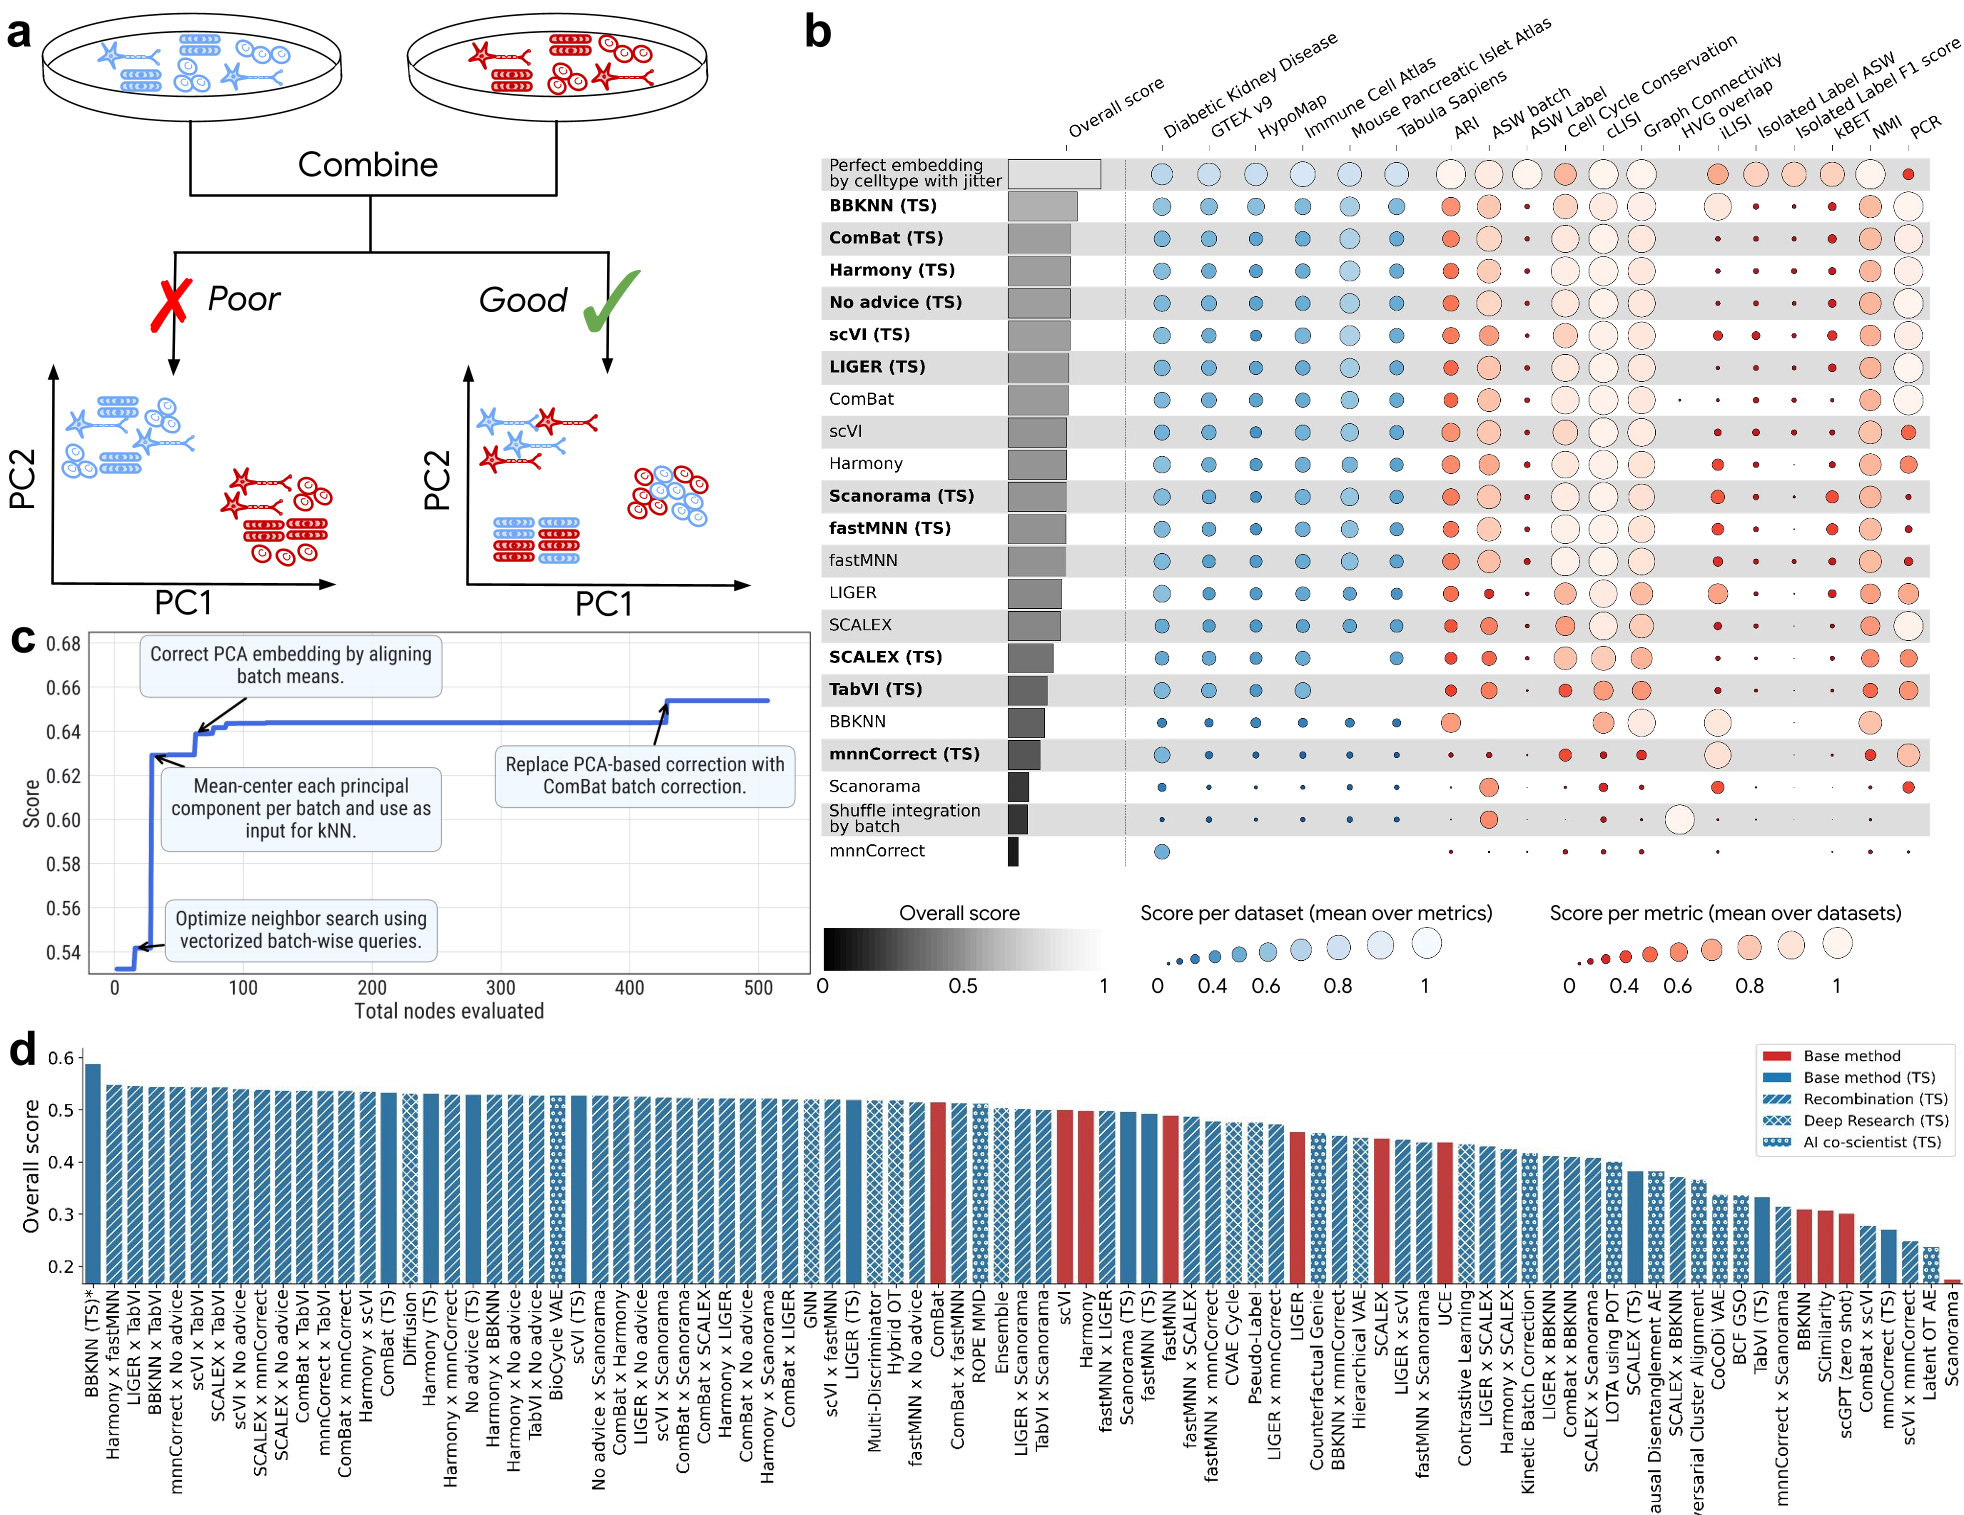 图 2:ERA 方法在多个度量指标上显著优于已发表的经典算法。
场景二:COVID-19 住院人数预测
在流行病学任务中,ERA 开发了一系列模型。在 2024-2025 的回顾性测试中,ERA 生成的混合模型获得了 26 的平均加权区间得分(WIS),击败了包括 CDC 官方集成模型(WIS=29)在内的所有竞争对手。
深度洞察:为什么 ERA 如此强大?
- 跨尺度重组:人类专家往往局限于特定的算法范式。ERA 能够快速测试“深度学习+传统数理统计”的混合模式,验证那些人类认为可能“反直觉”但实测有效的组合。
- 不眠不休的规模化搜索:ERA 在单次实验中可以探索上千个节点(Node),每个节点代表一个独立的算法变体。这种搜索强度是人类手动调优无法企及的“暴力美学”。
- 从预测到发现的跃迁:论文特别提到了在宇宙弦引力波辐射谱的研究中,该系统发现了 6 个全新的解析推导公式,这表明系统已经开始触及符号化科学发现的边界。
总结与未来展望
ERA 证明了:当 LLM 被赋予了“搜索权”和“现实反馈指标”后,它们能从简单的代码生成器进化为真正的 AI Co-Scientist。
局限性:目前的 ERA 极度依赖“可衡量指标”(Quality Metric)。对于那些难以量化目标或缺乏精确验证环境的科学问题,ERA 仍需人类进行巧妙的度量设计。
未来启示:这一工作的成功预示着,未来的科研流水线将是:人类科学家负责提取假说和定义目标,而 AI 系统如 ERA 则负责在干船坞中自动构建最精密的计算工具,大幅缩短从理论到实证的距离。
注:文中提到的专用术语如 SOTA, PUCT, WIS, mIoU 等均保留学术原文,以确保技术表达的精准性。