
ERA:AI 驱动的科学“进化论”,从手动编码到专家级软件自动化
An AI system to help scientists write expert-level empirical software
本文推出了 Empirical Research Assistance (ERA) 系统,旨在将 AI 生成代码与 Tree Search (TS) 结合,自动化构建专家级科学软件。ERA 在单细胞测序数据整合、COVID-19 预测及 GIFT-Eval 时间序列预测等多项基准测试中超越了人类开发的 SOTA 方法。
核心速览
TL;DR:Google 团队推出了名为 ERA (Empirical Research Assistance) 的 AI 系统。它不仅是一个代码生成器,更是一个能够阅读论文并提取科学直觉、通过**树搜索(Tree Search)**不断自我进化的“AI 科学家”。ERA 在单细胞基因组学、流行病学预测、地理空间分析等六大科学领域中,均生成了性能超越人类专家(SOTA)的软件工具。
背景定位:在 AI for Science 领域,ERA 代表了从简单的“黑盒模型”向“自动化专家建模”的演进。它通过 LLM 将人类已有的学术智慧转化为可运行的代码,并通过系统的搜索策略寻找复杂科学问题的“大海捞针”式最优解。
痛点深挖:为什么科学软件开发总是这么慢?
在传统的科研流程中,编写用于实验和建模的软件(Empirical Software)是最大的瓶颈。科学家往往根据直觉选择算法或调整参数,这一过程充满随机性且极其耗时。
- 搜索空间巨大:算法选择、预处理策略、超参数组合构成了无穷的解空间。
- 跨学科门槛高:将复杂的数学推导转化为稳健的代码本身就是一项挑战。
- 缺乏系统性改进:目前的科研软件大多是“点到为止”,很少有团队能通过成千上万次的迭代来压榨最后 1% 的性能。
方法论详解:LLM 与 Tree Search 的深度共生
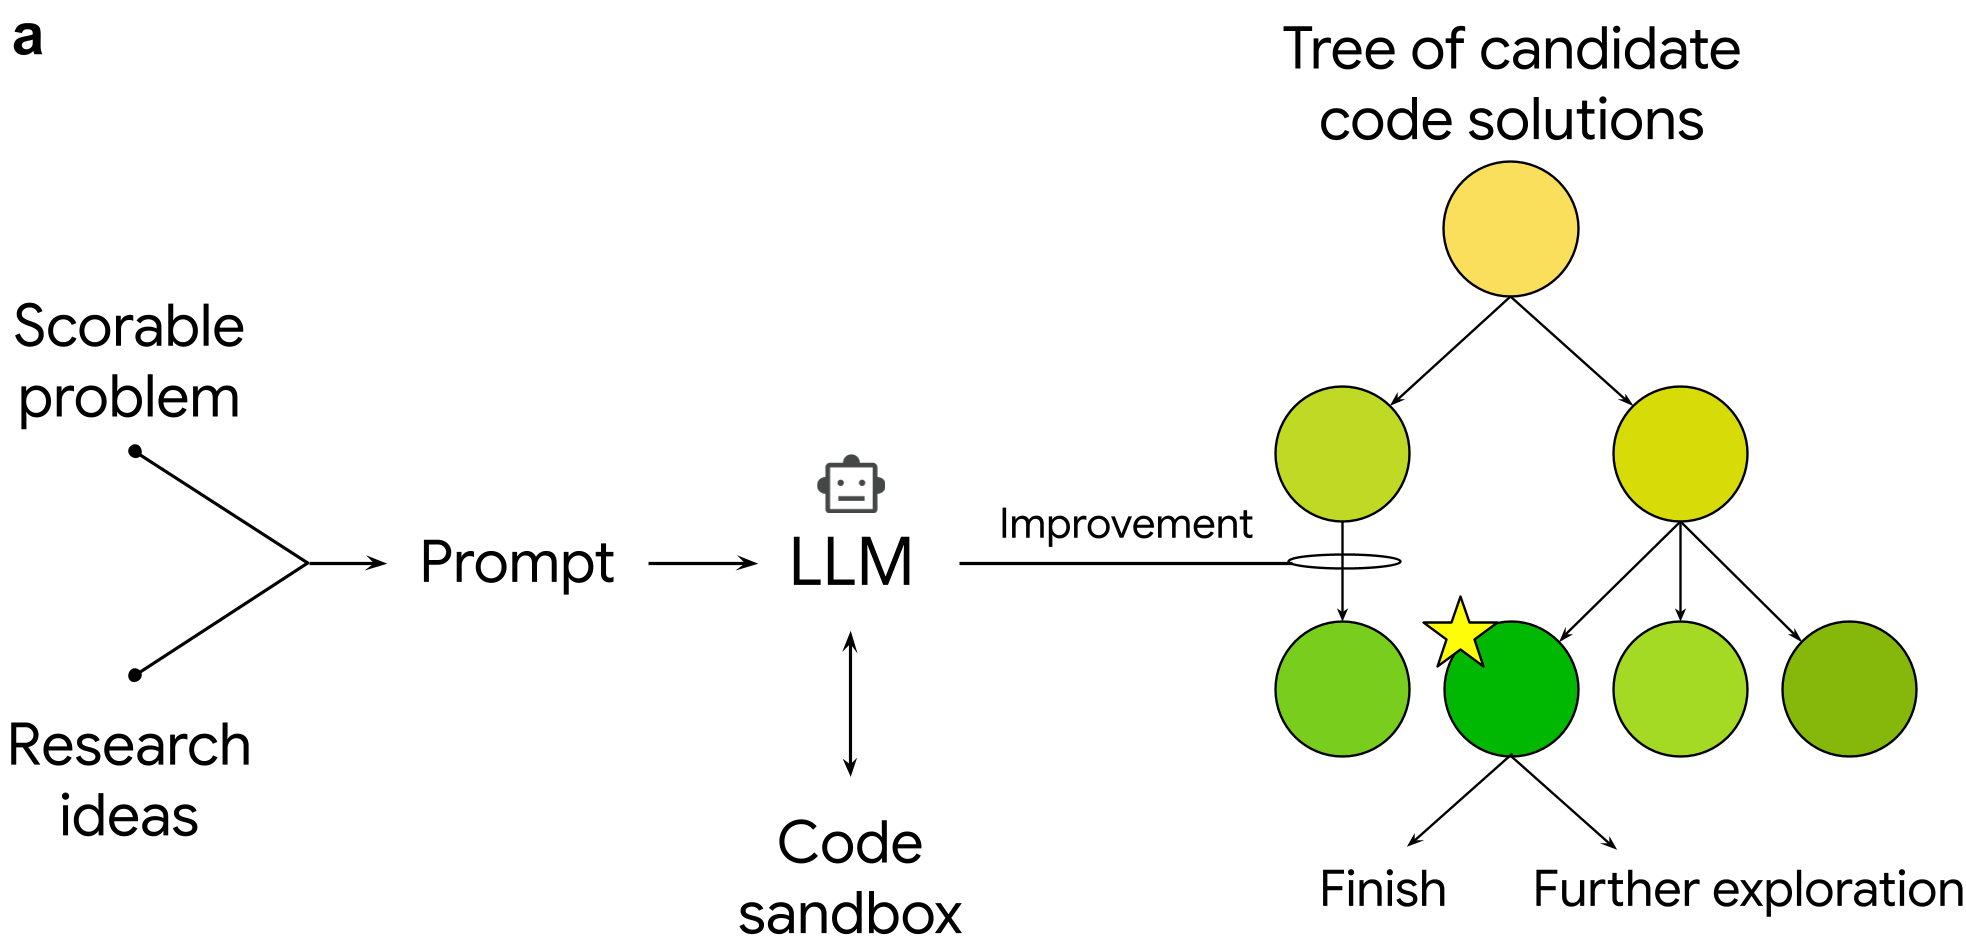
ERA 的核心在于其精妙的架构设计,它将科学问题的解决抽象为 “可评分任务”(Scorable Tasks)。
1. 架构解析
ERA 并不只是简单地调用 LLM 产生一段代码。它维护了一个解空间树:
- 节点(Node):代表一段可运行的 Python 代码。
- 边(Edge):代表 LLM 对父节点代码的一次基于语义的“变异”或优化。
- PUCT 算法:借鉴了 AlphaZero 的搜索策略,在“尝试已知表现好的方向(Exploitation)”与“跳出舒适区探索新思路(Exploration)”之间寻求平衡。
2. 文献驱动的 Idea 注入
ERA 最惊艳的一点是它能够阅读文献。通过将学术论文的 PDF 摘要注入 Prompt,ERA 能够模仿顶尖专家的思路(如引入 BBKNN 算法思想),甚至将两种完全不同的学术流派(如流行病学动力学模型与机器学习统计模型)进行异质重组(Recombination)。
实验与结果:全方位的专家级碾压
单细胞测序数据整合 (Genomics)
在处理超过 170 万个细胞的 OpenProblems 基准测试中,ERA 发现了 40 种全新的方法,显著优于目前的 Leaderboard。
- 核心发现:ERA 自动实现了类似 ComBat 与 BBKNN 的结合,这种“意料之外、情理之中”的创新通过了专家的代码审查。
时间序列预测 (GIFT-Eval)
在包含 97 个不同领域数据集的 GIFT-Eval 挑战中,ERA 生成的统一预测库不仅在性能上超越了 Chronos 和 TimesFM 等 Foundation Models,而且其逻辑清晰,包含对趋势、季节性和节假日的迭代分解。
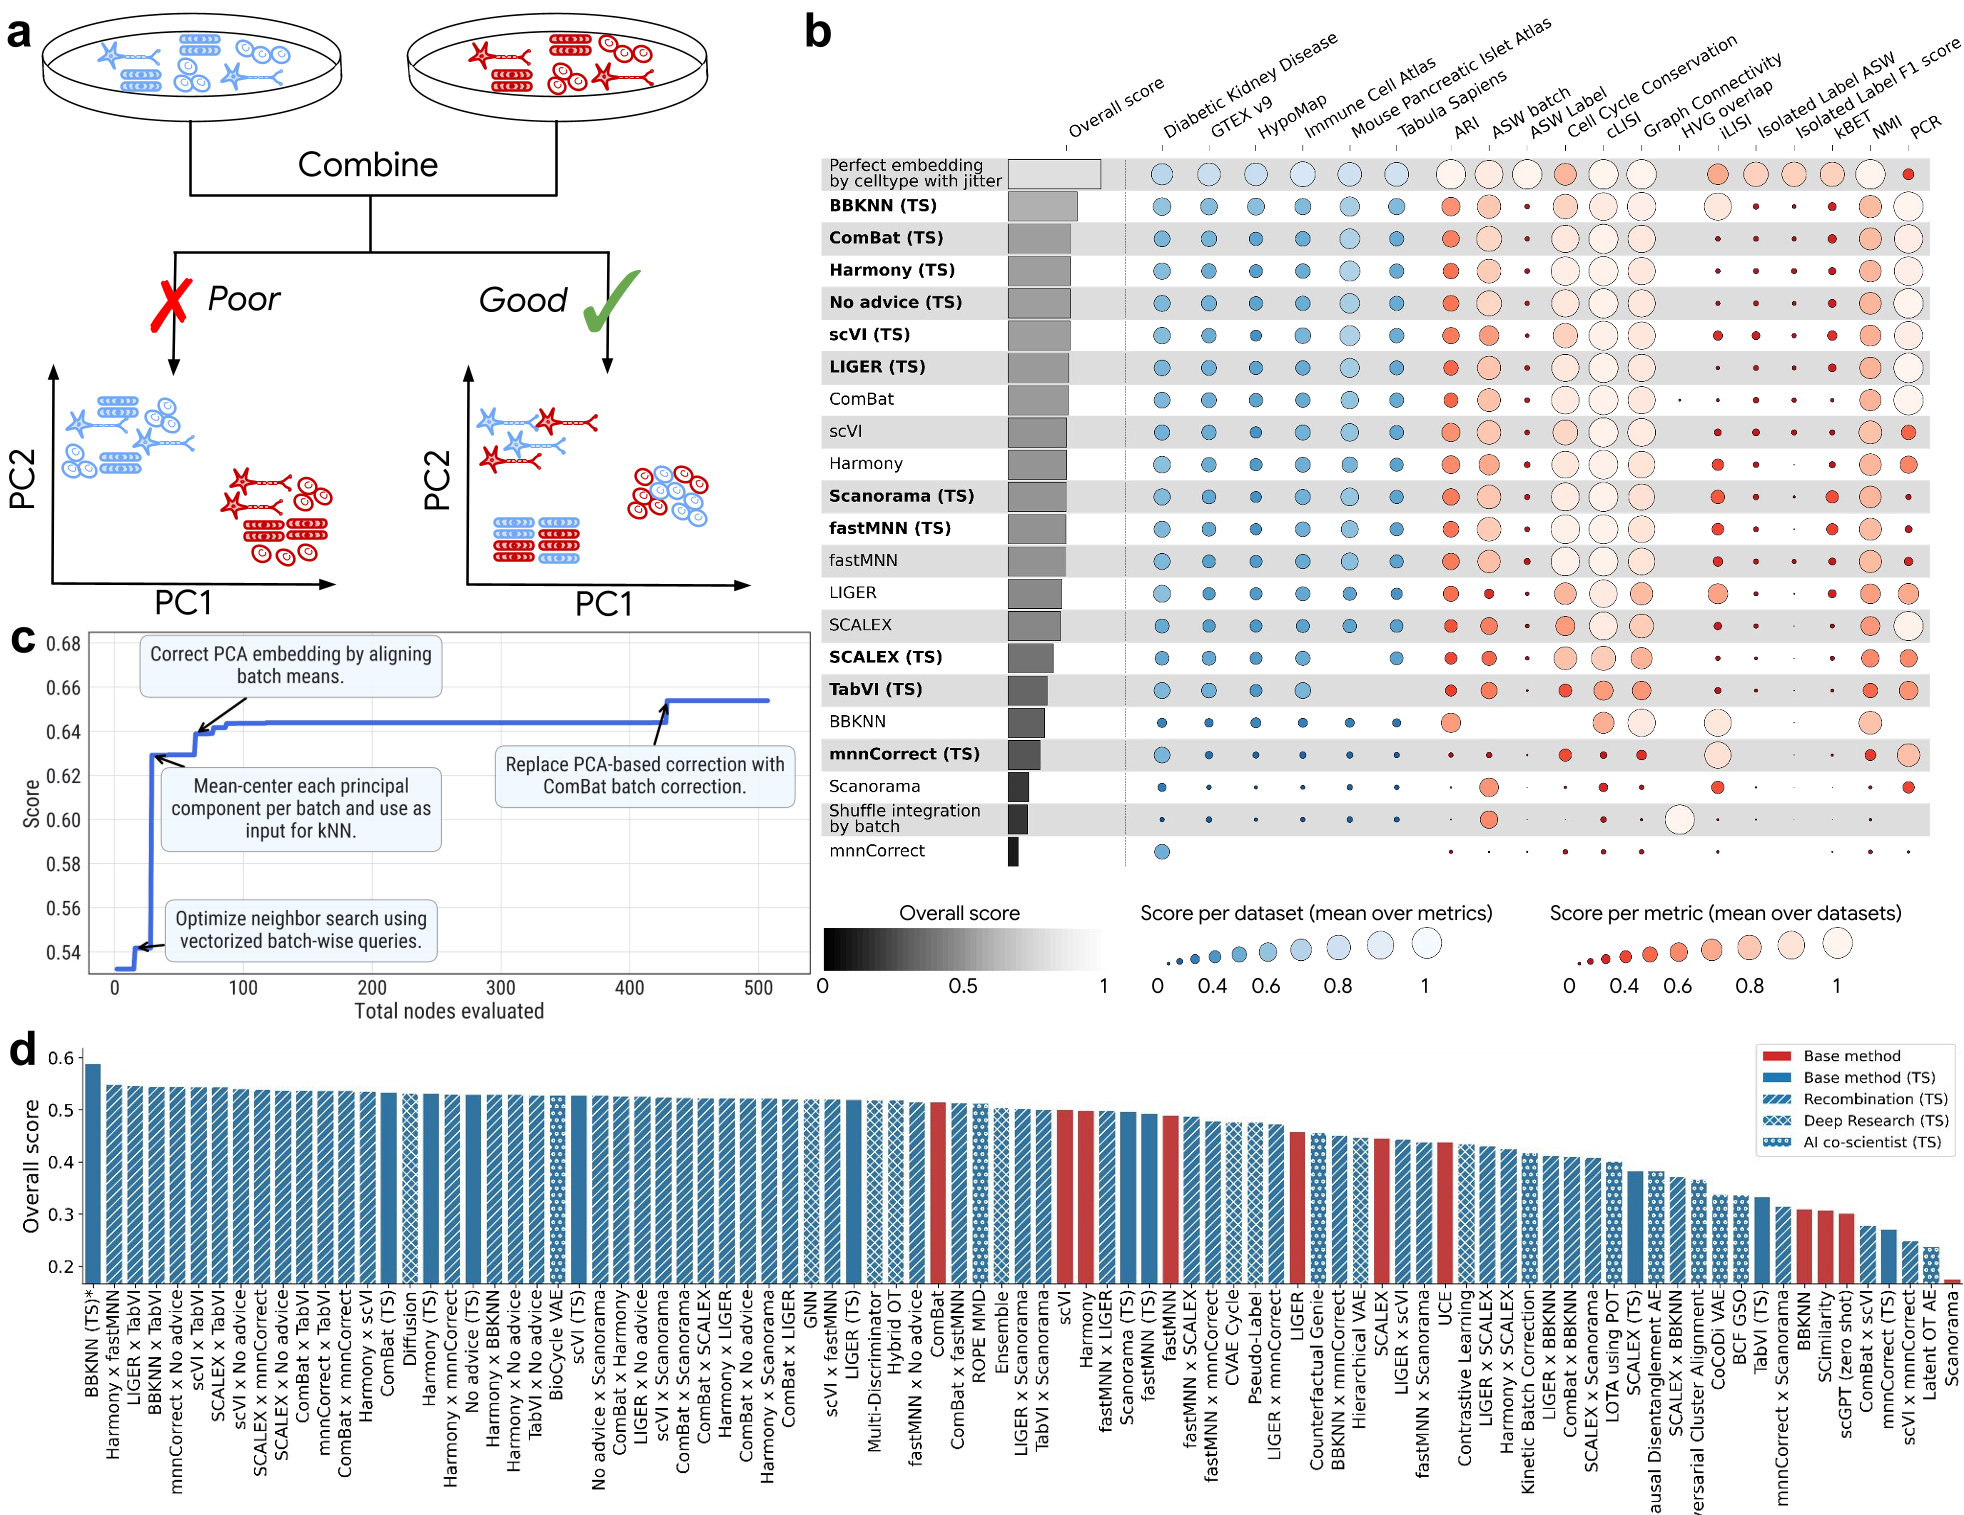 (上图展示了 ERA 开发出的方法如何通过多次跳跃式的得分提升,最终在基准测试中占据统治地位)
深度洞察与总结
为什么 ERA 有效?
ERA 的成功并非偶然,它捕捉到了科学发现中的“经验进化”本质。相比于纯粹的 AutoML,它利用 LLM 理解了代码背后的物理/逻辑含义。
- 突破局部最优:树搜索允许系统退回(Backtrack)并尝试全新的技术路线,这在手动编码中是极度昂贵的。
- 语义层面的重组:它不是在拼接随机字符,而是在拼接“科研 Ideology”。
局限性与展望
尽管 ERA 初露锋芒,但它依然依赖于可量化评分函数(Scorable Function)。对于那些难以直接评分的理论科学(如纯数学推导或定性分析),ERA 还需要更精细的反馈闭环。
未来展望:随着 Frontier Models 的推理能力持续增强,ERA 极有可能演变为一种“全自动 Co-Scientist”。未来的实验室可能不再需要成千上万的初级程序员,而只需要科学家定义好评分指标,由 ERA 这类系统完成从文献研读到算法落地的全闭环。
Takeaway: ERA 证明了 AI 在科学任务中的角色正在从“执行者”转变为“设计者”。通过融合学术直觉与暴力搜索,AI 正在以前所未有的速度重构人类的知识图谱。