
QREAM:对齐文档与问题,破解 RAG 中的“风格偏置”难题
Align Documents to Questions: Question-Oriented Document Rewriting for Retrieval-Augmented Generation
本文提出了 QREAM,一种面向问题的文档重写框架,旨在通过将检索到的原始文档转化为“面向问题(Question-oriented)”的风格,提升 RAG 系统中 LLM 阅读器的信息利用率。QREAM 通过两阶段(QREAM-ICL 探索与 QREAM-FT 蒸馏)实现了事实准确性与风格相关性的统一,在多个 ODQA 基准测试中取得了显著的 SOTA 性能提升。
TL;DR
即使你为大模型提供了正确的事实,如果这些事实隐藏在凌乱、冗余的检索文档中,模型也可能宁愿相信那些“说得好听”的幻觉。本文提出的 QREAM 通过将检索文档“整容”成面向问题的风格,不仅把重写后的幻觉率降到了 9.2%,还让轻量级 1B 模型跑出了超越 8B 模型的 RAG 效果,是 RAG 管道中极具价值的“即插即用”优化模块。
背景:为什么你的 RAG 总是“看走眼”?
在 Open-Domain QA 任务中,RAG 已经是标配。但研究发现,LLM 阅读器其实是个“颜控”:
- 检索文档(Retrieved Doc):事实准确,但通常包含大量无关信息,结构零散。
- 生成的文档(Generated Doc):结构清晰、针对性强,但经常一本正经地胡说八道(幻觉)。
可怕的是,当两者冲突时,大模型往往会因为风格偏置(Stylistic Bias),被生成内容的“丝滑”表述迷惑,从而抛弃检索到的真相。QREAM 的核心动机就是:既然模型喜欢这种风格,那我们就把检索到的真理,重写成模型喜欢的样子。
核心方法:QREAM 的“先探索后蒸馏”范式
QREAM (Question-oriented document Rewriting) 并非简单的摘要,它通过一套严密的流程确保“风格对齐”且“事实保真”。
1. QREAM-ICL:风格种子的魔力
为了学习“面向问题”的风格,作者利用不相关的 seed questions 生成了一些背景材料作为示例。通过这种方式,模型学会的是结构和语气(Style),而不是内容(Content)。接着,通过 3 轮迭代重写,模型不断精炼上下文,提取高密度信息。
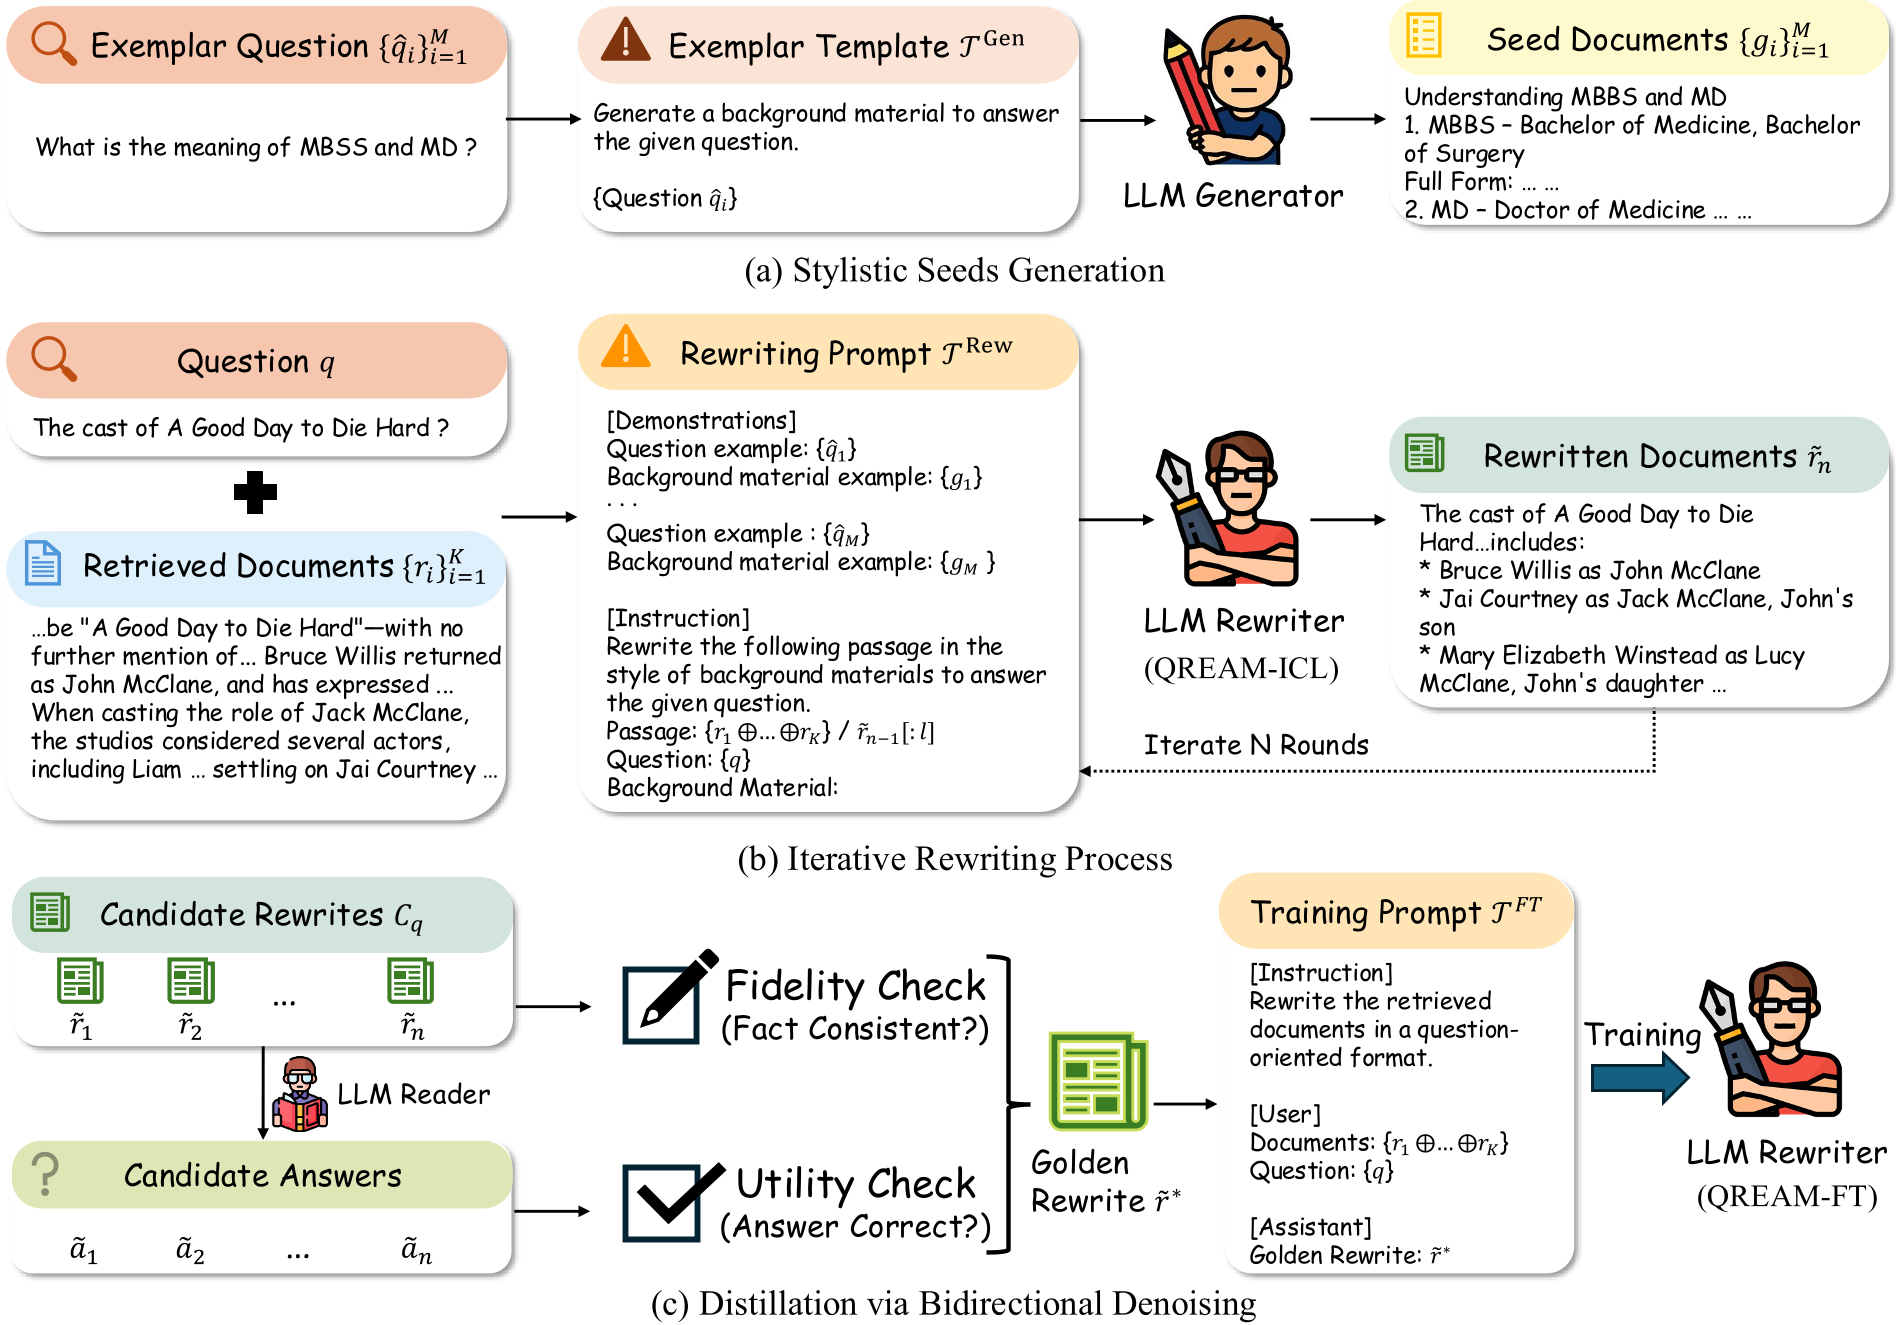 图 1:QREAM 框架的两阶段流程:(a-b) 阶段 I 的 ICL 探索,(c) 阶段 II 的双准则去噪蒸馏
2. QREAM-FT:双准则去噪蒸馏
ICL 虽然强大,但在迭代中容易引入噪声或幻觉。QREAM 提出了双准则拒绝采样(Dual-criteria rejection sampling):
- 下游效用检查(Downstream Utility):重写后的文档能让阅读器输出正确答案吗?
- 上游忠实度检查(Upstream Fidelity):重写后的每一个事实都能在原始文档中找到根据吗?
通过这两道关卡的过滤,作者筛选出“黄金数据”,训练出了一个轻量级的 Llama-3.2-1B 学生模型。这个小模型在推理时只需要一次 Forward Pass,完美兼顾了性能与效率。
实验战绩:1B 模型逆袭 8B 老师
在 NQ、TriviaQA 和多步推理数据集 HotpotQA 上,QREAM 表现惊艳:
- 全面超越基线:相比于直接拼接检索和生成内容的策略,QREAM 在多步推理任务上准确率提升了约 8%。
- 效率奇迹:QREAM-FT (1B) 的延迟仅为 0.18s,几乎与不重写的原始 RAG 持平(0.16s),远快于 8B 老师模型的 2.41s。
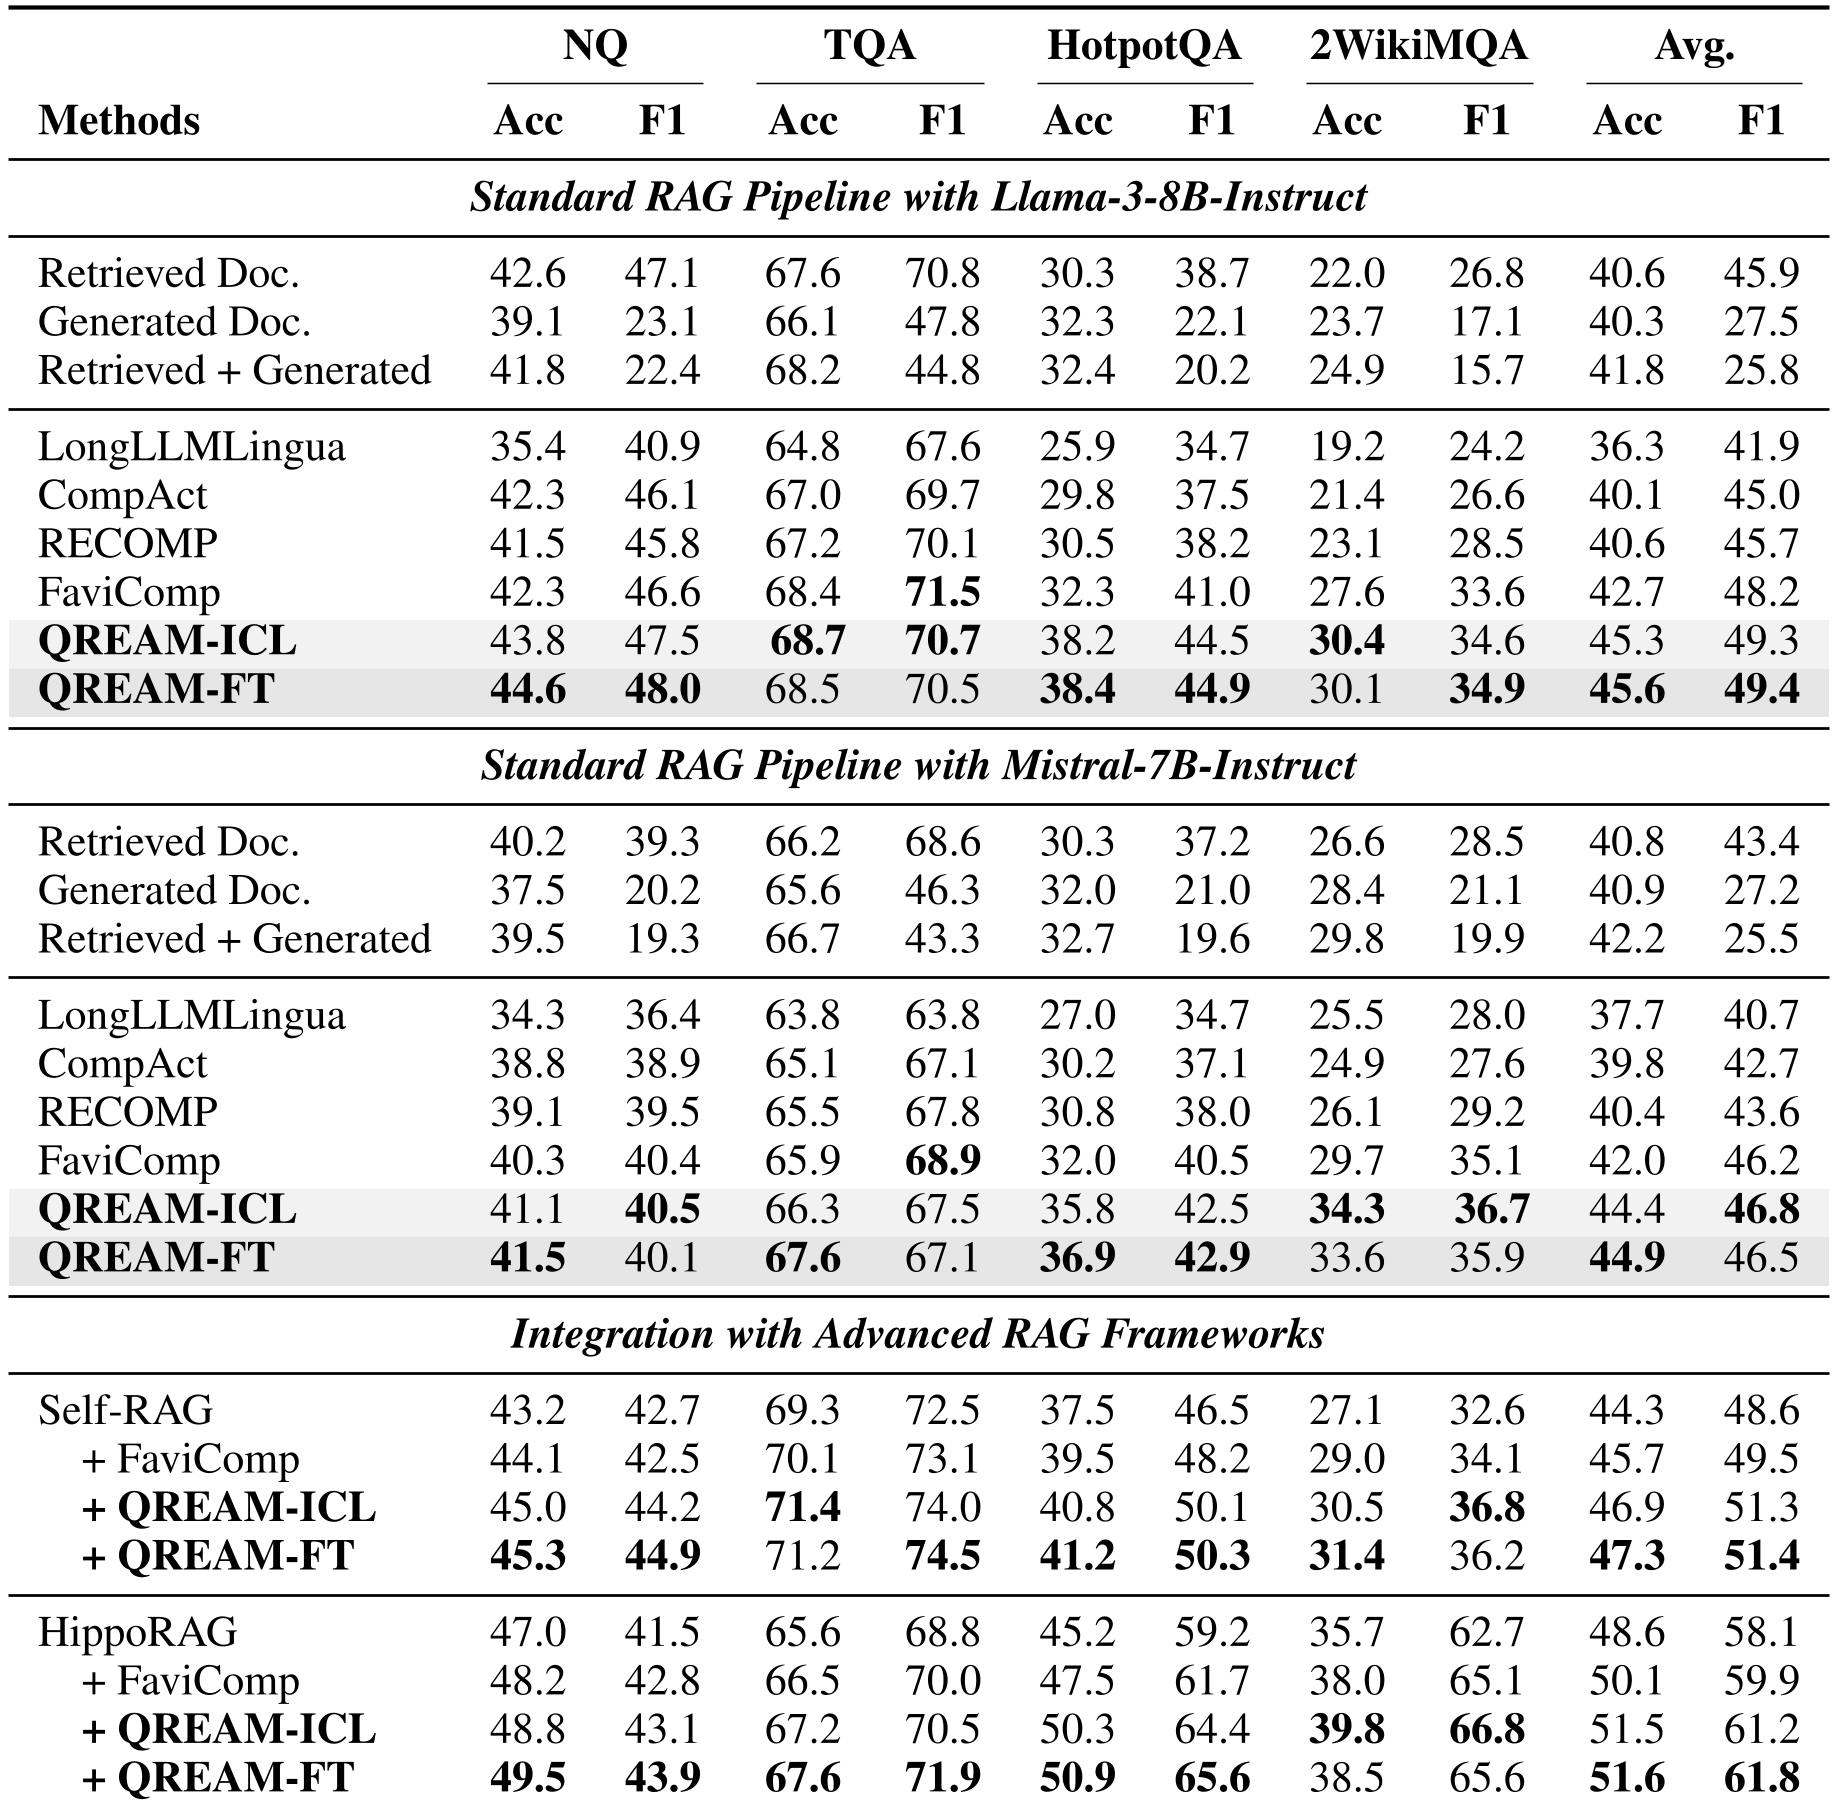 表 1:QREAM 在不同 LLM 阅读器和进阶 RAG 框架(Self-RAG, HippoRAG)中的表现
深度洞察:对抗“风格偏置”
为了验证 QREAM 是否真的解决了偏置问题,作者设计了**上下文冲突(Context-Conflicting)**实验。在故意提供“正确检索文档”和“错误生成文档”的情况下,原始 Llama-3 的准确率惨不忍睹(仅 19.4%)。但在使用了 QREAM 重写文档后,准确率飙升至 77.4%!这有力地证明了 QREAM 能够通过优化呈现形式,让模型重新审视事实证据。
总结与局限性
QREAM 证明了 “面向问题的重写” 是打通 RAG 最后一步的关键。它成功地将生成式模型的灵活性与检索系统的可靠性融合在一起。
局限性:
- 强依赖检索质量:如果最初的检索环节完全脱靶,改写得再漂亮也无济于事。
- 计算开销:虽然 1B 模型已经很轻量,但在超高并发场景下,额外的 Inference 步骤仍需考虑成本平衡。
未来,将重写器与检索器进行联合训练(Joint Optimization),或许是解决 RAG 幻觉的终极路径。