
[Stanford] ARES:检索增强生成(RAG)系统的自动化评估“黄金标准”
ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems
本文推出了 ARES,一个针对检索增强生成(RAG)系统的自动化评估框架。ARES 通过合成数据微调轻量化语言模型作为判别器,并结合预测增强推理(PPI)技术,实现了在极少人工标注(约 150 条)下对上下文相关性、答案忠实度和答案相关性的高精度评估。
TL;DR
斯坦福大学联合 Databricks 推出了 ARES (Automated RAG Evaluation System)。这是一个专门为 RAG 系统设计的自动化评估框架,它通过微调轻量化判别器(Judge Models)来替代昂贵的人工评估或昂贵的 GPT-4 API 调用。相较于 RAGAS 等现有工具,ARES 最大的突破在于它引入了 PPI(预测增强推理) 技术,不仅提升了评估准确度,还能为每个评分提供统计学上的置信区间。
痛点深挖:为什么 RAG 的评估这么难?
构建一个 RAG 系统就像搭积木:你需要选择检索器(Retriever)、分块策略(Chunking Style)和生成模型(Generator)。然而,调整这些组件往往是“盲目”的,因为:
- 标注黑洞:每个新领域都需要海量的人工标注来判断检索对不对、回答准不准。
- 提示词脆弱性:现有工具(如 RAGAS)依赖固定的 Prompt,遇到特定领域词汇时稳定性极差。
- 误差未知:模型给出的评估分数(Judge)往往存在偏见或误判,且开发者无法量化这些误判的范围。
Methodology:ARES 是如何运作的?
ARES 的核心直觉是:与其直接用一个大模型做裁判,不如用领域数据训练一个专属裁判,并用统计学工具动态修正它的偏差。
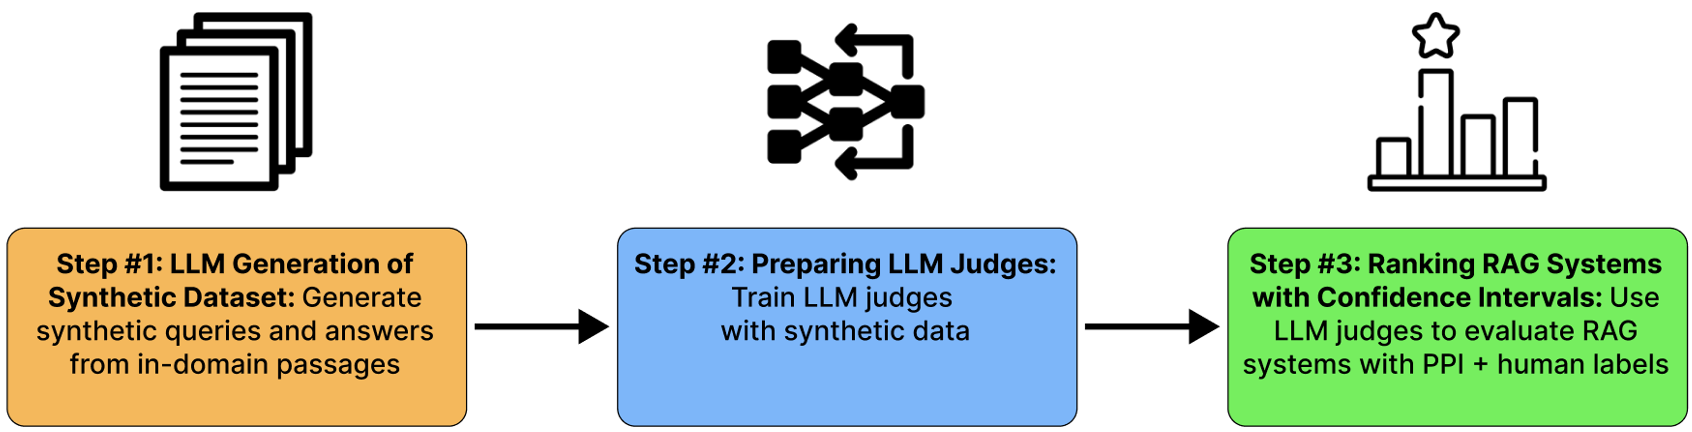
1. 合成训练数据的“博弈”策略
ARES 首先从文档库中提取 Passage,利用 FLAN-T5 生成正样本(相关的问答)。更关键的是,它提出了 强调负样本(Strong Negatives) 的生成策略:例如,从同一文档的不同段落中采样作为“干扰项”,迫使判别器学习细粒度的区分能力。
2. 判别器微调 (Fine-tuning Judges)
不同于零样本(Zero-shot)预测,ARES 使用合成数据微调了三个 DeBERTa-v3-Large 模型,分别针对:
- Context Relevance:检索到的背景是否切题?
- Answer Faithfulness:模型是否在胡说八道(幻觉)?
- Answer Relevance:模型的回答是否解决了用户的问题?
3. PPI:给评估打上置信区间
这是 ARES 的神来之笔。它使用 Prediction-Powered Inference (PPI) 算法,仅通过约 150 条人工标注作为“矫正器”。PPI 利用一个小的人工验证集来估计微调模型的误差函数(Rectifier Function),从而在处理大规模未标注数据时,能给出具备统计学保障的性能估计。
实验与结果:全方位的降维打击
在 NQ、HotpotQA 等多项知识密集型任务中,ARES 表现出了极强的韧性:
- 精准度:在上下文相关性判断上,ARES 的准确率比 RAGAS 高出近 60%。
- 排序稳定性:通过 Kendall's Tau 系数测试,ARES 能够极其准确地对多个不同配置的 RAG 系统进行优劣排序。
- 跨领域能力:模型在 NQ 上训练,直接迁移到医学或法律等领域(结合 PPI 矫正),依然保持高水平。
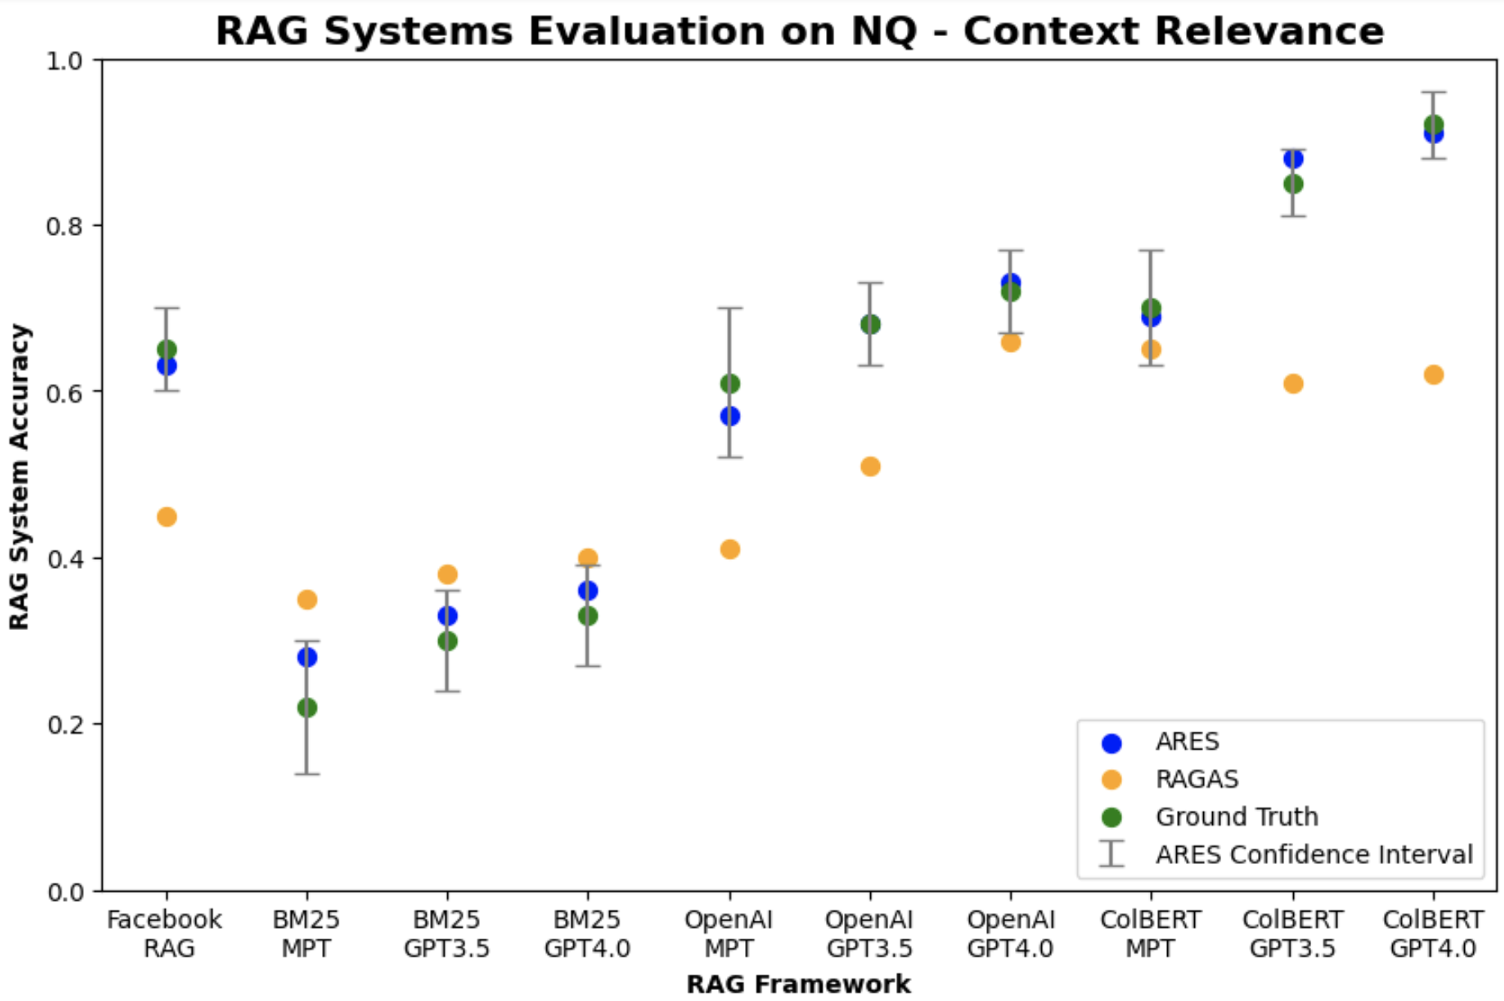 上图展示了 ARES 在不同 RAG 配置下(BM25, ColBERT 等)的评估表现,结果完美捕捉了 Ground Truth 的趋势。
深度洞察:为什么 ARES 值得关注?
ARES 的真正意义在于它打破了 “大模型评估大模型” 的无限追溯。通过 PPI 技术,它在小规模人工干预和大规模模型预测之间搭建了一座桥梁。
局限性分析:
- 冷启动成本:虽然标注需求减少了,但微调 DeBERTa 和运行 T5 生成合成数据仍需要一定的 GPU 手续费和计算时间。
- 特定任务失效:论文指出,在跨语言(如德语、西班牙语)或代码生成任务中,基于英语文本训练的裁判模型依然存在严重的泛化问题。
总结
ARES 不仅仅是一个好用的工具包,它代表了评估哲学从“依赖 Prompt Engineering”向“系统化机器学习评估”的转变。对于正在构建企业级 RAG 应用的团队,ARES 提供了一个兼顾经济成本与科学严谨性的落地方案。