
AstroRAG:利用 PageRank 重塑天文学问答的检索深度
AstroRAG – A Pagerank-Based Retrieval-Augmented Generation Pipeline for Question Answering in Astronomy
本文提出了 AstroRAG,一种专门为天文学问答定制的轻量级、无需训练的检索增强生成(RAG)流水线。该系统核心通过结合最大边际相关性(MMR)与基于 PageRank 的重排序机制,在 Mistral-7B 模型上实现了 79.49% 的准确率,较原始基线性能近乎翻倍。
TL;DR
针对天文学领域术语密集、公式繁多导致的 LLM 幻觉问题,AstroRAG 提出了一种“轻量级、全本地”的 RAG 方案。它不依赖于昂贵的模型微调,而是通过**两阶段检索(MMR + PageRank)**精准捕捉互补的学术证据。实验显示,这一机制让基础模型 Mistral-7B 的性能提升了近 3 倍,在 AstroQA 榜单上达到了 79.49% 的顶尖水平。
背景定位:垂直领域的“噪声”困境
在大模型处理天文科研问题时,经常面临两个挑战:一是参数化知识过期或缺失(如最新的超新星数据);二是证据干扰。传统的 RAG 系统倾向于将搜索到的 Top-K 片段一股脑丢给模型,但在天文文献这种信息密度极高的场景下,“多即是少”,过多的无关信息会稀释关键证据,触发 LLM 的“Lost in the Middle”效应。
痛点深挖:为什么“Retrieve-and-Dump”不再奏效?
- 空间效率低下:固定数量的切片往往包含重复信息或互斥的上下文,浪费了宝贵的 Context Window。
- 缺乏互补验证:普通的向量检索只关注片段与问题的相关性,而忽略了片段之间是否能形成相互印证的逻辑链。
- 知识泄露与隐私:在处理特定的科研任务时,长效索引可能导致跨任务的数据污染。
方法论详解:PageRank 重排序的直觉
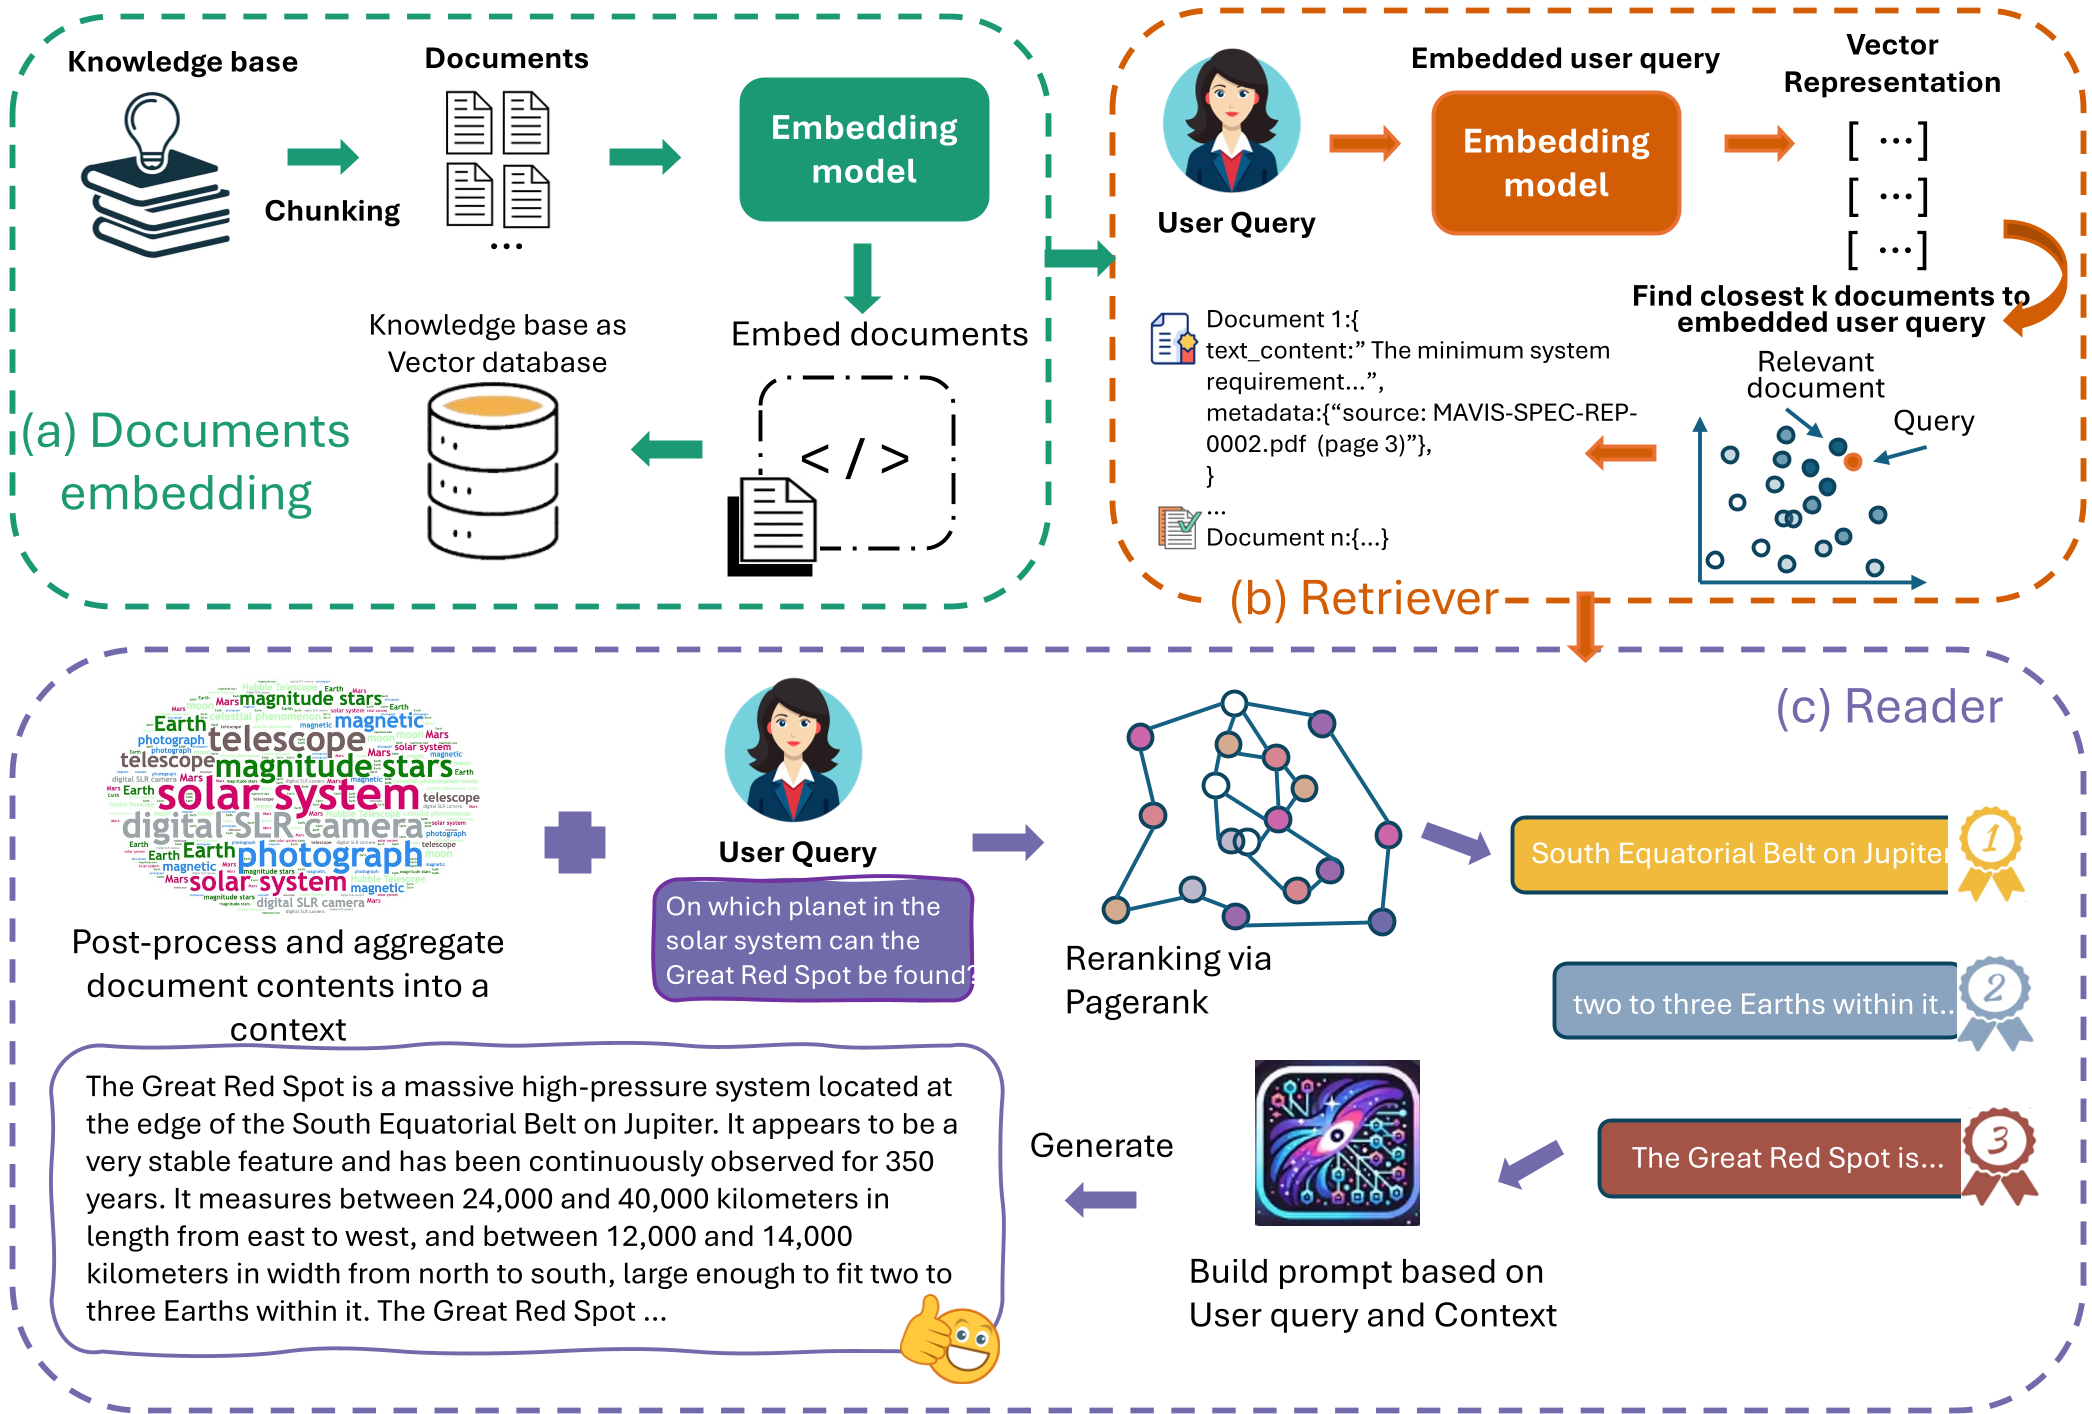
AstroRAG 的核心创新在于将图论中的 PageRank (PR) 引入重排序阶段,其逻辑可以拆解为以下架构:
1. 瞬时索引 (Transient Indexing)
为了保证科研的复现性与隐私,AstroRAG 为每个问题实例创建临时的 Elasticsearch 索引,处理完即删除。这种全本地化的流程保证了数据的物理隔离。
2. 两阶段检索策略
- Stage 1 (MMR):使用最大边际相关性(Maximal Marginal Relevance)初步筛选。其目标是在维持查询相关性的同时,减少候选片段间的冗余。
- Stage 2 (PageRank Re-ranking):
- 系统将检索到的片段视为节点,片段间的语义相似度视为边。
- 核心逻辑:一个好的证据不仅要和问题相关(Personalization Vector),还应该与其他证据片段有语义上的“互证”关系。
- 执行 PR 算法后,排名靠前的片段是那些“既在点子上,又能与其他上下文形成合力”的内容。
实验与结果:小模型也能翻身
在 AstroQA 数据集上的测试结果令人振奋:
- 基线对比:在无需微调的情况下,Mistral-7B + AstroRAG 的表现(79.49%)优于经过大规模天文语料微调的 AstroSage-8B 原生表现(41.71%)。
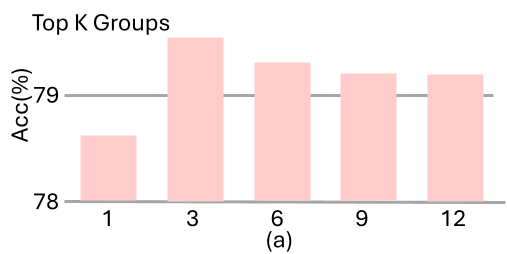
- 消融实验:PageRank 的 Top-K 选值对精度影响显著。实验发现,将 K 设为 3 能够通过最紧凑的上下文触发模型最强的推理能力,随着 K 的增加,噪声引入反而导致性能下滑(如下图 a 所示)。
深度洞察:PageRank 同 LLM 的化学反应
AstroRAG 的成功揭示了一个重要的技术取向:与其追求无限长的上下文窗口,不如追求更高纯度的上下文质量。
PageRank 在此实际上充当了一个“语义过滤器”。在天文学这种严谨的学科中,正确的解释往往会在不同文献中以不同的表达反复出现。通过构建相似度图,PR 算法能够自动识别这些“共识性”片段,从而规避了孤立片段可能带来的噪声或长尾错误。
总结与局限
Takeaway: AstroRAG 为专业领域提供了一个高性能、工业级的私有化部署范式。它证明了经典算法与生成式 AI 结合的巨大潜力。
局限性:
- 检索延迟:每题建立临时索引和执行迭代 PR 计算会增加一定的首字生成时间。
- 多模态缺失:目前尚未处理天文论文中极其重要的星系图像和光谱图表。
未来展望: 随着 OCR 和多模态大模型的成熟,将 AstroRAG 扩展到多图文检索将是天文 AI 助手的下一个极值点。