
[NR 2006] 通过 EndoV 的非对称底物识别实现平衡的线性多重 SNP 分型
Harnessing asymmetrical substrate recognition by thermostable EndoV to achieve balanced linear amplification in multiplexed SNP typing
本文提出了一种利用嗜热核酸内切酶 V (EndoV) 与 Bst DNA 聚合酶协同作用的等温线性 DNA 放大方法。该方法通过精确控制错配碱基及其周边序列,实现了高达 100 倍的 multiplexed 目标分子扩增,并成功应用于 12 个 SNP 位点的平衡分型。
TL;DR
针对多重 PCR 扩增中普遍存在的扩增偏差(Bias)难题,本文通过“跨界”利用 DNA 修复酶 EndoV 与具有链置换能力的 Bst 聚合酶,开发了一种新型等温线性扩增技术。该方法仅需单引物,可在 65°C 下高效运作,在实现 100 倍扩增的同时,将等位基因的表示偏差控制在 1.3 倍以内,极大地提升了 SNP 分型的准确性与平衡性。
背景定位
在基因组研究中,多重扩增(Multiplexed Amplification)是提高通量的关键。然而,由于引物结合效率、序列复杂度及动力学差异,多重 PCR 往往是“弱肉强食”的过程。本研究处于 等温扩增技术 (Isothermal Amplification) 与 高精度 SNP 检测 的交汇点,是对传统 PCR 偏好性问题的理论与实践双重突破。
痛点深挖:为何 PCR 和 SDA 无法做到真正“平衡”?
- 指数增长的诅咒:PCR 是指数扩增,微小的扩增效率差异会被无限放大,导致严重的 Allele Dropout。
- 引物干扰:随着引物对数量增加,非特异性产物(引物二聚体)呈指数级增长,消耗大量反应底物。
- 修饰依赖型 SDA:传统的链置换扩增需要限制性内切酶,且通常需要在模板链引入硫代磷酸(Phosphorothioate)修饰来抑制其切割模板,限制了方法的灵活性。
方法论:EndoV 与 Bst 的“华尔兹”
作者的直觉源于 EndoV 独特的生理功能。在体内,EndoV 负责修复脱氨基碱基,它会结合到特定位点并在 3' 侧切开磷酸二酯键。
核心机制
- 非对称识别 (Asymmetrical Recognition):作者设计了一个含尿嘧啶(U)的引物,使其与目标序列形成 U:T 错配。
- 选择性切开 (Nicking):Tma EndoV 在 65°C 下识别该错配,并仅切开引物链。
- 循环延伸:EndoV 切开后会解离(而非像执行修复任务时那样紧紧结合),此时 Bst 聚合酶从切口处利用其 Strand-displacement 活性向前延伸,将原有链替换下来,并暴露出新的错配位点供下一次 Nicking 使用。
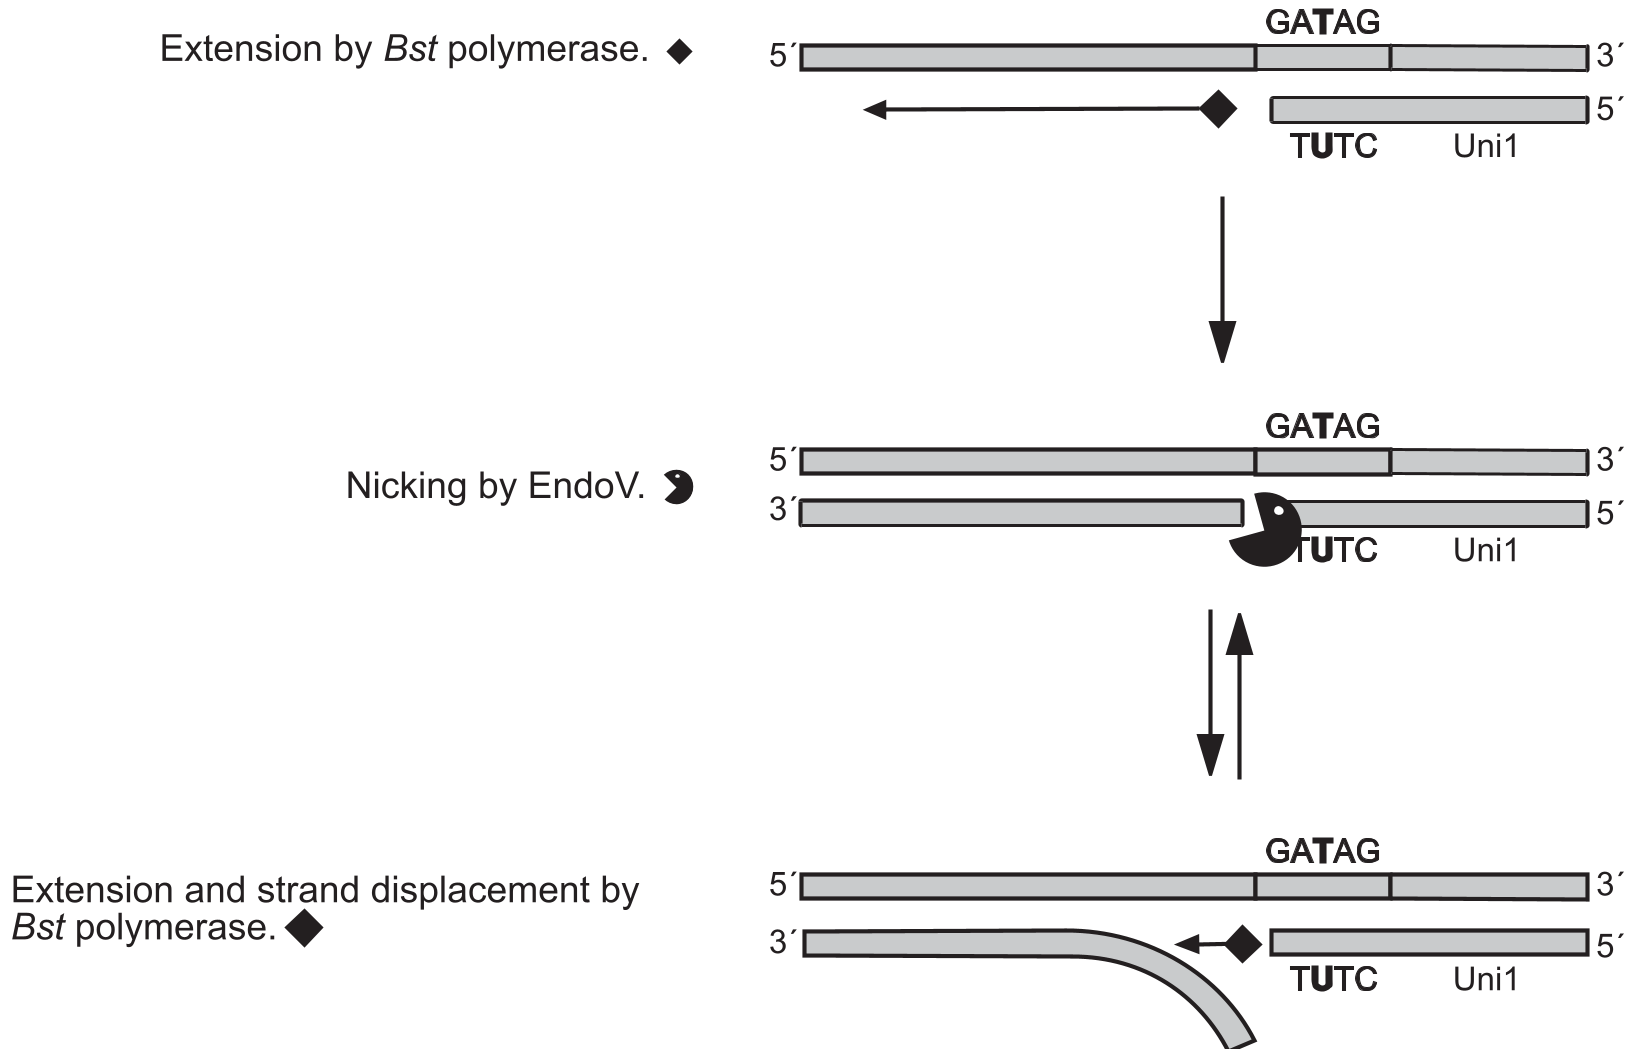 算法流程:引物退火 -> EndoV 识别并 Nicking -> Bst 聚合酶延伸并排空旧链 -> 动力学循环
序列背景的优化
EndoV 的活性极度依赖错配碱基周围的序列。通过消融研究,作者发现 GATAG 背景下的 U:T 错配能产生最高的扩增效率,比不加酶的背景信号提升约 25 倍。
实验战绩:极致的扩增平衡
研究团队在 12 个人类基因组 SNP 位点上验证了该技术。
- 低偏差验证:在 100 倍稀释的模板实验中,各等位基因的相对比例保持得惊人地完好。
- 定量性能:与 LDR (Ligase Detection Reaction) 偶联使用时,即便在高度多重化的环境下,也能维持极高的信噪比。
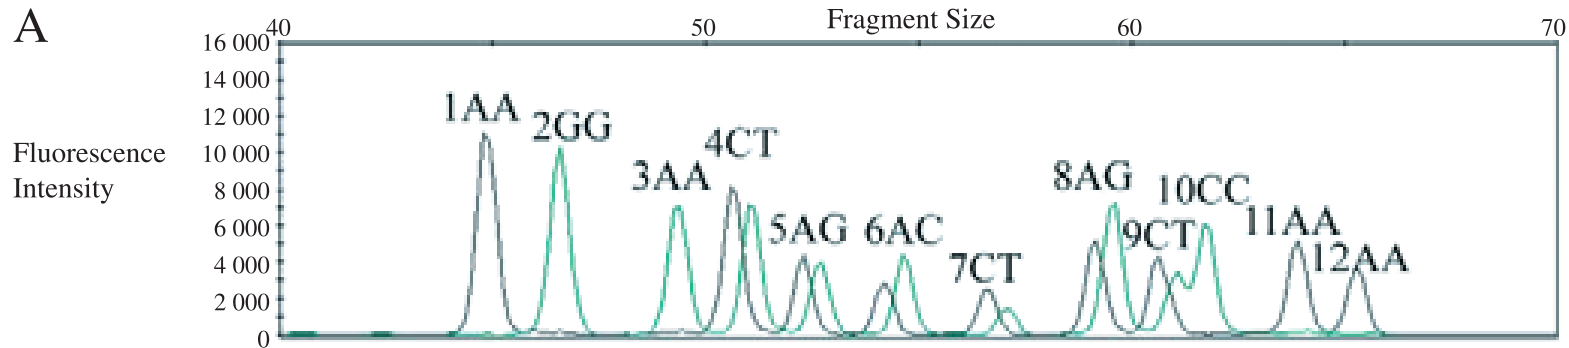 SNP 分型图谱:对比不同稀释度下的电泳峰图,各峰之间的相对高度(代表等位基因比例)几乎没有缩放失真。
深度洞察:为什么这种线性扩增更优?
相比于 TaqI 依赖的方法,EndoV 系统不需要对模板进行化学修饰,这大大降低了实验门槛。由于是线性扩增,不同目标之间的竞争被弱化,且单一引物的设计从根本上消除了引物二聚体的温床。
局限性与展望
尽管该方法在维持平衡性方面表现卓越,但目前能量化的扩增倍数约为 100 倍。若要实现更高量级的扩增(如 10,000 倍),可能需要进一步优化循环效率或开发“线性之上的线性”架构。
总结
本文巧妙地将分子生物学中的修复机制转化为一种强大的工程化工具。它不仅是 SNP 检测的技术改进,更为未来需要高度定量、低偏差的单分子分析(如肿瘤早期筛查和拷贝数变异研究)提供了坚实的底层逻辑。