
Attention Is All You Need:开启大模型时代的架构革命
Attention Is All You Need
本文提出了 Transformer 架构,这是首个完全摒弃循环(Recurrent)和卷积(Convolutional)结构,仅依赖注意力机制(Attention Mechanism)建立的序列转导模型。该模型在 2014 WMT 英德和英法翻译任务上均刷新了 SOTA 记录,展示了卓越的并行化能力和训练效率。
核心速览 (Executive Summary)
TL;DR:Google 团队在 2017 年发布的这篇里程碑论文,提出了 Transformer 模型。它彻底抛弃了过去十年统治 NLP 领域的循环神经网络(RNN)和卷积神经网络(CNN),仅通过自注意力机制(Self-Attention)捕捉全局依赖。这不仅大幅提升了模型在翻译任务上的 BLEU 分值,更重要的是,它解决了深度学习模型在工业级训练中的并行化难题。
背景定位:这是自然语言处理(NLP)领域的开坑之作。它定义的 Encoder-Decoder 架构变体,成为了后续 BERT、GPT、Llama 等几乎所有现代大语言模型(LLM)的共同祖先。
痛点深挖:为何 RNN 必须被取代?
在 Transformer 之前,所有的序列建模基本都依赖 RNN 及其变体(LSTM/GRU)。RNN 的设计初衷是模拟人类阅读:逐字读入,维护一个隐藏状态(Hidden State) 来记忆上文。
这种设计存在两个致命缺憾:
- 无法并行 (Sequential Bottleneck):计算第 个词必须等待第 个词算完。在处理数千词的长文本时,计算效率极低。
- 长距离遗忘 (Distance Challenge):信息在经过长路径传递后会稀释。虽然 CNN(如 ByteNet)能并行处理,但要连接两个远距离词项,需要叠加多层网络,计算路径仍是对数或线性增长。
架构解析:Transformer 的“三板斧”
Transformer 的核心直觉是:关联 (Alignment) 与距离无关。
1. 缩放点积注意力 (Scaled Dot-Product Attention)
作者提出将输入映射为 Query (Q), Key (K), Value (V) 三种特征。通过计算 与 的内积来决定关注度,公式如下: 引入 缩减因子是为了防止梯度消失,这是在大维度下保持训练稳定的关键。
2. 多头注意力 (Multi-Head Attention)
与其用一个巨大的注意力窗口,不如将其拆分为多个低维的“头”。Multi-Head 允许模型在不同的子空间同时并行关注不同类型的信息(例如,一个头关注代词指代,另一个头关注动宾关系)。
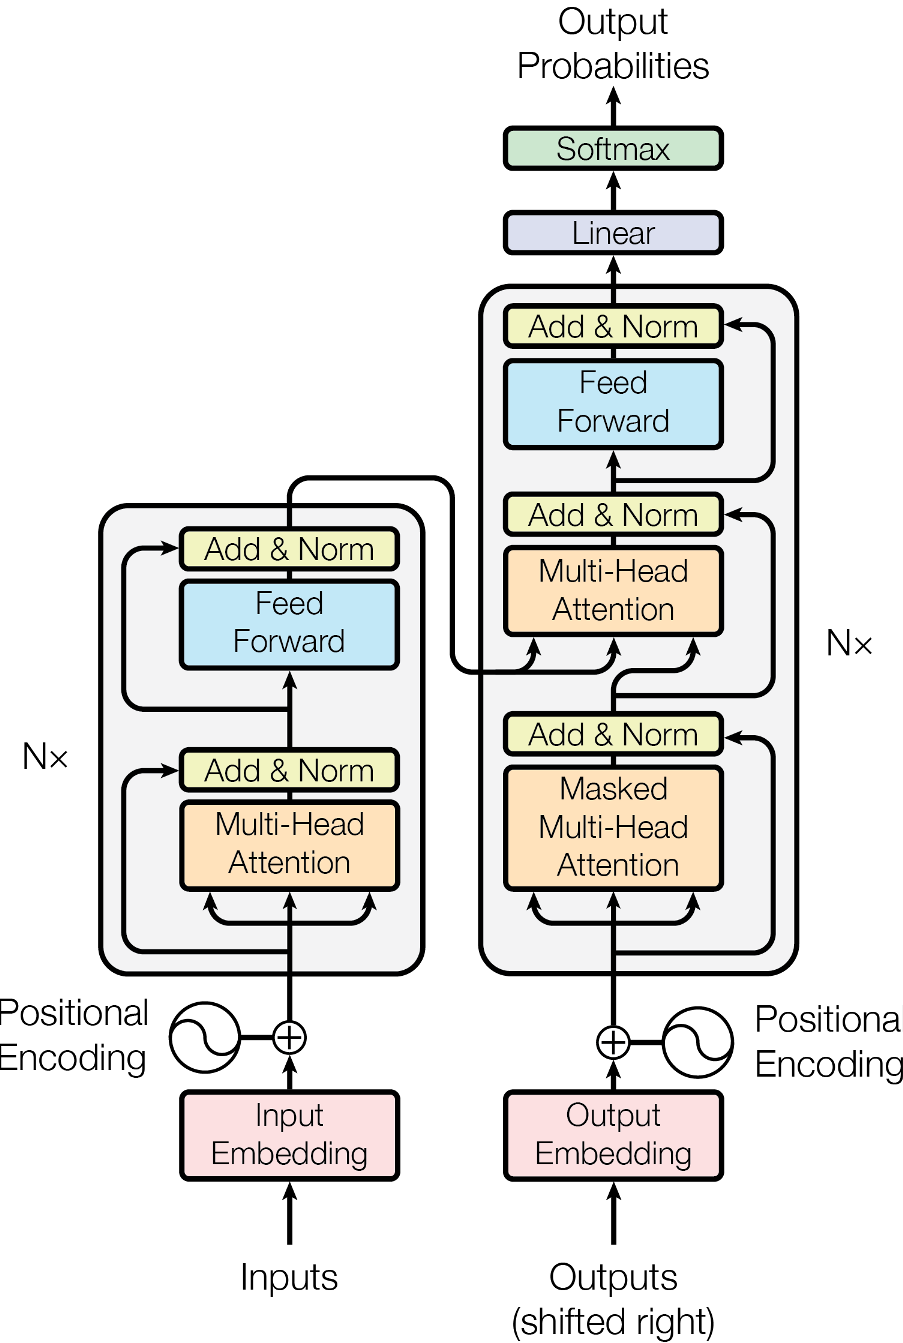 Figure 1: Transformer 经典的 Encoder-Decoder 结构
3. 位置编码 (Positional Encoding)
由于 Self-Attention 本质上是“词袋”模型(它不知道词的顺序),作者巧妙地利用正弦和余弦函数生成的 Positional Encoding 叠加在 Embedding 上,为模型注入了绝对和相对位置感。
实验与结果:降维打击
Transformer 在英德和英法翻译任务上的表现是统治性的。
- 翻译质量:Transformer (big) 在英德翻译上达到了 28.4 BLEU,比之前的 SOTA 提升了整整 2 个点。
- 计算成本:相比于当时的强力竞争者 ByteNet 或 GNMT,Transformer 的训练开销(FLOPs)降低了 1-2 个数量级。
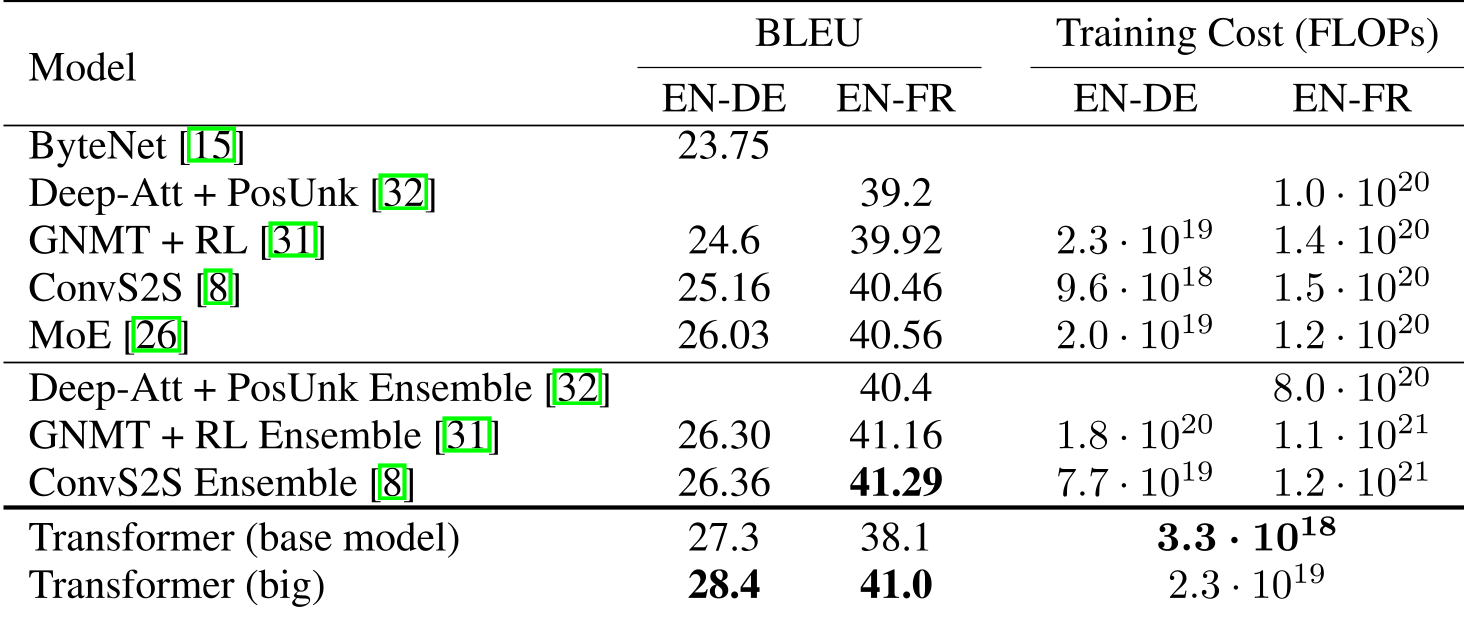 Table 2: 翻译性能与训练成本的对比,Transformer 在效率与精度上取得了双赢
深度洞察:为何它如此有效?
- 恒定的路径长度:在 Self-Attention 中,任意两个词之间的“距离”永远是 1。这使得学习长距离语法约束变得极其容易。
- 归纳偏置的释放:RNN 强行假设了信息必须按顺序流动。Transformer 减少了这种人为的约束,通过大数据量和 Multi-Head 结构,让模型自主学习词与词之间最真实的关联形态。
总结与展望
Takeaway:这篇论文的核心贡献不仅在于翻译,而在于它提供了一种可无限扩展的计算范式。
虽然 Transformer 也有其局限性——主要是注意力矩阵的 复杂度限制了超长文本(如整本书)的处理。但这并未妨碍它成为 AI 领域的“标准语言”。从 GPT 系列的爆发到多模态(Text-to-Video)的进化,我们至今仍生活在由这篇论文划定的技术疆界内。
注:代码已在 GitHub 开源 (tensorflow/tensor2tensor),这是后来的 Transformer 库及生态系统的基石。