
StreamingTalker:自回归扩散模型开启 3D 数字人实时流式对话新纪元
StreamingTalker: Audio-driven 3D Facial Animation with Autoregressive Diffusion Model
本文提出了 StreamingTalker,一种基于自回归扩散模型(Autoregressive Diffusion Model)的语音驱动 3D 脸部动画生成框架。该方法通过流式输出机制,实现了低延迟、且能处理任意长度音频的高质量 3D 口型与面部动作同步,达到了 SOTA 性能。
TL;DR
浙江大学等机构的研究者提出了 StreamingTalker,这是首个能够实现流式输出且低延迟的 3D 脸部动画扩散框架。它打破了传统扩散模型必须处理全局音频的限制,通过自回归(AR)策略,实现了首帧 25ms 的极速响应,并能稳定生成长达数分钟的高质量面部动作。
背景定位:扩散模型虽强,为何难做“实时”?
在语音驱动 3D 脸部动画领域,扩散模型(Diffusion Models)凭借其强大的生成多样性和逼真度已成为 SOTA。然而,现有的方案(如 FaceDiffuser, DiffSpeaker)大多采用“固定长度、全局去噪”的逻辑。
这种模式存在两个致命伤:
- 视野受限(Horizon Shift):模型在短序列上训练,面对长音频时,时序稳定性会迅速崩溃。
- 计算鸿沟(Latency BottleNeck):用户必须等待整段音频处理完毕才能看到第一帧动画。这对于实时交互(如数字人客服)来说是不可接受的。
核心直觉:自回归与轻量化扩散的联姻
StreamingTalker 的核心贡献在于将生成任务重构为:。即:利用过去 帧的历史动作和当前音频 ,预测当前帧 。
1. 模型架构解析
该框架主要由三个模块组成:
- VQ-VAE 潜空间编码:将高维的 3D 顶点坐标降维到紧凑的潜在表示(Latents),降低生成难度。
- AR 条件预测器:这是大脑。它利用带有因果掩码(Causal Mask)和 ALiBi 偏置的 Transformer 融合历史动作、音频编码(HuBERT)和说话人身份(Style)。
- 轻量级扩散头:这是一个单层 MLP。不同于笨重的 U-Net,这个 MLP 仅负责在被引导的条件下进行单帧去噪,极大地提升了速度。
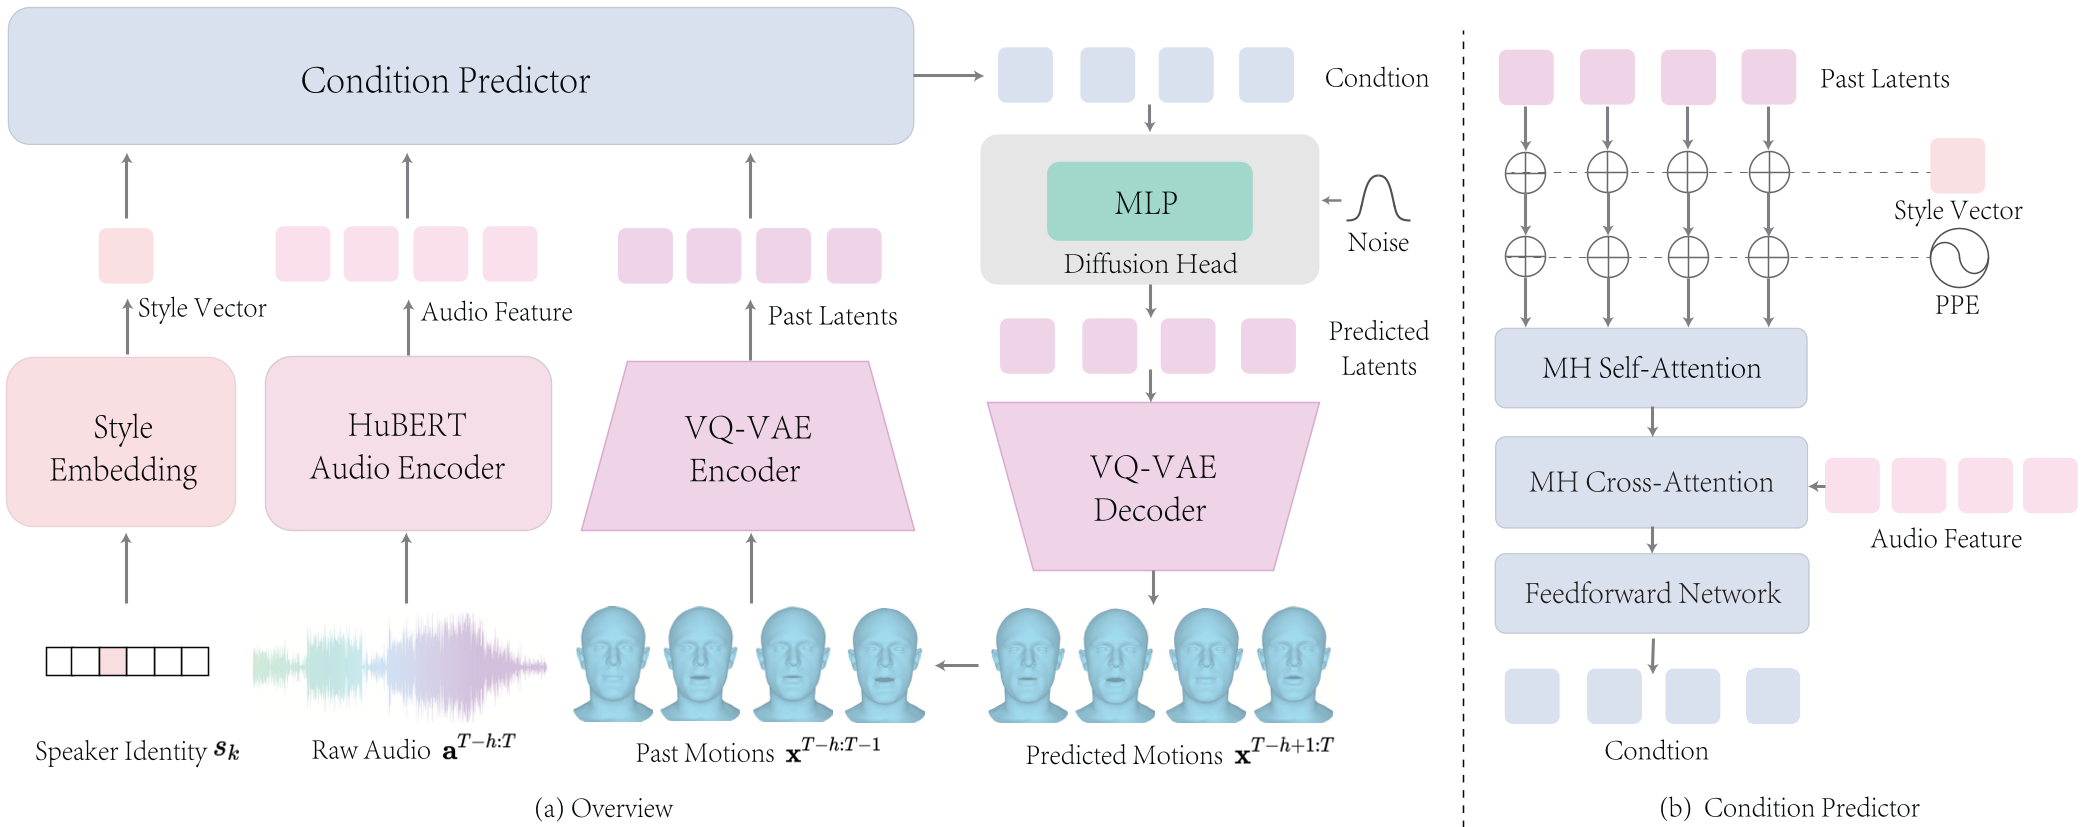 图 1:StreamingTalker 总体流水线:(a) 整体流程;(b) 条件预测器细节。
实验战果:打破“越长越崩”的魔咒
在 2000 帧(约 1 分钟)以上的长序列测试中,StreamingTalker 的表现远超前人。
定量指标
- 口型精度(LVE):在 BIWI 和 VOCASET 上均刷新了纪录。
- 推理延迟:对比全序列扩散方法,我们的方法在 27 秒音频下的首帧生成速度提升了数十倍(见下图)。
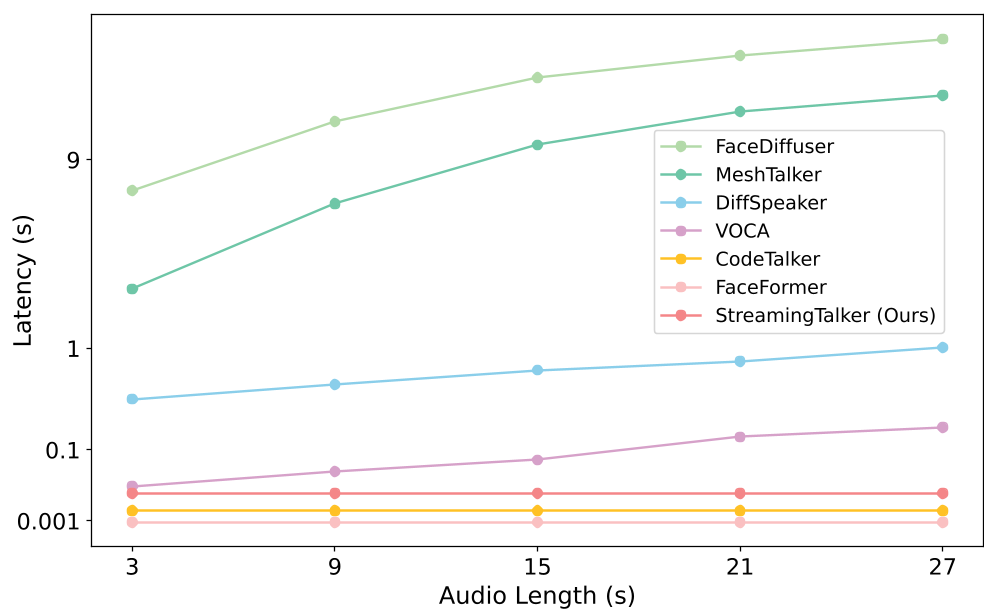 图 2:推理延迟随音频长度变化的对比图。可见 StreamingTalker(红线)保持了惊人的低延迟稳定性。
定性效果
实验显示,StreamingTalker 在处理“圆唇音”(如 /o/, /u/)和“双唇音”(如 /m/, /p/,需要完全闭嘴)时,其口型开合的准确度显著优于 DiffSpeaker 等基线。
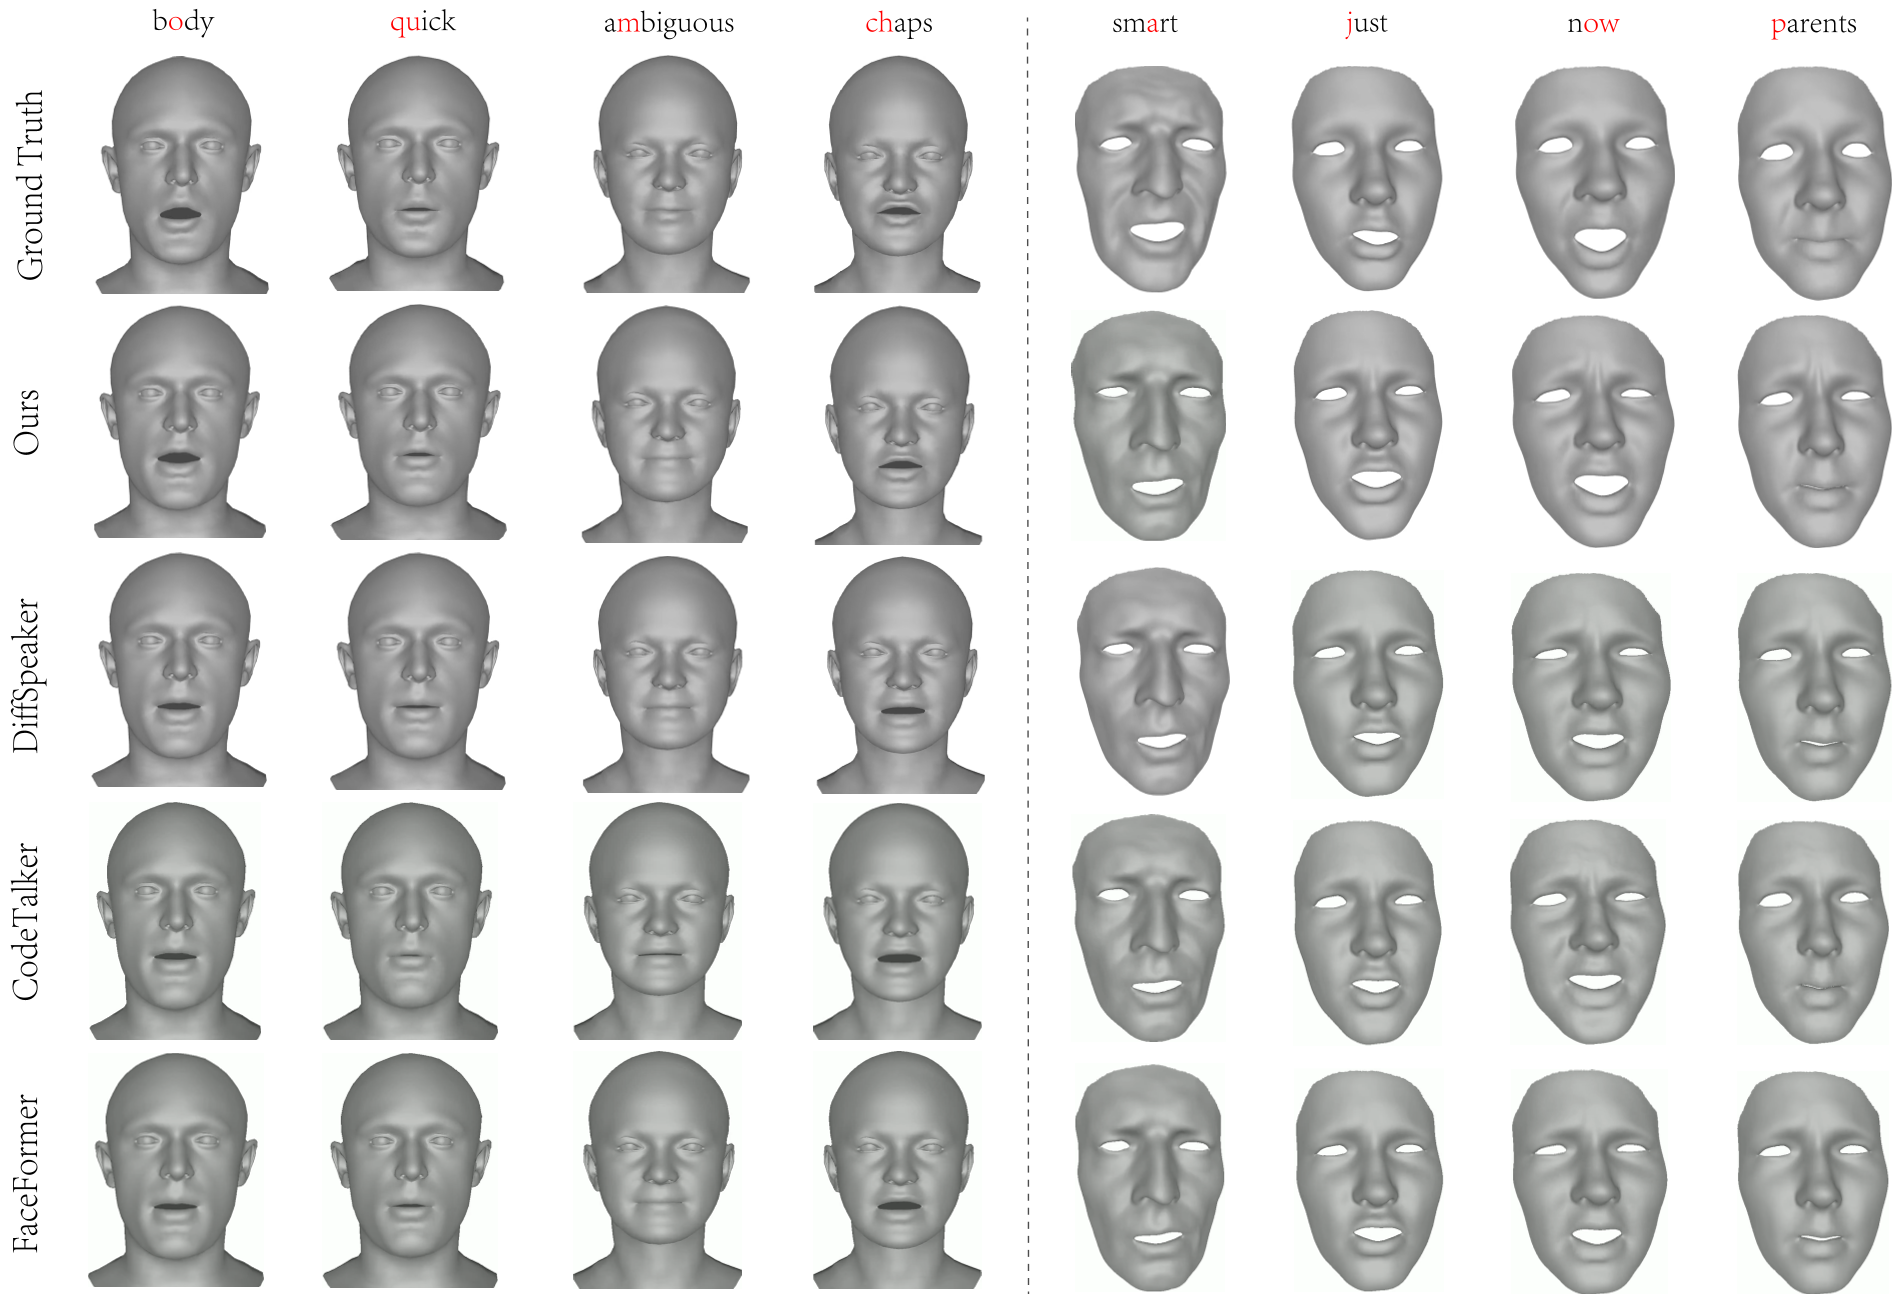 图 3:与 SOTA 方法的视觉对比,注意我们的方法在口型闭合处的精准度。
深度洞察:为什么这种设计有效?
- ALiBi 偏置的妙用:通过在 Transformer 中引入线性偏置,模型不再受限于训练时的固定序列长度,实现了“训练短、测试长”的强泛化性。
- MLP 替代 Transformer 扩散头:在潜空间中,单帧的生成逻辑相对简单。作者发现,只要条件引导足够强(通过前面的 AR 预测器),后端的去噪网络可以非常轻量,从而换取 40 FPS 的实时渲染性能。
局限与展望
尽管 StreamingTalker 在实时性上取得了突破,但作者也坦诚指出:
- 身份泛化(Identity Generalization):目前仍依赖训练集中的 Style Embedding,对于完全未见过的说话人,泛化能力仍有待提升。
- 情感维度(Emotions):目前的生成更多关注同步性,未来若能引入 EMOCA 等情感约束,动画将更有感染力。
总结
StreamingTalker 为 3D 脸部动画提供了一个完美的“工程+学术”平衡点。它告诉我们,在追求生成模型性能的同时,通过明智的自回归结构设计,完全可以克服扩散模型固有的计算成本障碍。