
智能体必须可审计:构建 LLM 系统的可问责性与取证基石
Auditable Agents
2026-01-01
总结
问题
方法
结果
要点
摘要
本文提出了针对大语言模型智能体(LLM Agents)的可审计性(Auditability)系统框架,主张将可审计性确立为智能体系统的一等公民(First-class)设计与评估指标。论文形式化定义了事后审计所必需的五大维度,并构建了跨越生命周期的“检测-执行-恢复”三层防御机制及标准化的 Auditability Card。
1. 核心速览 (Executive Summary)
- TL;DR:随着大语言模型智能体(LLM Agents)从“文本生成”迈向“工具调用、数据库修改、委派任务与产生物理/外部副作用”,单纯依赖事前安全对齐(Alignment)或被动拦截已不足以保障系统安全性。本文确立了可审计性(Auditability)作为智能体系统一等设计准则的地位,形式化提出了由动作可恢复性、生命周期覆盖、策略可检查性、责任归属与证据完整性构成的五维审计框架,并结合跨越“事前检测(Detect)、事中执行(Enforce)、事后恢复(Recover)”的三层机制,论证了构建可防御、可问责智能体系统的技术路径。
- 背景定位:这是一篇极具前瞻性的系统级立场与范式确立论文(Systems Position Paper)。它将传统软件工程的密码学防篡改日志、安全取证与大模型多智能体交互深度融合,填补了智能体在产生外部副作用后“无法定责、无法复盘”的理论与工程空白。
2. 痛点与动机 (Problem & Motivation)
2.1 智能体安全不再只是“内容对齐问题”
在传统的 LLM 交互中,有害输出通常局限于文本内容违规;但当智能体拥有文件删除、API 调用、邮件发送与权限穿透能力时,其故障本质上是系统级故障(System Problems)。
假设一个部署在企业环境中的智能体查询了客户敏感数据并对外发送了一封泄密邮件。在当下的智能体架构中,安全审计员面临着三个无法给出可信回答的根本问题:
- 发生了什么(What happened)? 当前日志往往缺少关键的输入输出字段或工具调用参数。
- 系统是否合规(Did it comply with policy)? 重试路径、异常回退(Fallbacks)、人工审批流往往未被结构化记录,策略判定因字段缺失而变为不可判定()。
- 责任属于谁(Who was responsible)? 在多智能体协同或动态技能加载(Dynamic Skills)链条中,跨边界调用的因果链断裂。
2.2 核心洞察:问责制的前提是可审计性
作者清晰界定了三个层级概念:
- 问责制(Accountability - 目标):审计员判定系统是否合规并针对违规明确划分责任的能力。
- 可审计性(Auditability - 赋能系统属性):系统生成、保存并暴露足量且可信证据的内在能力。
- 审计(Auditing - 过程):基于可信证据进行行为重构、策略检查与定责的操作过程。
核心命题:没有可审计性,任何智能体系统都无法实现真正的问责制。
3. 方法论详解 (Methodology - The Core)
3.1 审计裁决与五维形式化框架
一次合法且可防御的审计必须产出如下形式的审计裁决(Audit Verdict)元组:
u_{ ext{Policy Check.}}, r_{ ext{Attribution}}, \sigma_{ ext{Integrity}} \big)$$ 每个分量对应一个不可或缺的系统属性条件(缺失任一分量都会导致裁决失效): 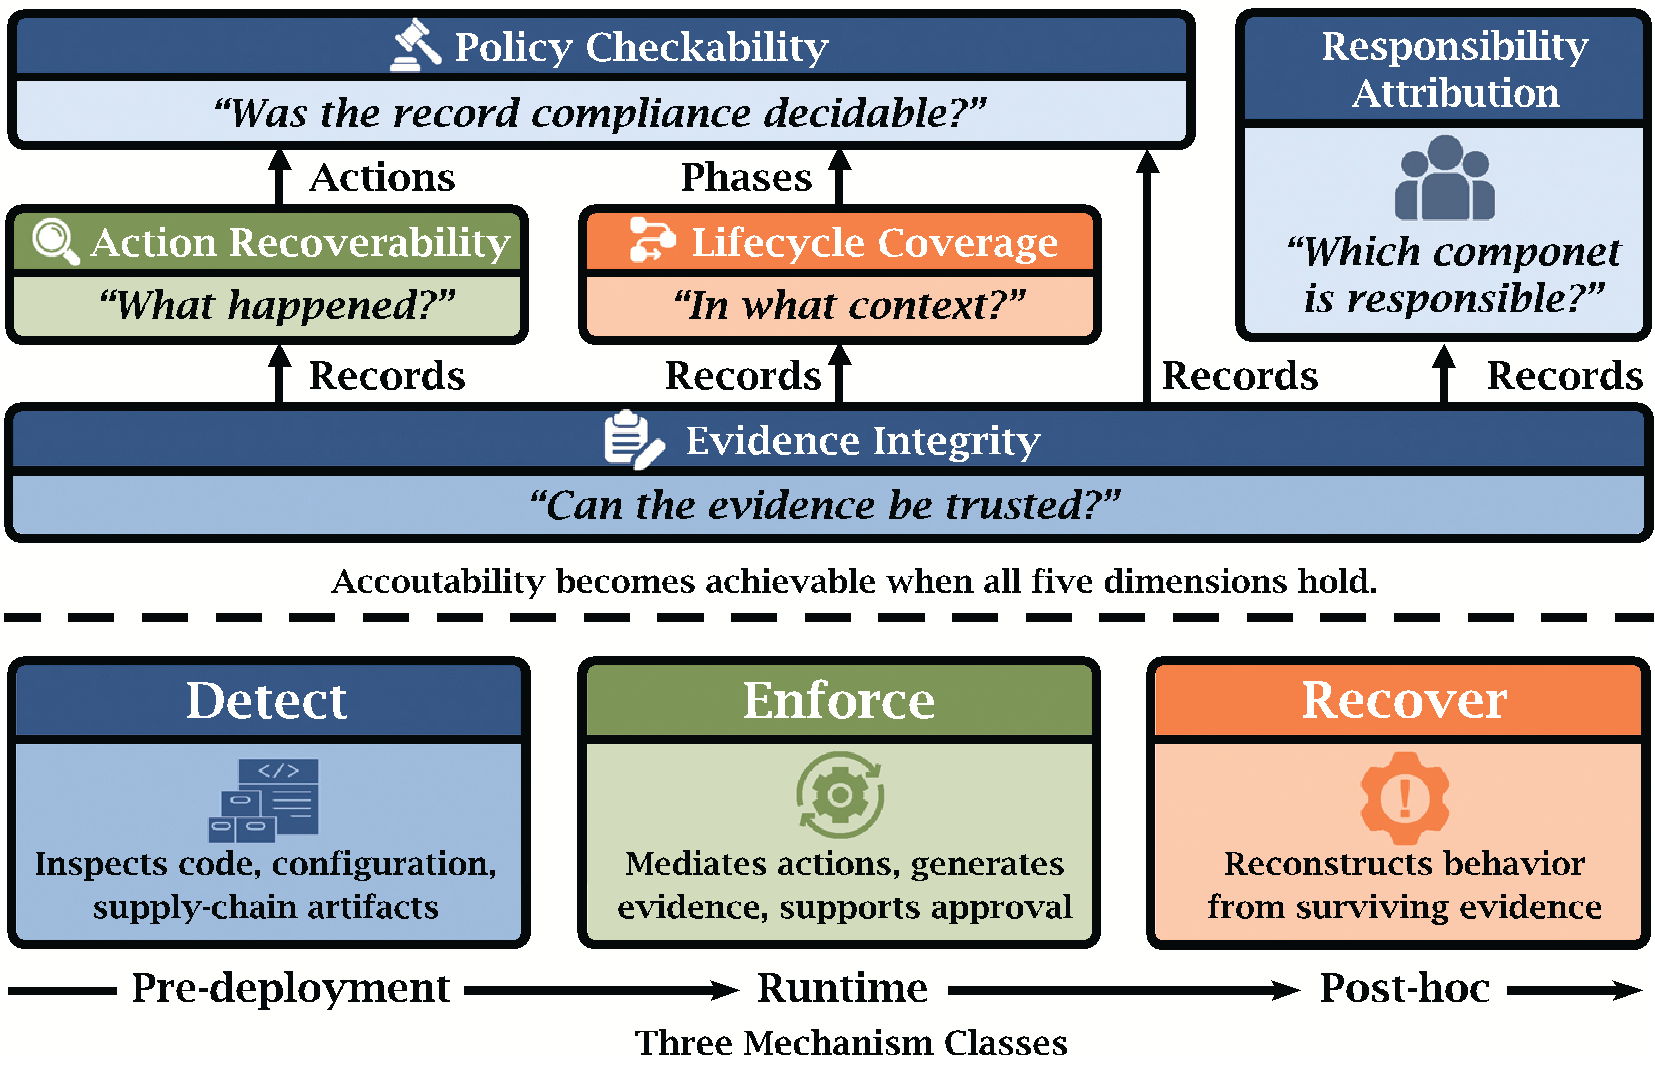 1. **动作可恢复性 (Action Recoverability, $s$)**:不仅要求动作被记录(Action Coverage Rate, $ ext{ACR}$),更要求记录具备足够的重构保真度(Record Fidelity, $ ext{RF}$),必须保留工具入参、返回值与关键上下文。 2. **生命周期覆盖 (Lifecycle Coverage, $c$)**:覆盖从重试、降级、人工审批到多智能体委派的完整执行阶段(Lifecycle Phase Coverage, $ ext{LPC}$),最小化未观测执行结构产生的差距负担(Gap Burden, $ ext{GB}$)。 3. **策略可检查性 (Policy Checkability, $ u$)**:日志 Schema 必须支持机器对结构化策略(如“调用敏感工具 X 前必须有人工批准”)进行明确判定(Structural Policy Decidability Rate, $ ext{SPDR}$)。 * **命题 1 (Schema 决定策略可判定性)**:若结构化策略 $\pi$ 所需的关键字段集 $F_\pi$ 中存在某个字段 $f$ 未被任何记录条目所捕获,则该策略在审计记录上的评估直接退化为不可判定 $\pi(\mathcal{L}) = \bot$。 4. **责任归属 (Responsibility Attribution, $r$)**:针对复杂的委派链路(User $ o$ Agent A $ o$ Agent B $ o$ Skill $ o$ Tool),系统需具备完整的因果归因链覆盖(Attribution Completeness, $ ext{AC}$)与链路深度还原能力($ ext{ACD}$),或在网状交互中恢复拓扑子图。 5. **证据完整性 (Evidence Integrity, $\sigma$)**:底层基石属性。确立从 Level 0(无保护)到 Level 3(Ed25519 签名 + SHA-256 哈希链)的防篡改强度(Integrity Strength, $ ext{IS}$),确保事后审计的记录未被静默篡改。 --- ### 3.2 机制时空不对称性:为什么单一手段注定失败? 系统在不同生命周期阶段面临信息可见性与干预能力的**时空不对称性(Information-and-Intervention Asymmetry)**: 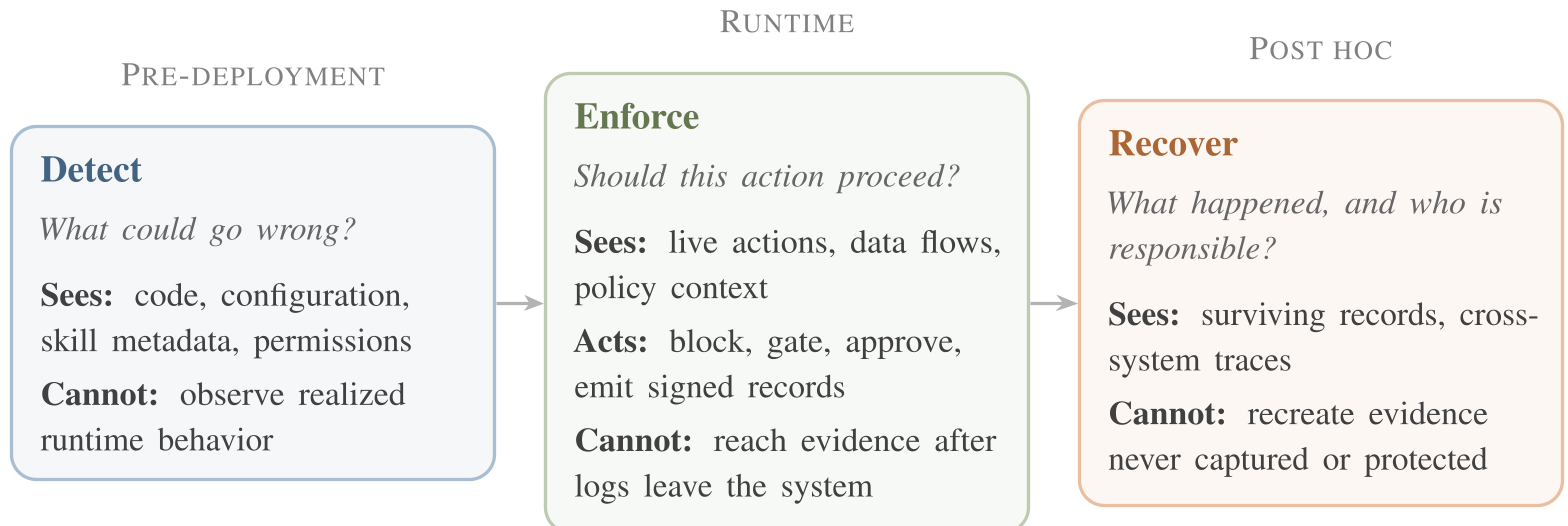 * **事前检测 (Detect - 静态分析)**:可检查代码与供应链配置(如 MCP 配置、凭证泄露风险),发现潜在审计盲区,但无法验证动态运行时行为。 * **事中执行 (Enforce - 运行时中介拦截)**:在动作产生外部副作用前进行阻断、鉴权并直接发射结构化的防篡改签名日志,但在捕获上游长委派链时存在边界限制。 * **事后恢复 (Recover - 证据重构与取证)**:当跨多组织协同、日志元数据被剥离或部分丢失时,基于残留输出逆向恢复交互拓扑与责任归属,但无法凭空凭造未记录的字段,亦无法追溯未签名时期的篡改。 --- ## 4. 实验与实条验证 (Experiments & Results) 论文放弃了单一基准刷榜的传统思路,采用分层的三重证据链(Layered Evidence)对上述体系进行实证支撑: ### 4.1 生态下界:开源智能体默认“审计失明” 利用静态分析工具 `agent-audit` 对 6 个代表性开源智能体项目(OpenHands, SWE-agent, Gorilla, Generative Agents, MLAgentBench, CodeAct)进行扫描: * 共发现 **617 个安全缺陷**,其中 **44% (269 个) 为严重(Critical)级别**。 * **工具滥用(Tool Misuse)占 64%**:大量工具直接接受 LLM 未校验的入参执行命令,缺乏基本边界检查与审计插桩,直接证实开源生态在现状下甚至无法满足可审计性的安全前置条件。 ### 4.2 运行时可行性:防篡改控制点兼具低延迟与高防御 基于前置执行防火墙 `Aegis` 在 14 种智能体框架上进行运行时拦截与签名验证测试: * **安全性与准确率**:在 48 种典型攻击中实现了 **100% (48/48) 拦截**,在 500 次正常工具调用中误报率仅为 **1.2%**。 * **工程延迟**:中位数拦截与签名开销仅为 **8.3 ms**(P95 为 14.7 ms,P99 为 23.1 ms),相对于 LLM 秒级推理延迟几乎可忽略不计,证明生成 Level 3 级哈希链防篡改记录具备工程落地可行性。 ### 4.3 恢复前沿:日志丢失下的隐式追踪(IET) 针对日志元数据被完全剥离的极端场景,采用隐式执行追踪技术(Implicit Execution Tracing, IET)在模型生成时嵌入特定密钥水印: 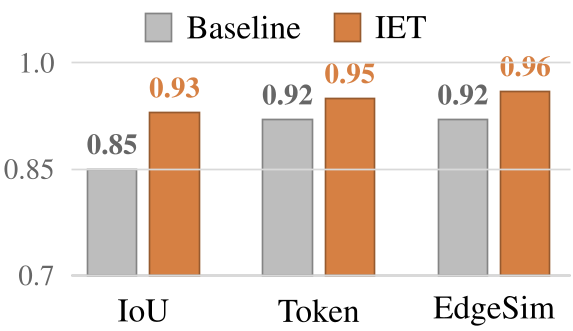 * 在多智能体拓扑(Chain、Star、Tree)下,IET 取得了约 **0.95 的 Token 归属准确率**与 **0.93 的动作片段重合度(IoU)**。 * 即使在身份元数据被完全剥离(Identity Removal)的极端恶化条件下,基线方法归因能力崩塌归零,IET 依然保留了关键的拓扑恢复能力(EdgeSim 接近 0.96)。 --- ## 5. 深度洞察与标准化倡议 (Critical Analysis & Conclusion) ### 5.1 辩驳四种替代观点 1. **“现有 Observability(可观测性)已足够”**:监控仪表盘回答的是“系统当前指标如何”,缺乏密码学证据完整性与完整的委派归因链,无法作为法务与合规级审计证据。 2. **“运行时拦截(Enforce)比事后审计更重要”**:拦截只能降低实时风险,但被拦截的行为需要解释,被放行的行为需要存证追溯,审批放行需要责任背书。 3. **“更强的安全对齐(Alignment)能替代审计”**:智能体危害多源自动态工具集成、权限过度授予与外部环境交互,这些属于系统部署态属性,纯模型对齐无法解决系统层面的授权漂移。 4. **“完整审计会导致隐私与性能开销过大”**:选择性记录、基于哈希承诺的摘要脱敏以及元数据精简技术可在控制成本的同时满足法定合规要求。 ### 5.2 落地规范:智能体审计卡 (Auditability Card) 论文倡议未来所有智能体发布、基准测试与框架均应随附 **Auditability Card**,强制披露以下 6 个核心问题: * **Q1 (Actions)**: 记录了哪些策略相关的动作及入参保真度? * **Q2 (Phases)**: 是否捕获重试、降级、等待审批等生命周期状态? * **Q3 (Policies)**: 记录支持哪些结构化策略的机械化判定? * **Q4 (Attribution)**: 提供了何种程度的跨智能体/技能责任链? * **Q5 (Integrity)**: 日志采用何种防篡改与签名保护级别? * **Q6 (Missing Logs)**: 当常规日志缺失或被剥离时,系统具备怎样的后验恢复能力? ### 5.3 局限性与未来展望 * **语义策略判定的边界**:当前形式化框架主要支持结构化可检查策略,对于“不得泄露客户身份”等高度依赖语义上下文的复杂策略,如何在不极度膨胀日志 Schema 的前提下实现低成本判定仍是开放问题(OP4)。 * **对抗环境下的恢复下界**:当恶意攻击者蓄意破坏生成水印或混淆因果链时,隐式追踪的信息论恢复极限仍待进一步探索(OP5)。 **结语**:可审计性不是强加于智能体研发的额外税负,而是智能体迈向高价值、高风险现实场景不可或缺的信任基座。