
Auto-ARGUE:让大模型成为严谨的专业报告“审核员”
Auto-ARGUE: LLM-Based Report Generation Evaluation
本文推出了 Auto-ARGUE,这是针对 RAG 报告生成任务(Report Generation)的第一个开源自动化评估工具。它基于 LLM-as-a-judge 范式实现了 ARGUE 框架,通过对句子级的事实覆盖(Nuggets)和引用准确性进行二进制判断,在 TREC 2024 等多个榜单上达到了与人类专家高度一致的评估效果。
TL;DR
在检索增强生成(RAG)领域,写出一篇像样的“调研报告”比回答一个简单问题难得多。Auto-ARGUE 应运而生,它是首个针对报告生成任务设计的开源 LLM 自动化评估工具。它不仅能检查报告是否涵盖了关键知识点(Nuggets),还能像严厉的导师一样审视每一处引用(Citation)是否张冠李戴。实验证明,其评价标准与人类专家高度契合。
背景定位:为什么报告生成评估这么难?
目前的 RAG 评估工具(如 RAGAS, ARES)多聚焦于问答的准确性,但报告生成有两大特质:
- 用户导向性:同样的查询,给专家看的报告和给学生看的报告应当完全不同。
- 全量覆盖要求:QA 只要答对就行,而报告要求覆盖语料库中所有关键信息。
此前虽然有 ARGUE 理论框架,但一直缺乏一个自动化的实现,导致研究者只能依赖昂贵且缓慢的人工评估。
核心动机:从“感性评分”到“理性逻辑树”
作者认为,评估一份报告不能只给一个总分,而应该像法官断案一样,有一套清晰的证据链逻辑。
Auto-ARGUE 的评估逻辑
Auto-ARGUE 将复杂的评估拆解成了一棵二进制决策树。对于报告中的每一个句子,它都会追问:
- 这句话是空话还是包含事实?
- 如果是事实,它是否对应了已知的一个关键知识点(Nugget)?
- 如果有引用,引用的文献是否真的支持这句话?
- 如果没有引用,它是否重复了前面的废话(若是则免罚,若提供了新信息则重罚)?
方法论详解:架构与优化
Auto-ARGUE 的核心是一个基于 Few-shot Prompt 的 LLM 评委(实验中使用 Llama-3.3 70B)。
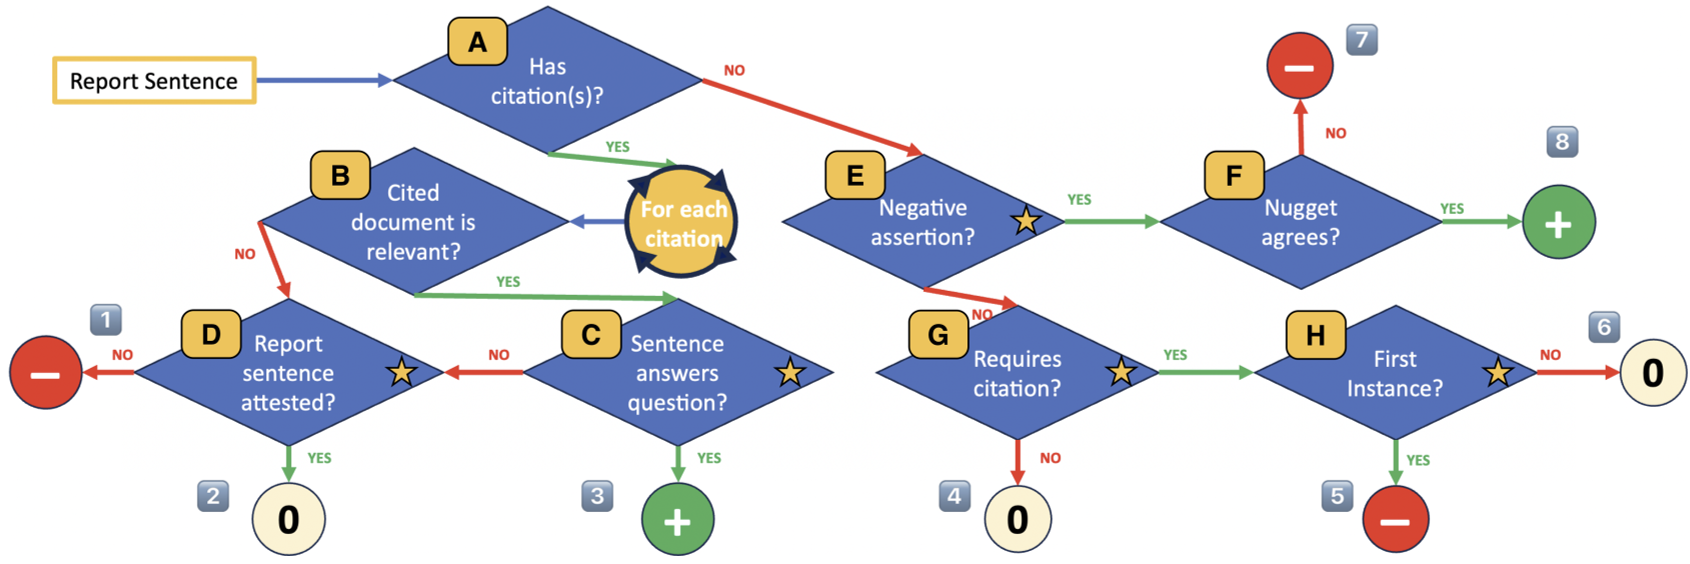 图 1:Auto-ARGUE 的判断逻辑决策树。蓝色代表 LLM 判断,绿色代表奖励,红色代表惩罚。
工程优化: 在大规模评估中,如果每个句子都去对比所有知识点,LLM 的调用量会爆炸。作者引入了两个关键优化:
- 映射查找:预先建立“文档-知识点”映射。如果句子引用的文档本身就不含某知识点,直接跳过 LLM 检测。
- 句子级原子化:因为一个句子可能指向多个文献,Auto-ARGUE 将检测函数化,确保相同的句子和知识点对只被检查一次,大幅降低了推理成本。
实验与结果:它真的懂行吗?
为了验证 Auto-ARGUE 的可靠性,作者在 TREC 2024 的两个赛道进行了背靠背测试。
1. 与人类专家的一致性 (NeuCLIR 2024)
实验对比了机器评分与人类评分的排名相关性。
- 结论:在“句子精确度(Sentence Precision)”上,机器与人类表现出极高的一致性;在“知识点召回率(Nugget Recall)”上,虽然存在跨语言差异,但整体趋势非常稳健。
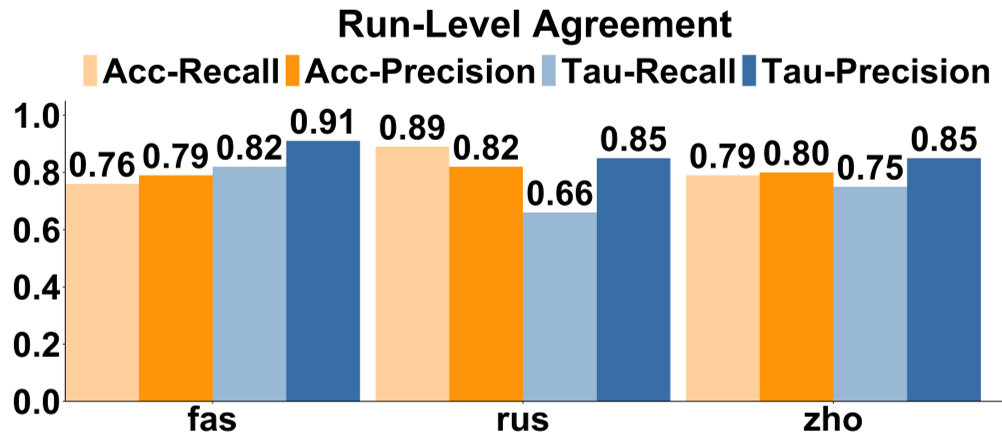 图 2:Auto-ARGUE 与人类评分的相关性分析,深色柱状图显示了极高的排名吻合度。
2. 多工具横向对比 (TREC RAG 2024)
将 Auto-ARGUE 与另一款自动化工具 AutoNuggetizer 相比,两者在不同任务(AG 和 RAG)下的 Spearman 相关系数均在 0.81 以上。这意味着 Auto-ARGUE 的评估结果具有极强的通用性和说服力。
深度洞察:ARGUE-viz 可视化工具
除了评分,作者还发布了 ARGUE-viz(基于 Streamlit)。它像一个“错题本”,能清晰地展示出哪些关键点被漏掉了,哪些句子虽然写了但引用是错的。这对于 RAG 系统的开发者进行 Error Analysis 具有极高的实战价值。
总结与局限
Takeaway:Auto-ARGUE 的开源标志着 RAG 评估从“模糊的语义匹配”进化到了“结构化的逻辑审计”。它的可配置性允许研究者针对不同行业(医疗、法律等)插入不同的 Nugget 集合。
局限性:
- 目前仍高度依赖于 Llama-3 70B 等高性能模型,成本虽然优化了但依然存在。
- 对于“负面声明(Asserting Ignorance)”的评估仍处于早期阶段,这也是未来长文本 RAG 研究的一个重要方向。
本文由资深学术技术主编重构。如需深入研究,请参考原论文《Auto-ARGUE: LLM-Based Report Generation Evaluation》。