
[CHI 2025] Auto-Slides:让 AI 像导师一样为你拆解学术论文
Auto-slides: An interactive multi-agent system for creating and customizing research presentations
本文推出了 Auto-Slides,这是一个驱动大语言模型(LLM)的多智能体系统,旨在将复杂的学术论文自动转化为具有教学逻辑、多模态(包含图表和公式)且可交互定制的演示文稿(Slides)。该系统在 Llama、GPT-4o 等模型基础上,通过多代理协作实现了从论文解析到课件生成的全流程自动化。
TL;DR
面对动辄几十页、公式如麻的学术论文,仅仅靠 ChatGPT 的简短摘要已经不够了。来自西湖大学等机构的研究团队开发了 Auto-Slides,这是一个能将 PDF 论文直接变成专业 PPT(Beamer)的多代理系统。它不仅能精准提取图表和公式,还能根据认知心理学把论文的“死知识”重构成易于理解的教学叙事,并支持你通过对话随时修改和扩充。
背景定位:从“读论文”到“看课件”的升维
在目前的 AI 阅读辅助领域,用户大多处于“碎片化提问”的状态。虽然能解决局部疑问,但很难建立对论文整体贡献和方法论的系统性认知。Auto-Slides 的出现,标志着学术辅助工具从简单的文本提取反馈转向了教学逻辑重构。它在学术坐标系中属于“人机交互(HCI)与智能代理(Agents)”的交叉创新。
痛点深挖:为什么 AI 摘要总是差一点意思?
- 结构错位:论文遵循的是 IMRaD(引言、方法、结果、讨论)这种严谨的记录格式,但这种格式并不适合教学。直接把摘要填进 PPT 会导致逻辑晦涩。
- 模态丢失:论文的核心往往在表格、公式和架构图中。普通的 PDF 解析器会把这些数据搞丢或变成乱码。
- 静态局限:生成的 PPT 往往是“一次性”的,如果用户想深入了解某个被引用的背景知识,现有的系统往往无能为力。
核心方法论:多代理协作的“炼金术”
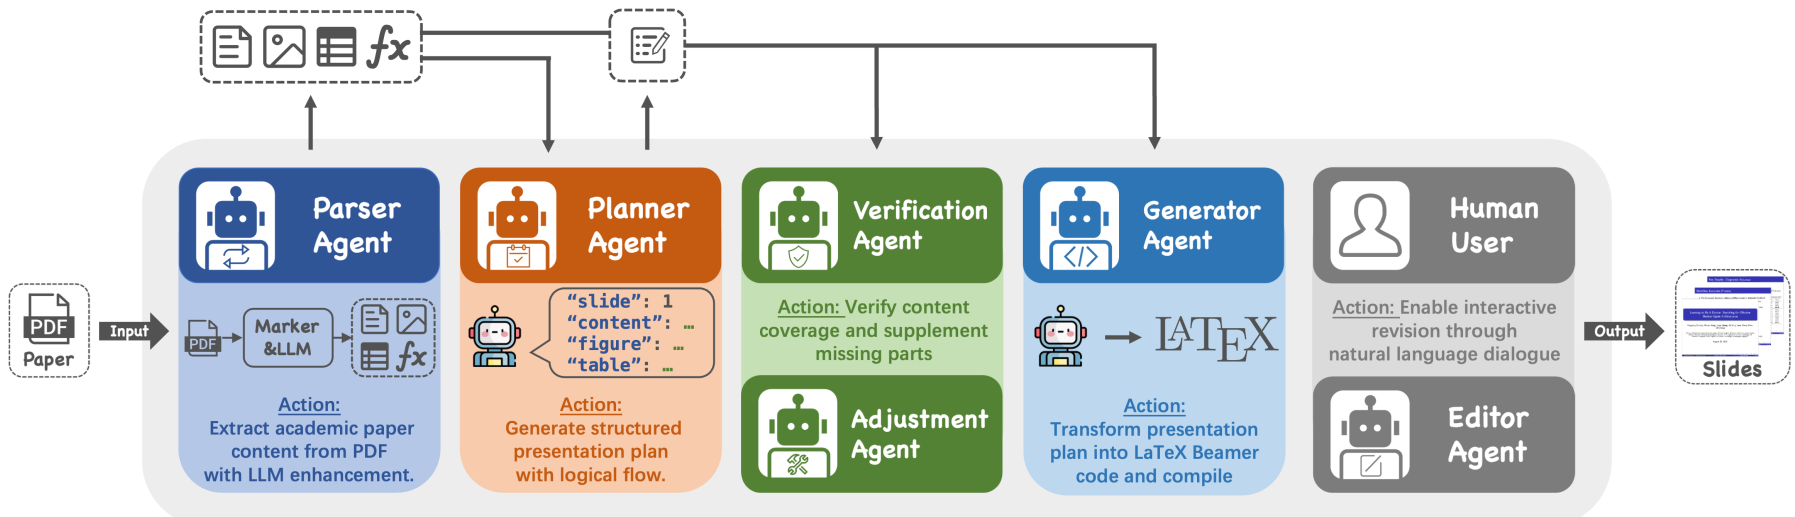
Auto-Slides 并不是一个单一的 Prompt,而是由多个专门的 Agent 组成的生产线。
1. 高保真解析 (High-Fidelity Parsing)
系统第一步使用 Marker 模型将 PDF 转为 Markdown,随后由专门的 Parser Agent 识别其中的数学环境和表格语法。这意味着生成的 Slide 中,公式是用原生 LaTeX 渲染的,数据则是精准的表格,而非模糊的截图。
2. PMRC 叙事规划
作者引入了由认知负荷理论(CLT)驱动的 Planner Agent。它将传统的 IMRaD 结构改写为 PMRC(Problem–Motivation–Results–Conclusion)。这种逻辑更符合人类接受新知识的路径:先看痛点(Problem)和动机(Motivation),再看战绩(Results),最后总结。
3. “验证-调整”闭环
为了防止 LLM 产生幻觉或遗漏关键创新点,系统设有一个 Verification Agent。它会反复拿生成的 Slide 计划与原文进行比对,只有通过验证的内容才会进入最后的渲染环节。
4. 强大的交互编辑器
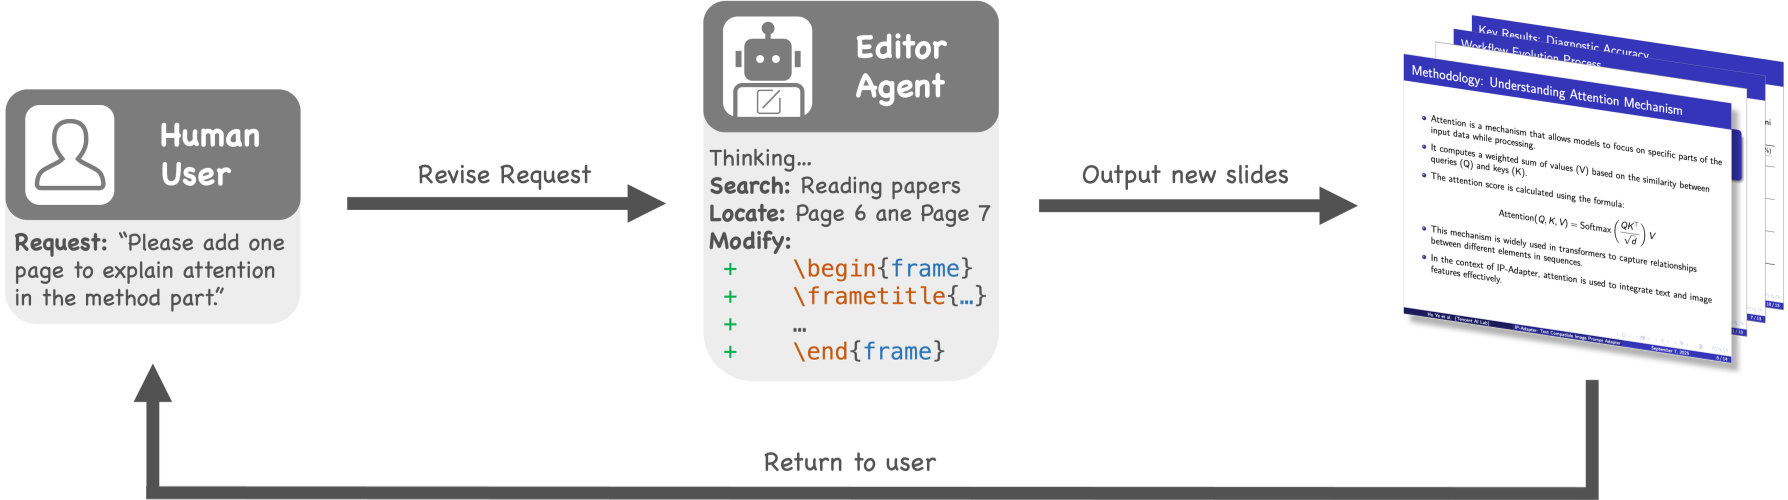
这是 Auto-Slides 的杀手锏。如果你觉得某个算法步奏讲得太深,或者想多了解某篇参考文献,你可以直接说:“帮我加一页讲讲这里的 Attention 机制”。Editor Agent 会出发名为 search 的工具,实时去 arXiv 或 Semantic Scholar 抓取外部文献并集成到当前的 Slide 中。
实验战绩:全方位的卓越性能
在多项用户研究和自动化测试中,Auto-Slides 表现强劲:
- 表格与公式保真度:相比不带信息提取优化(w/o InfoExt)的版本,其在复杂结构数据的准确性上提升了 67.9%。
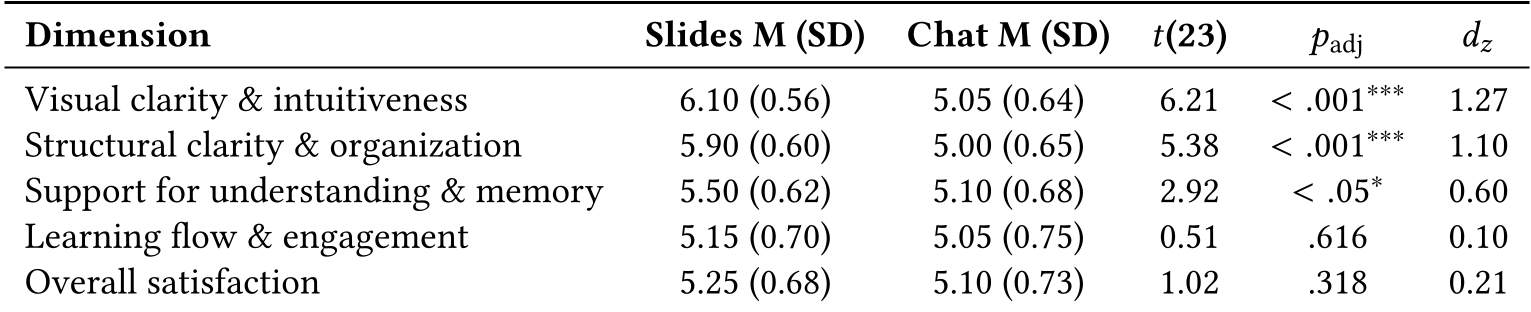
- 学习体验提升:用户普遍认为 Slide 格式比 LLM Chat 界面更清晰、更易于记忆。
- 专家认可度:计算机领域的专家评价,经过 PMRC 优化的 Slide 在叙事流(Narrative Flow)上显著优于保留原始论文顺序的版本。
深度洞察与总结
Auto-Slides 的核心启示在于:AI 时代的阅读不仅仅是“压缩信息”,更是“重组逻辑”。
局限性:
- 目前仅支持 PDF 中的静态内容,对于论文中附带的视频、可执行代码块等动态媒体尚未覆盖。
- LaTeX 生成虽专业,但对非技术用户来说,直接进行视觉上的“拖拉拽”编辑(类似 PowerPoint)会更加友好。
未来展望:
随着多模态大模型的进化,未来的 Auto-Slides 或许能自动为每一张 Slide 生成对应的讲解视频,或者通过分析用户的知识背景(Knowledge Graph),实时生成千人千面的“个性化论文导读课件”。
对于学术圈和教育行业来说,这不仅是生产力的解放,更是传播方式的革命。