
AutoEval Done Right:用统计学为 AI 自动评估正名
AutoEval Done Right: Using Synthetic Data for Model Evaluation
本文提出了 AutoEval,一种基于预测增强推理 (PPI) 的统计框架,通过结合少量人工标注数据和大量 AI 生成的合成数据进行模型评估。该方法涵盖了准确率、回归指标及 Bradley-Terry 对齐排名,在保证无偏性的同时显著提升了样本效率。
TL;DR
在模型评估成本日益高昂的今天,加州大学伯克利分校的研究团队提出了一套名为 AutoEval 的算法框架。它通过“偏差修正”的数学手段,让廉价的 AI 自动评分(如 GPT-4 评分)能够产生与人类专家标注同等严谨的结果。实验表明,该方法在减少 50% 人工标注量的情况下,依然能保持评估的无偏性与极高的排名准确度。
背景:AI 自动评分的“信任危机”
工业界和学术界目前面临共同的痛点:
- 人工标注贵:Chatbot Arena 等排名需要数十万次人类对比。
- 自动评分偏:直接用 GPT-4 评估其他模型(LLM-as-a-Judge)虽然快,但存在位置偏见、长度偏见等系统性误差。
- 统计不可靠:简单的平均分无法给出“两个模型之间是否有显著差异”的置信区间。
AutoEval 的定位是:不仅要用 AI 做评估,还要用统计学方法把 AI 制造的偏差“修正”回来。
核心方法:PPI++ 的物理直觉
AutoEval 的核心工具是 Prediction-Powered Inference (PPI) 的进化版。其核心公式可以简化理解为:
架构解析
当我们要评估一个模型的准确率、回归误差或 BT 排名系数(Bradley-Terry coefficients)时,AutoEval 执行以下步骤:
- 冷启动:在少量(如 200 条)人工标注数据上,同时运行人工评价和 AI 评价,计算两者之间的“差值”(偏差信号)。
- 大规模泛化:在海量(如 1.6 万条)未标注数据上运行 AI 评价。
- 加权修正:引入一个折扣因子 (通过最小化方差自动优化),将大规模 AI 评价结果与小规模偏差信号融合。
 上图展示了在 ImageNet 任务中,PPI 家族方法在不同标注量下均能保持比经典方法更低的均方误差。
实验实战:从 CV 准确率到 LLM 排名
1. 蛋白质序列评估
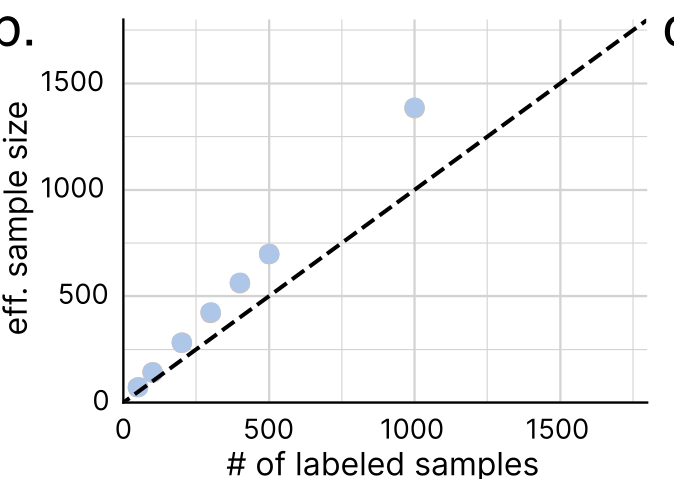
在评估蛋白质适应度预测模型时,实验数据(Wet-lab)极端匮乏。AutoEval 使用 VESPA 模型作为“二等评价员”。结果显示,哪怕评价员模型本身很弱,PPI++ 也能通过自适应调整 ,使得有效样本量(ESS)提升 50%。
2. Chatbot Arena 竞技场
在 LLM 对战排名中,研究者使用 GPT-4o-mini 作为裁判。如下图所示,随着人工标注数量 的增加,AutoEval(PPI++)生成的排名与真实排名的相关性(Correlation)迅速提升,显著优于仅使用人工数据的经典方法。
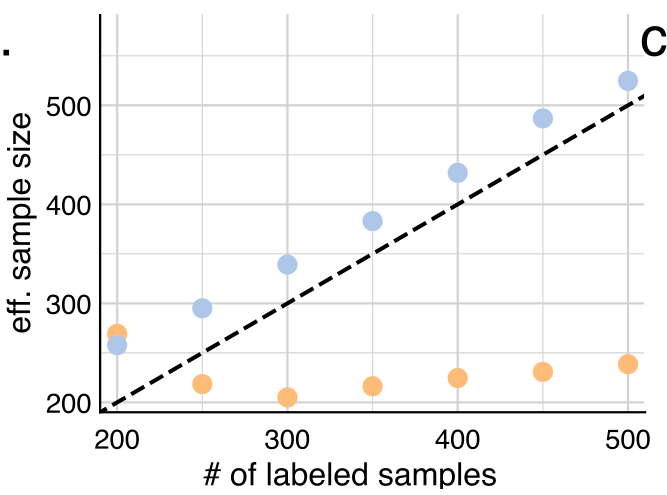 图中 (c) 展示了相对于真实排名的相关性,PPI++ 展现出了压倒性的优势。
深度洞察:为什么 AutoEval 是“Done Right”?
- 鲁棒性(Safety Net):如果 AI 评价员完全是乱猜的, 会趋向于 0,框架自动退化为传统的人工评估,不会比原来的结果更差。
- 置信区间(Confidence Intervals):该方法不仅给出一个数值,还能给出一个渐近有效的置信区间(CI)。这意味着我们可以自信地说:“模型 A 确实比模型 B 强”,而不是在统计误差内徘徊。
- 处理偏差(Covariate Shift):论文还特别讨论了当人工数据与实际生产数据分布不一致(偏移)时,如何通过重采样(Importance Sampling)进行校准,这使其具备了工业落地价值。
总结与局限
未来工作:目前的 AutoEval 假设人工评价是“标准参考”,但现实中人类专家也会犯错。如何将“带噪声的人类标注”与“有偏见的 AI 标注”结合,将是下一个前沿课题。
结论:对于正在构建模型监控(Monitoring)或评估流水线的架构师来说,AutoEval 提供了一个现成的 Python 工具包(ppi_py),用数学严谨性换取了数以万美元计的标注费用节省。