
AutoMoT:打破实时性枷锁,异步混合专家架构重塑统一自动驾驶模型
AutoMoT: A Unified Vision-Language-Action Model with Asynchronous Mixture-of-Transformers for End-to-End Autonomous Driving
本文提出了 AutoMoT,一种统一了场景推理与动作生成的端到端自动驾驶框架。该框架采用异步混合 Transformer (MoT) 架构,通过层级联合注意力共享机制,在保持预训练视觉语言模型 (VLM) 通用推理能力的同时,实现了 SOTA 级的驾驶性能。
TL;DR
传统的自动驾驶系统往往在“强大的语义理解”与“极速的实时响应”之间徘徊。本文提出的 AutoMoT 通过一种巧妙的 异步混合 Transformer (MoT) 架构,将冻结的 VLM 理解专家与高频的动作专家相结合。它不仅保持了 VLM 应对长尾场景的通用智慧,更通过 KV Caching 实现了高达 27Hz 的实时决策,在 Bench2Drive 闭环评测中刷新了 SOTA 记录。
痛点深挖:为何 VLA 模型在驾驶位上“反应迟钝”?
将视觉语言模型(VLM)转化为视觉语言动作(VLA)模型是端到端自动驾驶(E2E AD)的前沿趋势。然而,现有的方法存在两个致命伤:
- 灾难性遗忘 (Catastrophic Forgetting):为了让 VLM 学会开车,研究者通常会进行全参数微调,但这往往导致模型丧失了原本在海量互联网数据上习得的通用常识。
- 同步频率瓶颈:VLM 的自回归推理速度极慢,若将决策频率与复杂的链式思考(CoT)逻辑耦合,系统响应将远低于安全驾驶所需的频率,导致“想得太深,反应太慢”。
核心方法论:AutoMoT 的异步哲学
AutoMoT 的核心直觉在于**“快慢结合”**:高层的语义推理可以稍微慢一点,但底层的动作规划必须绝对实时。
1. 架构解耦:理解专家 vs. 动作专家
- 理解专家 (Understanding Expert, UE):采用 Qwen3-VL 骨干,保持冻结状态。它负责理解复杂的交通场景并生成语义解释。
- 动作专家 (Action Expert, AE):一个 1.6B 参数的任务特化 Transformer。它通过层级联合注意力机制,从 UE 的特征序列中汲取知识。
2. 异步推理与 KV Caching
这是 AutoMoT 实现实时性的“杀手锏”。模型不需要每一帧都重新运行沉重的 UE。
- UE 以较低频率更新其生成的 Key-Value 池。
- AE 以 27Hz 的高频通过跨任务因果掩码(Causal Mask)检索缓存中的语义信息,直接生成动作。
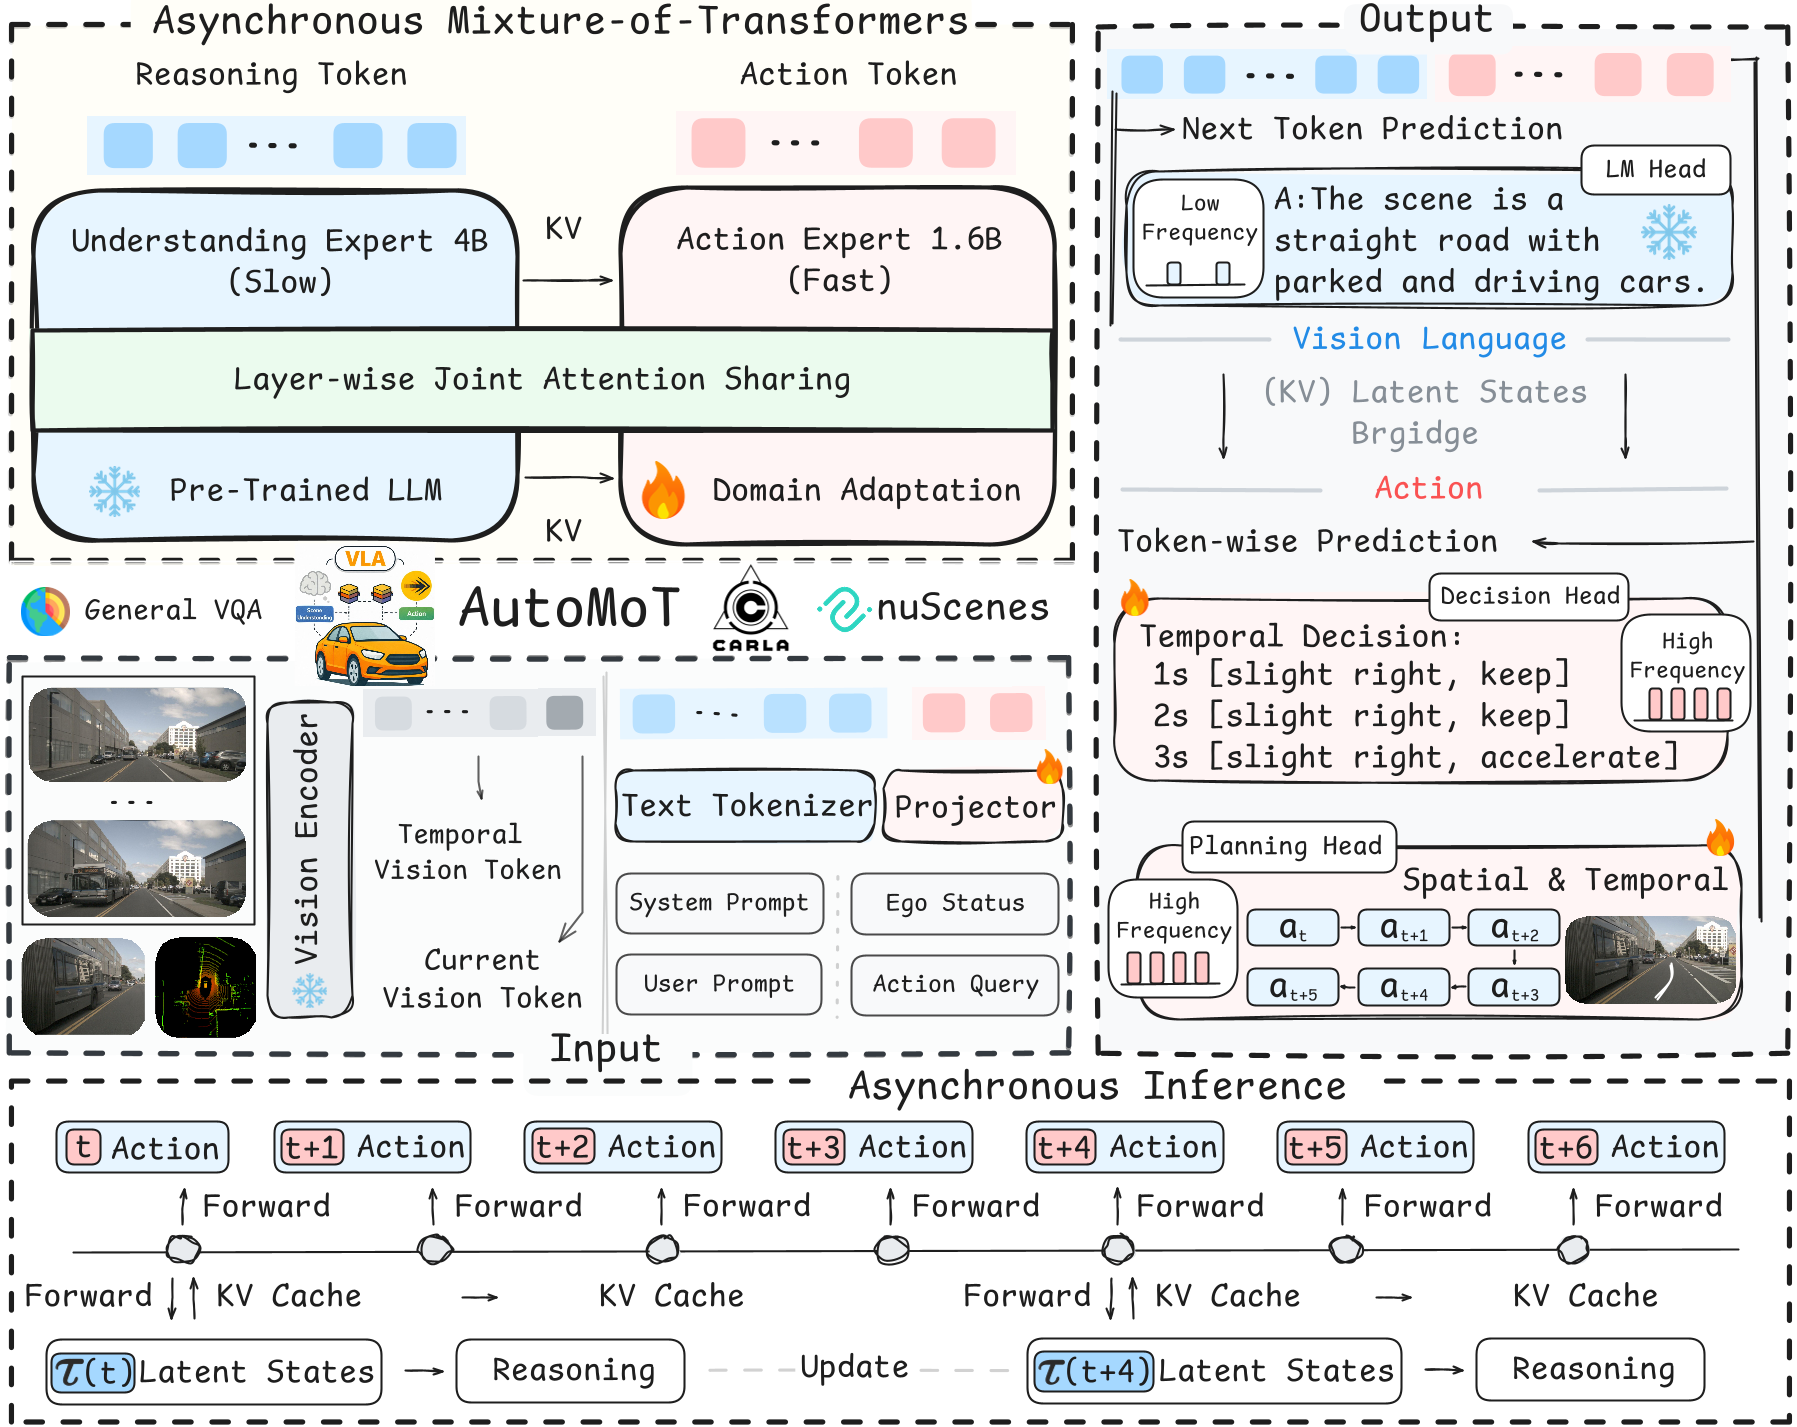 图 1:AutoMoT 整体架构图,展示了 UE、AE 与 Action Refiner 之间的异步交互机制。
3. 注意力掩码设计
为了确保信息流的合理性,作者设计了一个复杂的混合掩码:
- 任务内:多模态信息双向融合。
- 任务间:遵循“理解 决策 规划”的因果顺序,动作侧严格依赖于理解侧的语义输出。
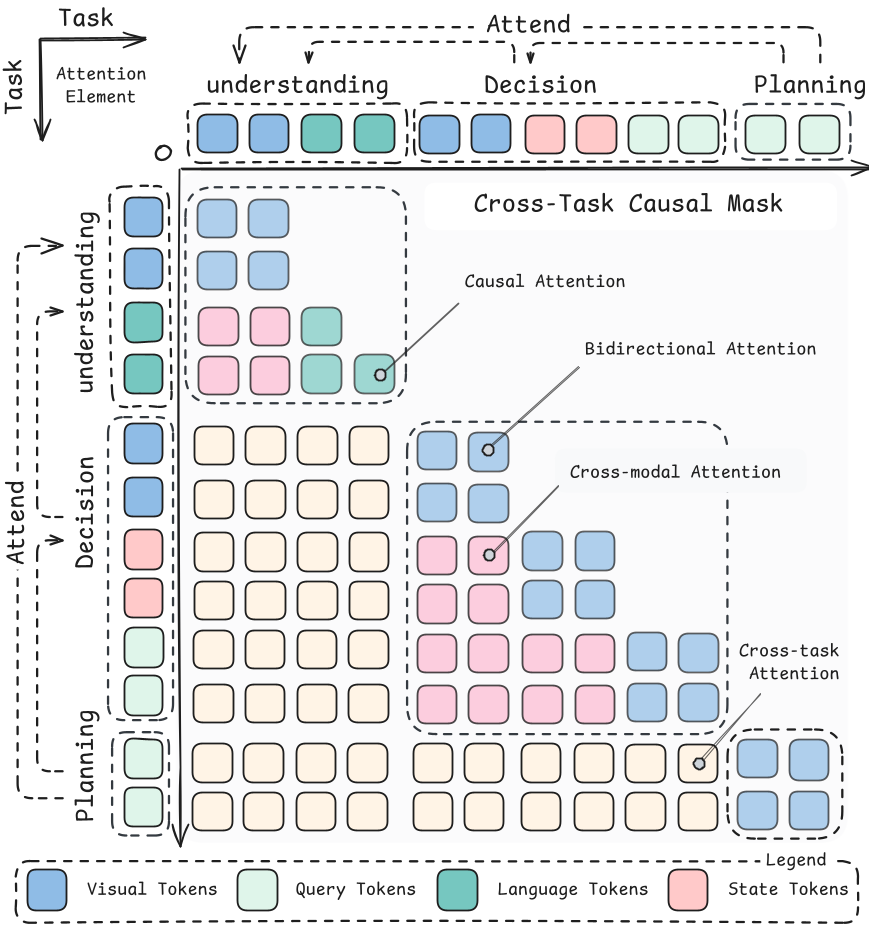 图 2:跨任务因果掩码设计,确保了高性能的语义对齐。
实验战绩:速度与精度的双重胜利
1. 闭环驾驶表现
在最具挑战性的 Bench2Drive 榜单上,AutoMoT 展现出了压倒性的优势。相比之前的开源 SOTA 方法 SimLingo,其驾驶分数(Driving Score)提升了约 4%,成功率(SR)达到了 74.09%。
2. 效率与精度的权衡
实验证明,即使 UE 的信息延迟 1.0s,AE 依靠缓存特征进行的规划误差(L2 误差)也仅上升了 0.002m,这种微小的精度损失换来了 68.5% 的计算延迟降低。
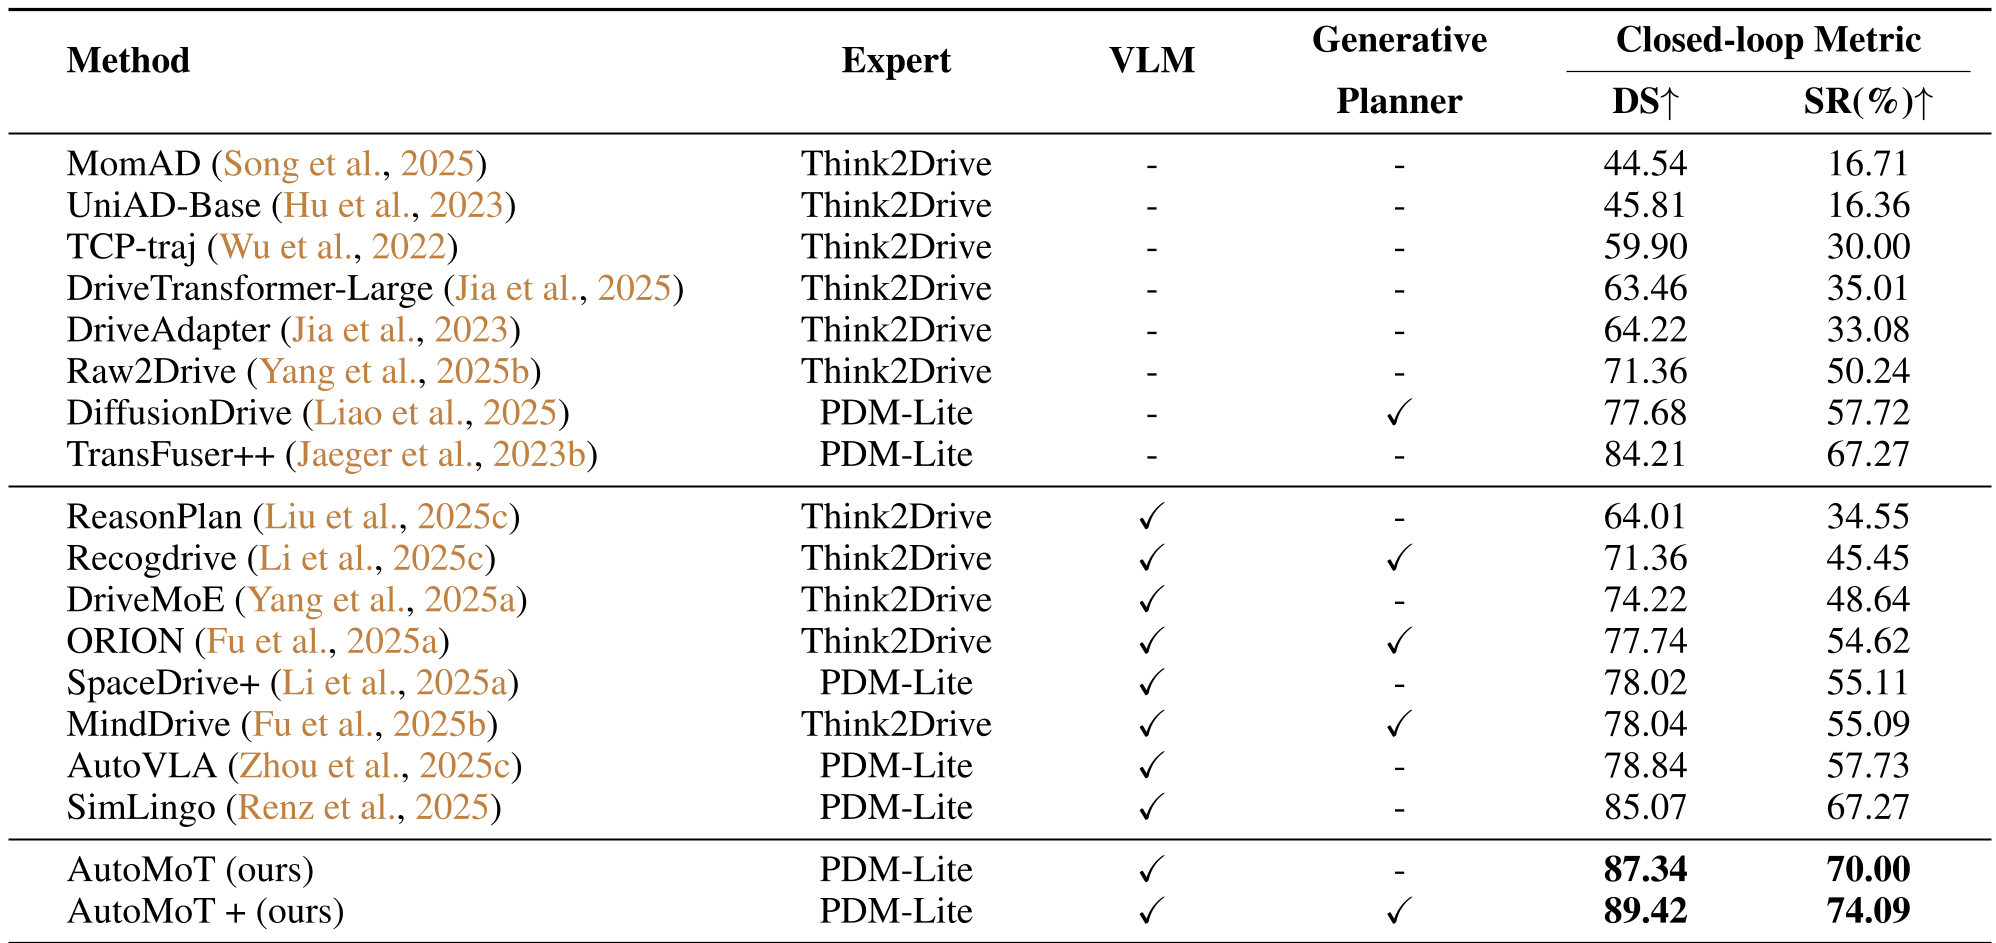 表 1:收录了 AutoMoT 与主流端到端方法的闭环性能对比。
深度洞察:VLA 模型的真正边界在哪里?
AutoMoT 的消融实验给学界带来了一个重要的思考:VLM 到底需不需要微调?
作者发现,对于“场景理解”任务,预训练模型通过 Prompt 已经能做到极佳;但对于“动作层面”的任务,特定的微调是不可或缺的。AutoMoT 通过冻结 UE 并训练 AE 的方式,完美守住了这两者的边界,既保留了“大智慧”,又掌握了“精细活”。
局限性与展望
尽管 AutoMoT 在现有算力平台上实现了不错的 Hz,但其 4B+1.6B 的参数规模对于端侧部署仍有压力。未来的研究方向可能在于如何进一步将这套异步混合架构量化并蒸馏到更小规模的端侧控制器中。
总结:AutoMoT 证明了通过异步设计和 KV 缓存 reuse,我们可以让重型 VLM 在自动驾驶这种高动态场景中既“聪明”又“敏捷”。