
AutoProteinEngine:对话即工程,LLM 驱动的蛋白质多模态 AutoML 革命
AutoProteinEngine: A Large Language Model Driven Agent Framework for Multimodal AutoML in Protein Engineering
本文提出了 AutoProteinEngine (AutoPE),这是一个由大语言模型 (LLM) 驱动的智能体框架,专门用于蛋白质工程的多模态自动化机器学习 (AutoML)。系统通过自然语言交互,实现了蛋白质序列与图形数据的模型自动选择、超参数优化及数据库检索,在 Brazzein 甜度分类和 STM1221 酶活性回归任务中显著优于 Zero-shot 和人工调优基线。
核心速览 (Executive Summary)
TL;DR:AutoProteinEngine (AutoPE) 是一个创新的 Agent 框架,它允许生物学家仅通过自然语言对话即可完成复杂的深度学习模型训练。该框架集成了数据自动检索、多模态模型选择(支持序列与结构)、以及自动超参数优化 (Auto HPO),将专业的深度学习工作流转化为触手可及的学术助手。
背景定位:AutoPE 是领域内首个专门针对蛋白质工程的多模态 AutoML Agent。它不仅是蛋白质语言模型(PLM)的应用工具,更是通过 LLM 封装了专家级调优经验的“科研加速器”。
痛点深挖 (Problem & Motivation)
在当前的蛋白质工程领域,生物学家面临着一个尴尬的“数字鸿沟”:
- 技术门槛高:即便有 ESM-2 或 AlphaFold 这种强大的预训练模型,微调这些模型仍需要对 Transformer 架构、学习率策略和超参数空间有深刻理解。
- 数据处理复杂:蛋白质数据具有多模态特性(氨基酸序列 + 3D 空间结构),如何有效融合这些信息并从 PDB 或 UniProt 数据库提取相关特征,对非计算背景的科研人员极具挑战。
- AutoML 的局限性:现有的通用 AutoML 工具(如 AutoGluon)往往不具备蛋白质领域的生物直觉,无法在模型选择阶段考虑蛋白质特有的电荷、亲疏水性或拓扑结构。
方法论详解 (Methodology)
AutoPE 的核心在于其三位一体的架构:
1. LLM 驱动的任务编排
框架前端由一个经过蛋白质领域强化的 LLM(TourSynbio-7B)驱动。它负责将用户的模糊指令(如“我想预测这种蛋白质的变异稳定性”)转化为具体的计算图:
- 任务验证:判断任务属于分类还是回归。
- RAG 支撑:通过检索相关论文知识,建议最适合该任务的蛋白质语言模型。
2. 自动化 Hyperparameter Optimization (HPO)
AutoPE 不仅仅是自动运行代码,它内置了高级 HPO 策略:
- TPE (Tree-structured Parzen Estimator):用于高效探索参数空间。
- ASHA 调度器:实现异步连续减半算法,快速剔除表现不佳的试验(Early Stopping),节省算力。
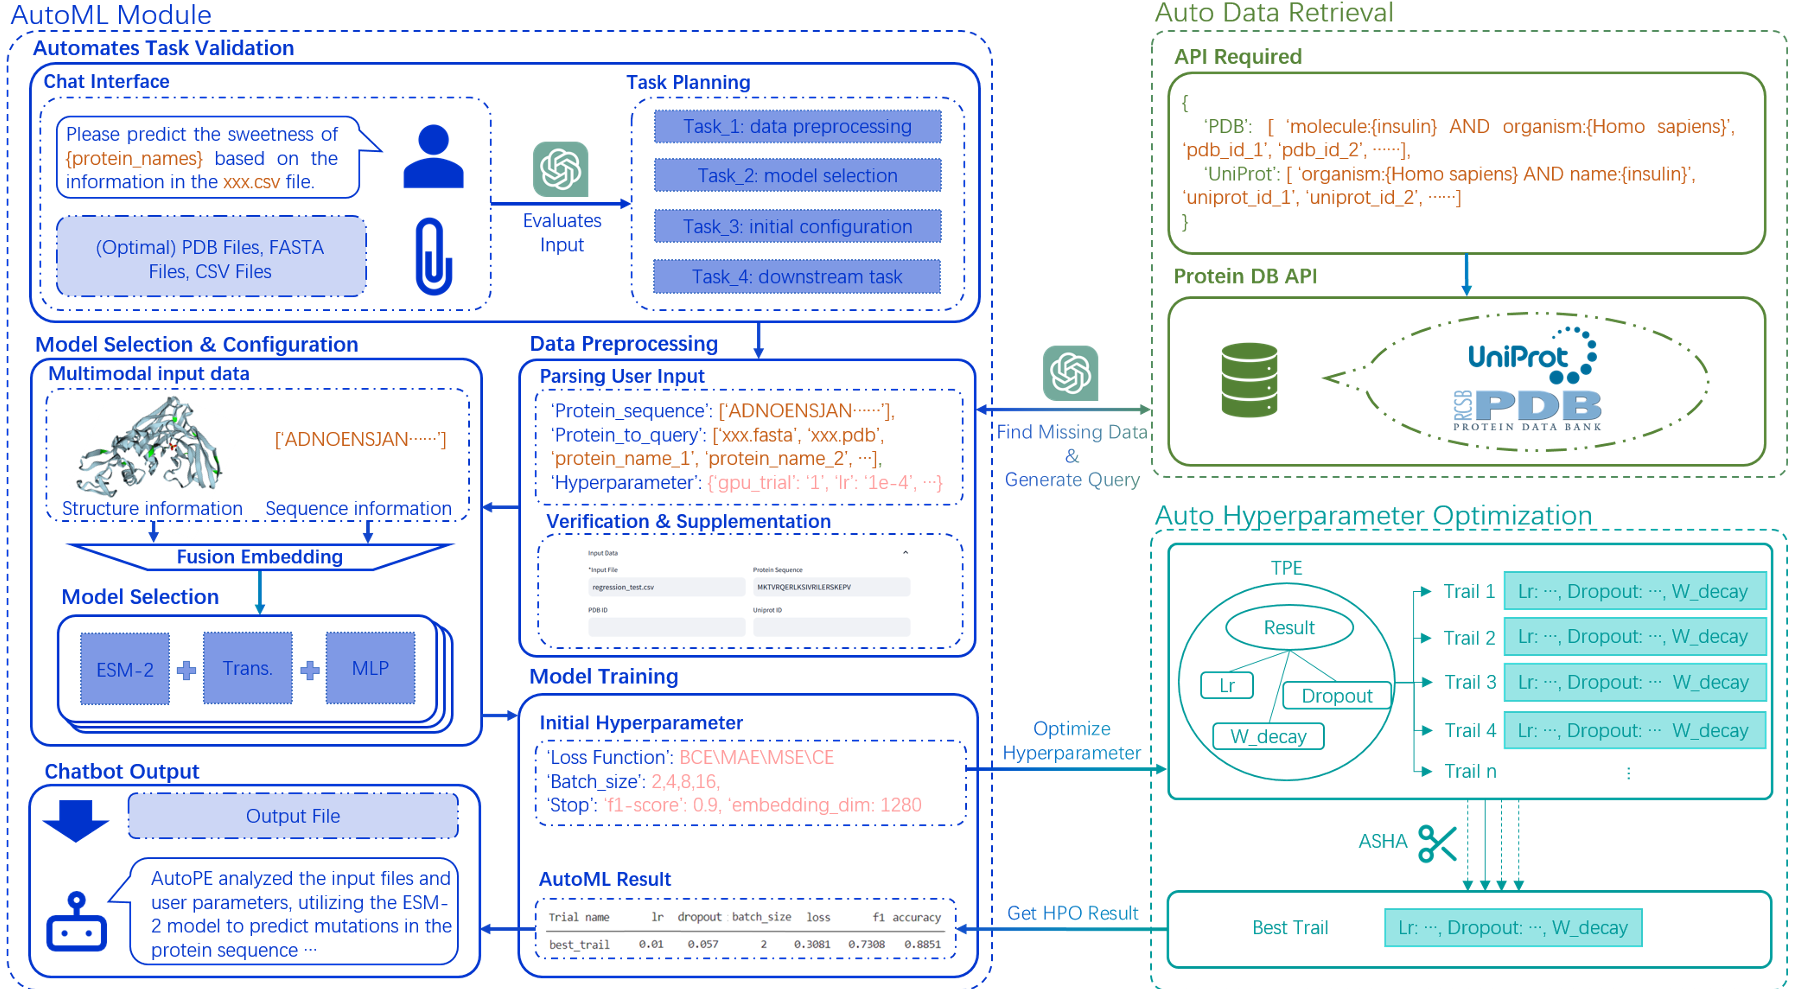 图 1:AutoProteinEngine 总体架构,涵盖对话界面、AutoML 核心与数据检索模块
3. 多模态融合 (Multimodal Fusion)
针对蛋白质任务,AutoPE 实现了 Late Fusion (后期融合) 方案。它提取蛋白质序列(ESM 嵌入)和 3D 图形(Graph Embeddings)的特征向量,在输出层进行拼接融合。这种方式相比单模态模型能更全面地捕获蛋白质的功能信息。
实验与结果 (Experiments & Results)
研究人员选取了两个极具代表性的真实现场案例:
- 甜度预测(分类):针对 Brazzein 蛋白质的 435 个突变体,AutoPE (w/ HPO) 在 F1-Score 上达到了 0.7306,显著超越了由资深算法工程师手动调优的 0.5709。
- 酶活性预测(回归):在 STM1221 酶活性任务中,AutoPE 的 R² Score 提升至 0.6805。
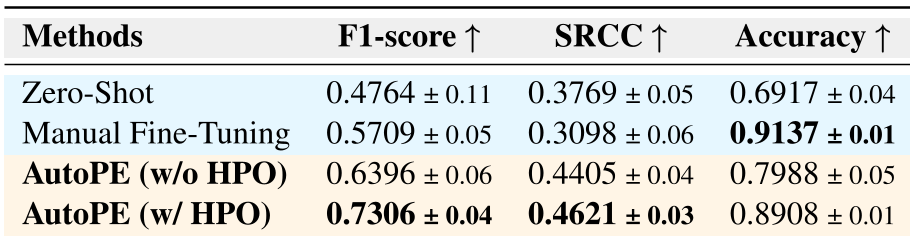 表 1:在 Brazzein 甜度分类任务中,AutoPE 与 Zero-shot 及人工调优的性能对比。可见 AutoPE 在 F1 指标上具有显著优势。
消融研究 (Ablation Study) 表明,Auto HPO 模块是提升性能的核心。仅依靠 LLM 选择模型(w/o HPO)虽然能跑通流程,但通过 ASHA 和 TPE 的精密搜索,模型在鲁棒性和泛化能力(F1/SRCC)上得到了质的飞跃。
深度洞察与总结 (Critical Analysis & Conclusion)
总结 (Takeaway)
AutoProteinEngine 最重要的价值在于普惠化(Democratization)。它将复杂的深度学习建模过程抽象为自然语言指令,不仅提高了效率,更重要的是让领域专家(生物学家)重新夺回了模型设计的主导权。
局限性与未来展望 (Limitations & Future Work)
虽然 AutoPE 在分类和回归任务中表现出色,但目前对于 De novo(从头设计) 这种生成式任务的支持尚处于初级阶段。此外,未来的工作可以进一步集成更多的专用蛋白质数据库(如 AlphaFold DB),并引入更强大的多模态预训练模型作为 Backbones,以处理更复杂的蛋白质-蛋白质相互作用(PPI)分析。
对于未来的实验室,AutoPE 这种 Agent 框架可能会成为像显微镜一样基础的科研工具,实现“实验设计-数据分析-模型预测”的闭环自动化。