
《BAPO:用 Adaptive Clipping 稳定 LLM 的 Off-Policy RL,把“熵塌缩”变成可控变量》
BAPO: Stabilizing Off-Policy Reinforcement Learning for LLMs via Balanced Policy Optimization with Adaptive Clipping
本文研究的是面向大语言模型的 off-policy reinforcement learning 稳定性问题,提出了 BAPO(Balanced Policy Optimization with Adaptive Clipping),通过自适应调整 PPO/GRPO 风格目标中的 clipping 边界来平衡正负 advantage 样本贡献并维持策略熵。该方法在 AIME 2024/2025 上取得同尺度模型中的 SOTA:7B 模型超过 SkyWork-OR1-7B,32B 模型不仅领先同规模开源模型,还超过 o3-mini-medium 与 Gemini-2.5-Flash-Thinking。
核心速览
TL;DR
- 这篇论文讨论的不是“如何让 RL 再涨一点分”,而是一个更底层的问题:为什么 LLM 在 off-policy RL 中这么容易训练崩掉。
- 作者指出,PPO/GRPO 式目标在 stale data 下会出现两个结构性问题:负 advantage token 对梯度的主导,以及 固定 clipping 对熵增长更新的系统性压制。
- 基于这个分析,论文提出 BAPO,通过 Adaptive Clipping 动态调整 clipping 上下界,让正样本贡献保持在目标比例附近,同时保留更多有助于探索的低概率正 token。
- 实验上,BAPO 在 7B 和 32B 数学推理模型上都显著优于 GRPO,并在 AIME 2024/2025 上达到同尺度开源 SOTA,32B 甚至超过部分 proprietary systems。
背景定位
这篇工作不是简单的“又一个 RL trick”,而是典型的 机制解释 + 训练算法修补 + 刷榜验证 三位一体的论文。它在学术坐标系中的位置更接近:为 LLM off-policy RL 提供一个可操作的稳定化原则。如果说早期很多工作只是在调 clip、控 entropy、做 curriculum,那么 BAPO 的贡献是把这些经验现象归结到一个统一框架下。
痛点与动机
为什么 off-policy RL 对 LLM 很诱人?
原因很现实:
- 样本效率更高:可以重复利用旧 rollout。
- 更适合工程系统:现代训练基础设施里常有 sample replay、partial rollout、异步采样。
- 长轨迹任务更需要它:推理、Agent、多轮决策都很难完全 on-policy。
但问题也同样现实:只要数据稍微 stale 一点,训练就开始不稳。
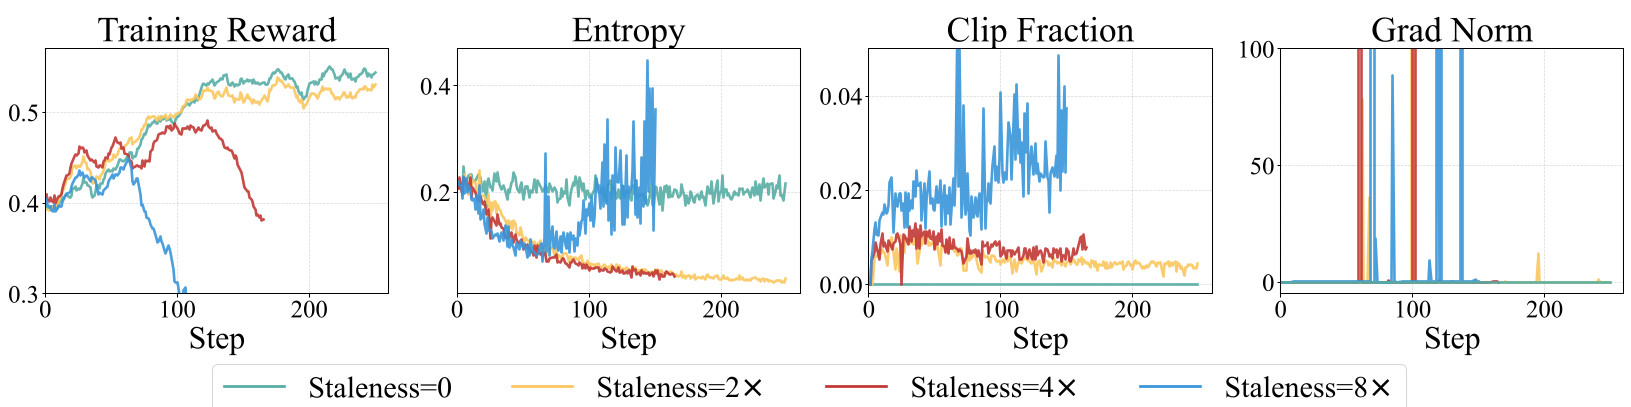
图 2 非常关键。它说明随着 data staleness 增大:
- 训练 reward 波动加剧;
- gradient 可能爆炸;
- policy entropy 持续下降;
- 严重时直接 collapse。
这里最重要的观察不是“off-policy 有偏”,而是:它会把策略推向越来越尖锐、越来越不探索的分布。
现有方法错在哪里?
论文认为,Prior Work 往往只抓住了一部分现象:
- 有些工作尝试放宽上界,比如 Clip-Higher,让正样本更容易进入更新;
- 有些工作通过 target entropy 或 high-entropy token 筛选维持探索;
- 也有工作做 asymmetric clipping。
但这些方法普遍没有直接回答两个核心问题:
- 为什么负样本会系统性主导优化?
- 为什么固定 clipping 会天然打压熵增长?
作者的关键 Insight 是:PPO 风格 clipping 并不是中性的安全装置,它本身就在重塑可被优化的 token 子集。一旦这个子集偏向“高概率正 token + 低概率负 token”,策略就会越来越尖,entropy 就会塌。
方法论详解
从 PPO 梯度重写开始:谁真的参与了更新?
PPO 类目标本质上是:
- 正 advantage token:当 importance ratio 没超上界时参与更新;
- 负 advantage token:当 importance ratio 没低于下界时参与更新。
论文把梯度拆成正负两部分后,得到一个非常直观的表达:被 clipping 掉的 token,梯度直接消失。这件事在 on-policy 下问题还不严重,但在 off-policy 下,importance weight 偏离 1 更频繁,于是“哪些 token 能进更新集”就变成了核心问题。
洞察一:Imbalanced Optimization
作者发现,训练中负 advantage token 的数量和 loss 贡献都显著更高。原因主要有两个:
- 难题会生成更长轨迹,所以失败样本往往带来更多 token;
- 训练早期模型能力不够,负样本比例天然更高。
这意味着什么?
- 梯度主要被“惩罚性信号”驱动;
- 即使某些 token 只是中性或局部正确,也可能被负样本洪流淹没;
- 大量低概率负 token 还会带来数值不稳定,诱发 gradient explosion。
这不是简单的数据不平衡,而是 token-level optimization imbalance。
洞察二:Entropy-Clip Rule
这是本文理论上最值得记住的部分。
作者推导出策略熵变化近似满足:
[ \Delta \mathcal{H}(\pi_ heta) \approx -\eta \cdot \mathrm{Cov}[\log \pi_ heta(y_t), A_t \cdot \mathcal{X}(y_t) + C] ]
其中 (\mathcal{X}(y_t)) 表示这个 token 是否没有被 clipping 掉。核心含义是:
- 只有未被 clipping 的 token 才影响熵变化;
- 熵变化由 token 的 log probability 与 advantage 的协方差决定。
作者进一步分析四类 token:
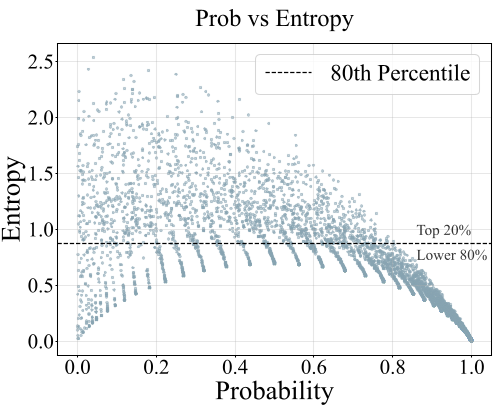
- 高概率 + 高 advantage:降低熵
- 高概率 + 低 advantage:提升熵
- 低概率 + 高 advantage:提升熵
- 低概率 + 低 advantage:降低熵
这件事的直觉非常强:
- 如果你总在强化“本来就高概率且回报高”的 token,分布会更尖;
- 如果你允许“低概率但其实有价值”的 token 被强化,分布会更平滑,探索能力被保留。
而标准对称 clipping 的问题是:
- 它经常把低概率正 token裁掉;
- 却保留了不少低概率负 token的惩罚。
于是优化方向天然偏向熵下降。
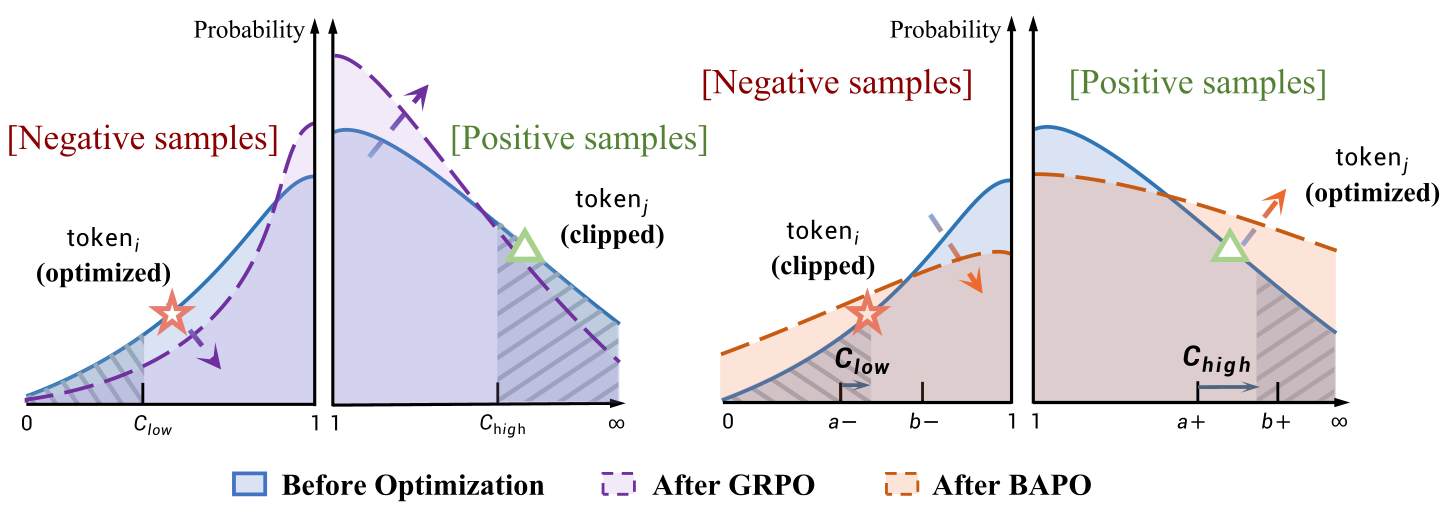
这张图几乎就是全文思想的可视化总结。左边是基线:固定对称 clipping 导致过度 exploitation。右边是 BAPO:通过动态调节上下界,让进入更新的 token 集合重新平衡。
先做验证:Asymmetric Clipping 确实有用
作者先做了一个很重要的验证实验:
- 增大上界 (c_{high}):引入更多低概率正 token,性能提升,entropy 下降变慢;
- 放宽下界 (c_{low}):引入更多低概率负 token,性能变差,entropy 更快塌缩。
这一步很关键,因为它说明熵控制真的可以通过“选择哪些 token 进更新”来实现,不是附带现象。
BAPO:Balanced Policy Optimization with Adaptive Clipping
真正的方法非常朴素,但也因此很有工程吸引力。
BAPO 的目标不是手工指定某个固定 clip 区间,而是在每个 batch 上动态寻找一对 ((c_{low}, c_{high})),使得:
- 正 token 对 policy loss 的贡献占比至少达到阈值 (\rho_0)。
形式化地,它控制的是:
- 分子:正 advantage token 的 loss 贡献;
- 分母:全部 token 的 loss 贡献;
- 比值大于某个目标阈值 (\rho_0)。
算法流程大致是:
- 初始化较保守的上下界;
- 如果正 token 贡献还不够:
- 优先增大 (c_{high}),让更多低概率正 token 进入;
- 若上界已到范围上限,再提高 (c_{low}),过滤部分负 token;
- 直到正 token 贡献达到目标;
- 用这个自适应 clip 区间执行当前步更新。
从直觉上看,BAPO 在做三件事:
- 让正样本不再是少数派
- 避免低概率负样本过度支配梯度
- 把 entropy preservation 变成优化约束的一部分
它和 DAPO、DCPO 的差异也在这里:
- DAPO 更像“固定地调高上边界”;
- DCPO 是 token-level 的概率感知 clipping;
- BAPO 是 从全局 loss contribution 角度动态调边界。
这个视角更“优化论”,而不只是 token 启发式。
实验与结果
主结果:BAPO 不只是更稳,也确实更强
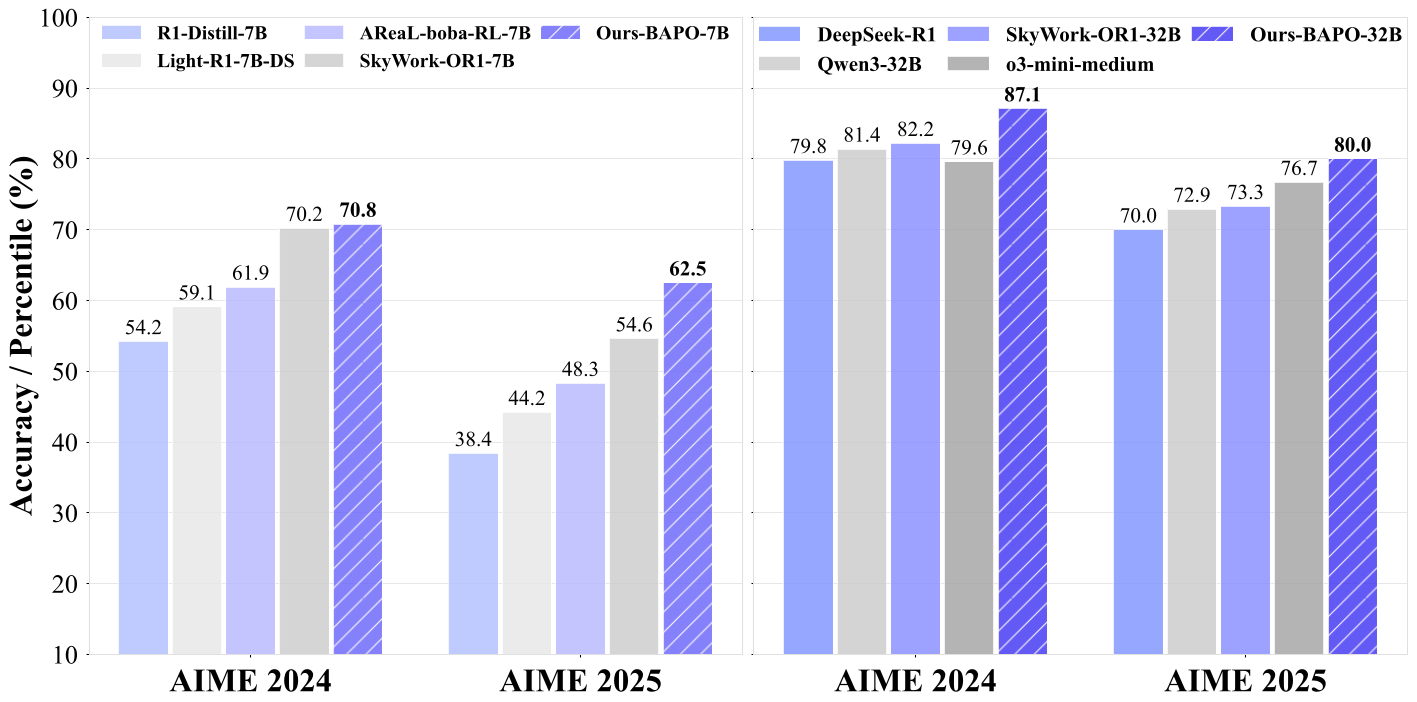
主实验结论很明确:
7B 模型
- BP-Math-7B-SFT:AIME24 66.9,AIME25 59.0,平均 62.9
- BP-Math-7B-GRPO:69.2 / 59.2 / 64.2
- BP-Math-7B-BAPO:70.8 / 62.5 / 66.7
相对 GRPO:
- AIME24 +1.6
- AIME25 +3.3
- 平均 +2.5
相对 SFT:
- AIME24 +3.9
- AIME25 +3.5
并且它超过了 SkyWork-OR1-7B(62.4 平均),特别是在 AIME25 上高出 7.9 分。
32B 模型
- BP-Math-32B-SFT:84.4 / 78.1 / 81.3
- BP-Math-32B-GRPO:84.6 / 78.8 / 81.7
- BP-Math-32B-BAPO:87.1 / 80.0 / 83.5
相对 GRPO:
- AIME24 +2.5
- AIME25 +1.2
- 平均 +1.8
相对 SFT:
- AIME24 +2.7
- AIME25 +1.9
更重要的是横向对比:
- 超过 Qwen3-32B:AIME24 +5.7,AIME25 +7.1
- 超过 SkyWork-OR1-32B:AIME24 +4.9,AIME25 +6.7
- 超过 o3-mini-medium 与 Gemini-2.5-Flash-Thinking
这说明 BAPO 不是只对弱 baseline 生效,而是有真实的 SOTA 竞争力。
训练动态:为什么它更稳?
训练动态图反映了几个关键点:
- reward 上升更快;
- 正 token loss contribution 更高;
- gradient norm 更平稳;
- entropy 不再持续单边下滑。
这其实正对应 BAPO 的设计初衷。它不是靠更激进更新刷出更高 reward,而是通过重新组织有效更新子集,让训练处在更健康的探索-利用平衡点上。
对不同 staleness 的鲁棒性
论文还专门测了不同陈旧度的 off-policy 设置。结论是:
- staleness 越高,基线越容易崩;
- Clip-Higher 有帮助,但不够;
- BAPO 在各种 staleness 下都持续领先。
这说明它并不是只在轻微 off-policy 条件下有效,而是对 stale data 具有系统性的缓解作用。
Partial Rollout:工业场景下更重要
现代 LLM RL 系统里,partial rollout 很常见。长轨迹切段回放能提速,但天然引入 off-policy 问题。论文在这个设置下也验证了 BAPO:
- 相比 GRPO,优化更稳定;
- 对 replay/异步基础设施更鲁棒。
这一点非常有产品价值。很多算法在论文基准里有效,但一到真实系统里就被异步、缓存、分段采样击穿。BAPO 的优势恰恰在于它正面对准了这个问题。
与其他 RL 变体对比
在 BP-Math-7B 骨干上:
- SFT:62.9
- GRPO:64.2
- DAPO:64.6
- TOPR:64.6
- DCPO:63.4
- BAPO:66.7
这说明 BAPO 不只是“比原始 GRPO 好”,也优于若干最近提出的稳定化变体。
泛化到其他推理任务
论文还给出跨领域结果,尤其值得注意:
- AMC 2023:从原始 73.3 提到 92.5
- OlympiadBench:33.6 到 58.4
- ARC-AGI:0 到 3.2
- GPQA-Diamond:42.4 到 51.3
虽然这里训练设置和数据不同,不能简单横向类比,但至少说明 BAPO 的收益并不局限于 AIME 数学题,而是对更广义 reasoning task 也有帮助。
深度洞察与总结
这篇论文最本质的贡献是什么?
我认为不是“adaptive clipping”这四个字本身,而是以下三点:
-
把 off-policy LLM RL 的不稳定性拆成了两个可解释机制
- 正负样本贡献失衡
- clipping 导致熵提升更新被系统性屏蔽
-
把 entropy maintenance 从正则项问题变成了 sample selection 问题
- 不是额外加一个 entropy bonus,
- 而是直接控制哪些 token 允许参与优化。
-
给出了一种足够简单、能接到现有 PPO/GRPO 管线里的修补方式
- 不需要大改系统;
- 只改 clipping 策略;
- 很适合工业落地。
为什么 BAPO 会有效?
一句话总结:
它不是在“放大正样本”,而是在“重构有效梯度的组成”。
这两者有本质区别。
很多工作只是在某一侧加权,比如提高正样本权重。但如果负样本仍旧海量涌入,且低概率负 token 继续主导更新,那么训练动力学并不会从根本上改变。BAPO 的优势在于:
- 同时操作上界和下界;
- 动态按 batch 调整;
- 用“正 token 贡献比例”作为闭环信号。
因此它形成了一个反馈控制系统,而不是一次性超参数设定。
局限性
这篇论文也有几个需要冷静看的地方:
-
理论建立在 tabular softmax 与局部近似上
Entropy-Clip Rule 很有启发性,但从 tabular softmax 到超大 Transformer 的迁移,严格性仍然有限,更像机制解释而非完备理论。 -
核心阈值 ρ0 依然是人为设定
虽然论文显示其鲁棒,但本质上这是一个任务相关的控制目标。未来是否能自适应地学习 ρ0,会更自然。 -
主要验证集中在 reasoning / math 场景
尽管有跨任务实验,但代码、Agent、多模态、对话安全等场景是否同样受益,还需要更系统验证。 -
与 KL-based trust region 或 explicit entropy regularization 的关系仍可深化
BAPO 实际上在做一种隐式 exploration control,未来可以与更强的优化理论统一起来。
未来展望
我认为这条路线接下来有三个很值得追的方向:
-
从全局 clipping 到分层 clipping
- 现在是 batch 级全局边界;
- 将来可以做 prompt-level、trajectory-level,甚至 layer-aware clipping。
-
与 replay buffer 策略联合设计
- 既然 stale data 是根源之一,那么 clipping 与 sample selection 应该协同优化,而不是分开处理。
-
扩展到 Agent / long-horizon decision making
- 在长轨迹任务里,负 token 多、staleness 强、partial rollout 常见;
- BAPO 这类方法理论上会比在短推理任务上更有价值。
最后的 Takeaway
BAPO 的真正启发是:
- 在 LLM 的 RL 里,“更新哪些 token” 与 “怎么更新参数” 一样重要;
- clipping 不是纯粹的稳定器,而是一个会改变探索结构的选择器;
- 要做稳定的 off-policy RL,关键不是一味压更新幅度,而是让有效梯度的组成保持平衡,并给探索留出生存空间。
如果你正在做 LLM reasoning、Agent RL 或任何需要 replay/partial rollout 的系统,这篇论文非常值得细读。它提供的不只是一个能涨分的算法,更是一套理解训练动力学的视角。