
[BEA 2025] AI 导师合格吗?深度解析 LLM 在教育对话中的教育能力评估
Findings of the BEA 2025 Shared Task on Pedagogical Ability Assessment of AI-powered Tutors.pdf
总结
问题
方法
结果
要点
摘要
本文介绍了 BEA 2025 关于 AI 导师教育能力评估的共享任务(Shared Task),旨在评估 LLM 在数学教学对话中纠正学生错误的能力。任务涵盖了错误识别、定位、引导提供、建议可操作性及导师身份识别五个维度,吸引了全球 50 多支团队参与。
TL;DR
在最近的 BEA 2025 共享任务中,研究者们对 AI 导师(由 GPT-4, Llama-3.1 等驱动)进行了一场专业的“教育资格考”。结果显示,虽然 AI 识别学生错误的能力尚可,但在**“如何引导学生(而非直接给答案)”**这一核心教学能力上,各大模型及其配套算法依然表现平平。
1. 为什么我们需要专门的教育评估?
目前的 LLM 评估大多关注文本流畅度或通用的逻辑推理,但**“会做题”不代表“会教人”**。一个优秀的教育对话系统不应只是一个“答案机器”,而应遵循学习科学原理:
- Active Learning:鼓励学生思考,不直接泄露答案。
- Cognitive Load Management:通过精准的错误定位(Mistake Location)减轻学生的认知负担。
- Actionability:给出的反馈必须是学生下一步能执行的具体指令。
2. 任务架构:五条赛道的全方位审视
本次 BEA 2025 任务设置了五个 Track 来衡量 AI 导师的表现:
- 错误识别 (Mistake Identification):导师是否看出了学生在数学计算或逻辑上的偏差?
- 错误定位 (Mistake Location):导师能否准确指出错误出在哪一步?
- 提供引导 (Providing Guidance):这是最难的一项,导师能否提供启发式的 Hint。
- 可操作性 (Actionability):反馈是否清晰,学生知道接下来该干什么吗?
- 导师身份识别 (Tutor Identification):通过风格判断这条响应是来自哪个 LLM 还是人类专家。
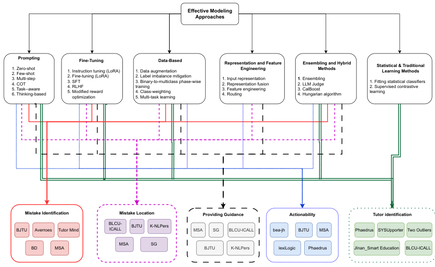 图 1:顶尖团队采用的有效建模方法概览
3. 技术路线:SOTA 们是怎么做的?
从参赛的 50 多支国际团队来看,最有效的方案通常结合了以下技术:
- LoRA 指令微调:针对教育特定任务(如 Mathstral-7B)进行低秩自适应微调。
- 提示词工程 (Prompt Engineering):采用思维链 (CoT) 或多步推理(Multi-step Prompting)来模拟专家的思考过程。
- 集成学习 (Ensemble):通过多数投票或分层判别模型来提升预测稳定性。
- 强化学习 (GRPO/RLHF):部分顶尖团队(如 bea-jh)使用了 GRPO 算法,通过结构化标签来增强模型的推理一致性。
4. 实验结果:AI 导师的“偏科”现状
实验数据揭示了一个有趣的现象:
- 易如反掌的任务:导师身份识别(Track 5)。优秀的集成模型能以 96.98% 的 F1 分数识别出响应的具体来源,这说明目前各种 LLM 在教学风格(或幻觉风格)上有着极强的偏好特征。
- 难以逾越的鸿沟:提供引导(Track 3)。该赛道的最高 F1 分数仅为 58.34。这反映出 LLM 在处理模糊、开放的教育场景时,往往倾向于给出一个泛泛而谈的鼓励,或是干脆跳到最后一步,难以掌握“授人以渔”的火候。
提示:在此处可展示各赛道 Top 排名的 F1 分数对比柱状图
5. 深度洞察:最难纠正的错误
在测试集中,有一个关于“牙膏使用天数”的经典难题(见原文 Table 7)。由于题目涉及多人口、多频率的复合计算,大多数 AI 导师都陷入了“部分纠正”的陷阱:
- 有的导师看出了计算错误,但没看出学生的假设错误。
- 有的导师过度赞扬学生,导致误导。 这说明 AI 对教育序列(Pedagogical Sequence)的掌控仍处于弱推理阶段。
6. 未来展望与总结
BEA 2025 的这项研究为我们指明了方向:
- 数据为王:需要更多具备专家级教育引导标注的数据集。
- 模型对齐:目前的对齐(Alignment)多关注安全性,未来需要“教育性对齐”。
- 领域泛化:目前的测评集中在数学领域,未来的 AI 导师需要跨学科的教育敏感度。
总之,虽然 AI 已经可以像人类一样交谈,但要成为一名合格的“赛博导师”,它还需要在理解学生意图和实施启发式干预方面更进一步。