
视觉目标检测全景图:从 2D 单目锚点到 3D 双目几何重构
Distributed by Beijing Bureau for Distribution of Newspapers and Journals Domestic All Local Post Offices in China
本文由天津大学等高校联合撰写,对基于深度学习的视觉目标检测技术进行了全景式综述。涵盖了从单目到双目相机的检测算法,详细拆解了 R-CNN 系列、YOLO/SSD、端到端检测(DETR)及 3D 双目检测的核心架构与 SOTA 进展。
TL;DR
本文深度解析了基于深度学习的视觉目标检测综述。核心涵盖:1) 单目检测的三段式进化(从 Anchor-based 到 Transformer 端到端);2) 双目检测的几何直觉(如何从图像视差重构 3D 空间);3) 全流程优化(从 Mosaic 数据增强到标签分配策略的数学本质)。
背景定位:视觉检测的坐标系
目标检测不仅是简单的“识物”+“画框”,它是自动驾驶感知系统与机器人视觉的基础。作者将该领域划分为**单目(Monocular)与双目(Stereo)**两条技术线。
1. 单目视觉检测:锚点之争与端到端革命
单目检测的发展史即是对“物体表达方式”的探索史:
- 基于锚点框(Anchor-based):两阶段(Faster R-CNN)通过先验框(Prior Boxes)换取精度,单阶段(YOLO/SSD)则通过牺牲部分局部精度换取实时速度。
- 无锚点框(Anchor-free):通过“关键点检测(CenterNet/CornerNet)”或“内部点预测(FCOS)”摆脱了对长宽比等手工超参数的依赖,增强了模型的泛化能力。
- 端到端预测(End-to-End):以 DETR 为代表,利用 Transformer 的全局注意力机制,通过匈牙利算法实现物体与其预测框的一对一匹配,从根本上终结了 NMS 对后处理的依赖。
 图 1:基于深度学习的视觉目标检测训练与测试全流程
2. 双目视觉检测:丢失的 3D 信息如何寻回?
双目相机的本质是模仿人类双眼,通过**视差(Disparity)**计算深度。论文将此类方法分为两类物理直觉:
- 直接视锥空间检测:在图像投影坐标系内串接左右目特征。虽然简单,但容易受物体远近带来的尺度不一致影响。
- 显式逆投影检测(Pseudo-LiDAR):这是近年来的重大进展。它将 2D 图像特征“拉伸”回 3D 笛卡尔坐标系,形成类似激光雷达的点云或体素(Voxel)。
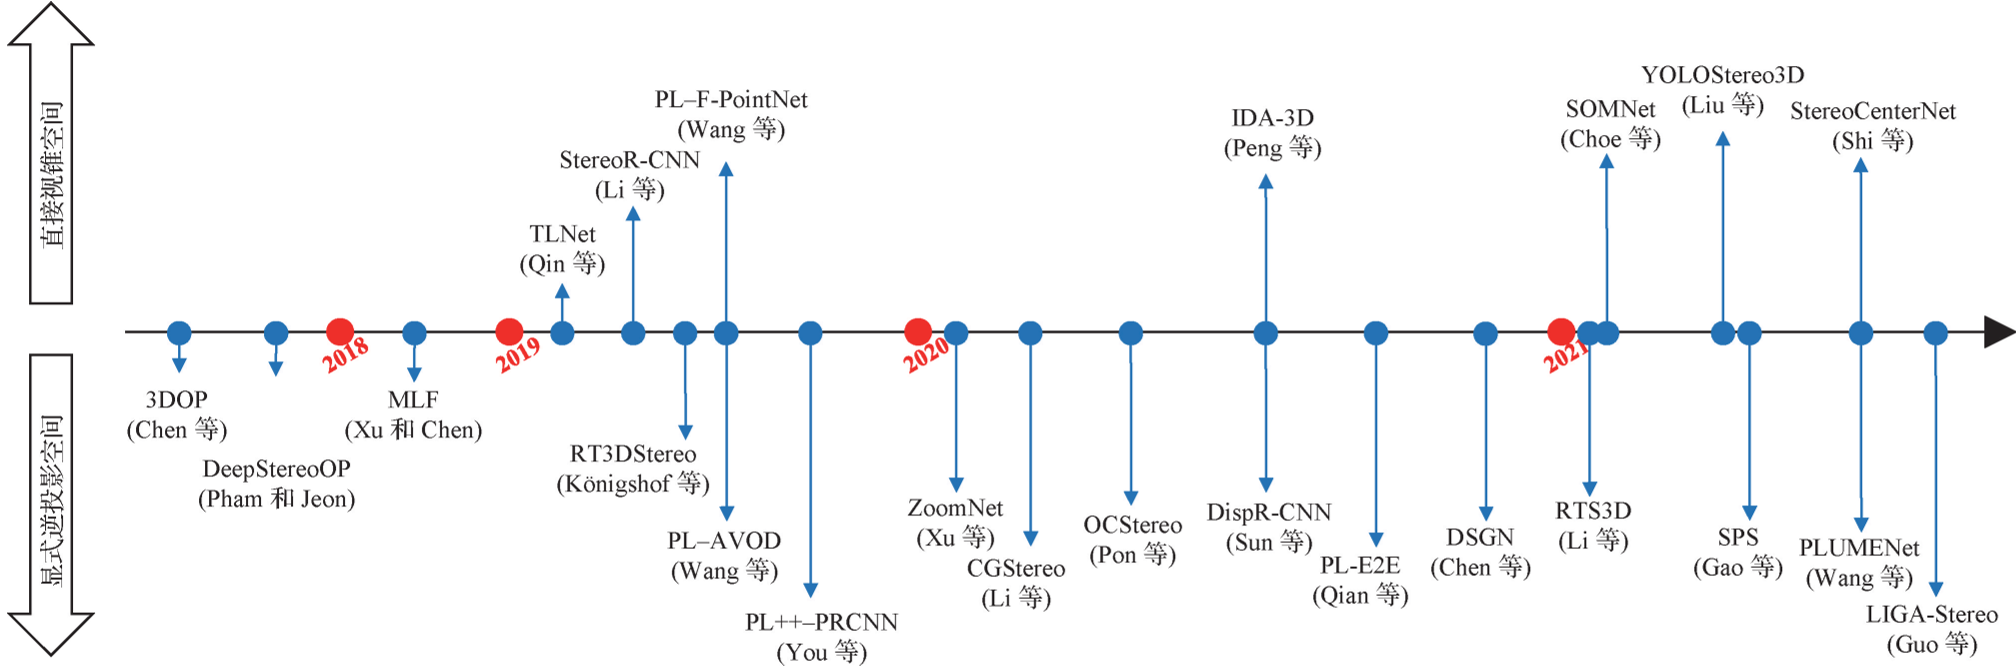 图 2:双目视觉目标检测方法的发展历程与效果对比
3. 核心洞察:为何标签分配(Label Assignment)如此重要?
论文特别提到,单阶段与多阶段检测器的性能差距,很多时候不在网络深度,而在标签分配策略(如 ATSS)。如何动态判定一个锚点框是正样本还是负样本,直接决定了损失函数的收敛效率。
4. 实验结果与行业趋势
在 KITTI 榜单上,基于显式逆投影(如 DSGN, LIGA-Stereo)的方法已显著提升了车辆类别的检测精度(AP)。未来的研究热点已转向:
- 自监督学习:如何不点注数万张图也能让模型理解物体边界?
- 零样本/小样本检测:面对自动驾驶中的冷门异形物,如何通过语义迁移实现零样本识别?
深度感悟:技术主编视角
视觉目标检测正在经历从“像素匹配”到“几何重构”的范式转移。虽然 Transformer 带来了端到端的优雅,但如何在大规模道路场景下保持计算资源与精度的平衡,依然是学术界需要深切关注的问题。
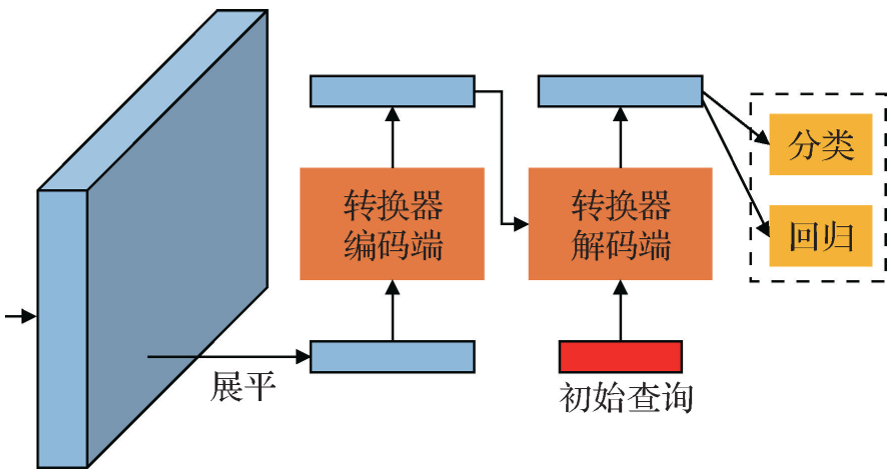 图 3:基于 Transformer 的 DETR 检测框架流程
调研清单(Research Queries)
- 高效 Transformer:研究 Deformable DETR 如何通过稀疏采样提升收敛速度。
- 伪雷达架构:探索 Pseudo-LiDAR 从 DispNet 到更高精度深度估计器的演进。
- 长尾分布处理:关注 LVIS 大规模数据集下,均衡损失函数对检测长尾类别的现实意义。
总结 (Takeaway):本文不仅是一份综述,更是视觉从 2D 观测向 3D 感知进发的战略地图。